


Python爬虫能获取哪些数据?网络数据采集的应用边界与合规性
深入解析Python爬虫能够采集的数据形态、技术实现路径,系统梳理网络数据采集的技术控制边界与法律合规红线,提供工程落地自检决策指南。
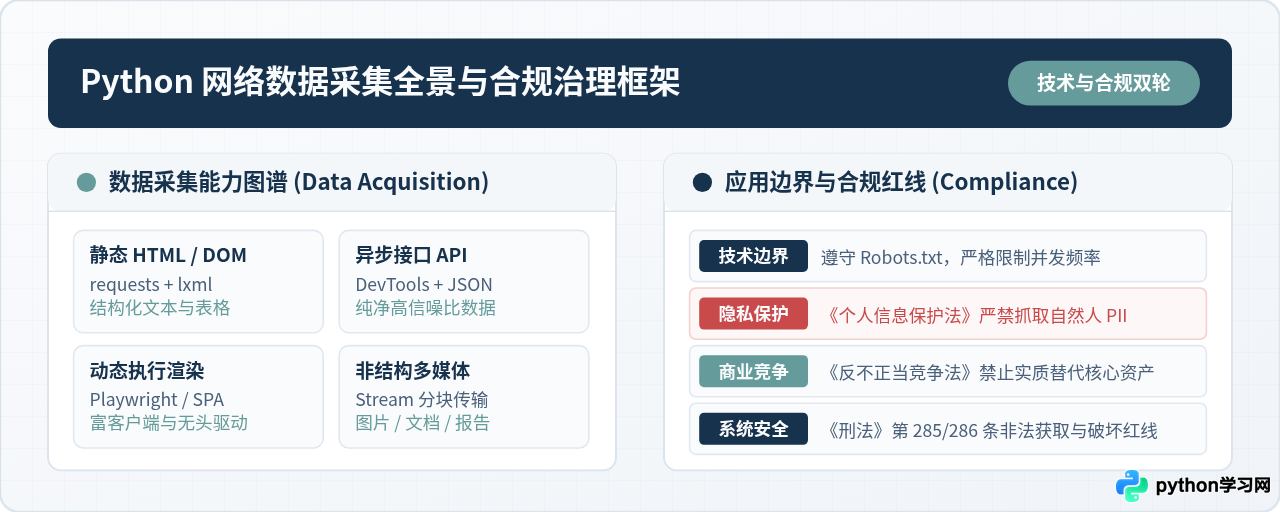
Python 爬虫在技术本质上是自动化模拟网络客户端向目标服务器发起请求、接收响应并按规则提取信息的程序。只要是网络通信中公开传输且未受加密私钥保护的文本、数据接口、富媒体文件,技术上均能被爬虫获取。但网络数据采集从不等于“技术能爬即可任意爬”:它严格受制于目标服务器的承载能力、技术防御协议,以及《个人信息保护法》《反不正当竞争法》《刑法》等法律法规的实体边界。本文将全面梳理 Python 爬虫所能采集的数据形态,详解标准采集工程的落地方案,并系统厘清技术边界与合规红线,帮助读者建立兼具技术可行性与法律合规性的开发认知。
一、爬虫技术能力:Python 能够获取哪些数据形态?
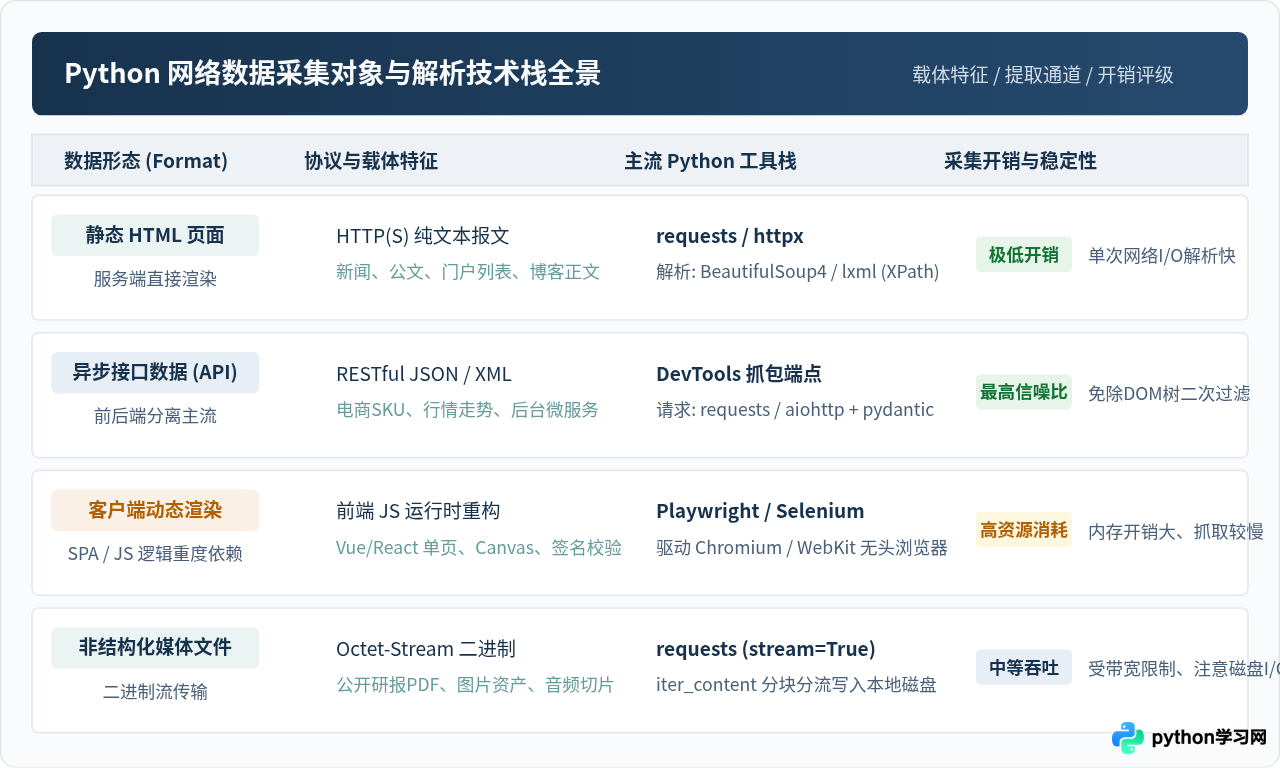
评估网络数据采集任务时,首要环节不是盲目编写代码,而是判断目标数据在网络协议栈中所处的载体形态。浏览器能够展示的一切内容,背后都是通过标准 HTTP/HTTPS 协议从服务器下载到本地的资源。根据数据传输格式与客户端渲染机制的不同,Python 爬虫能够捕获的数据形态主要划分为以下四类。
1. 静态 HTML 文档与结构化 DOM 节点
这是最传统也是开销最低的数据形态。对于采用服务端渲染(SSR)的网站(例如早期的门户新闻、政府公告公示、维基百科等),服务器在接收到 GET 请求后,直接将包含完整文字和表格的 HTML 代码返回给客户端。
在这类场景下,Python 可以直接使用 requests 或 httpx 发起网络请求,配合 BeautifulSoup4 或 lxml 的 XPath 语法定位 DOM 树标签,完成文本提取。此类采集无需启动无头浏览器,内存消耗通常在数十兆以内,单次请求吞吐可在毫秒级完成。
2. 前后端分离架构下的异步接口数据(JSON / XML)
现代 Web 应用绝大多数采用前后端分离架构。初次加载的 HTML 页面往往只是一个空壳骨架,真正的核心数据(如商品详情、股价走势、评论列表)均由前端 JavaScript 脚本通过 fetch 或 XMLHttpRequest (Ajax) 向后台 API 端点动态请求,返回标准的 JSON 或 XML 格式报文。
这是工业级数据采集效率最高、信噪比最佳的通道。开发者无需在杂乱的 HTML 标签中编写复杂的正则表达式或 XPath 选择器,只需在浏览器开发者工具(F12 -> Network)中捕获真实的 API 接口端点,直接构造 HTTP 请求获取纯净的 JSON 字典对象,并直接映射至 Python 字典或 Pydantic 数据模型。
3. 客户端动态渲染与富交互内容(SPA / Canvas)
部分重度依赖单页应用(SPA)框架(如 React、Vue)构建的平台,或者在前端设置了复杂的 JavaScript 动态反爬混淆计算(如前端加密生成防篡改签名 _signature 或 token)。如果直接抓取网络接口需要耗费巨大的时间去逆向混淆算法,此时技术上的可行兜底路径是无头浏览器自动化。
借助 Playwright 或 Selenium,Python 可以直接驱动无界面的 Chromium、Firefox 或 WebKit 浏览器内核,完整执行页面内的一切 JavaScript 脚本,等待 DOM 元素完全渲染或特定网络请求触发后,再获取最终的页面快照。这种方式能够获取几乎所有屏幕可见内容,但代价是极高的 CPU 和内存开销(单个浏览器实例常占用数百兆甚至数吉字节内存),采集吞吐量通常比纯 HTTP 请求低一个数量级。
4. 非结构化二进制多媒体资产(图片、文档、音视频流)
除了结构化文本,网络上的海量资产还表现为二进制多媒体。例如行业深度研究 PDF 报告、学术论文、高清图片资源、以及音视频分片(如 HLS 的 .m3u8 索引与 .ts 分片)。
在采集二进制文件时,不能一次性将文件载入内存,而应利用 requests.get(url, stream=True) 启用流式传输,结合 iter_content(chunk_size=8192) 分块边读边写,防止因下载大文件导致内存溢出(OOM)。
二、标准工程落地:数据采集的实施与验证四步法
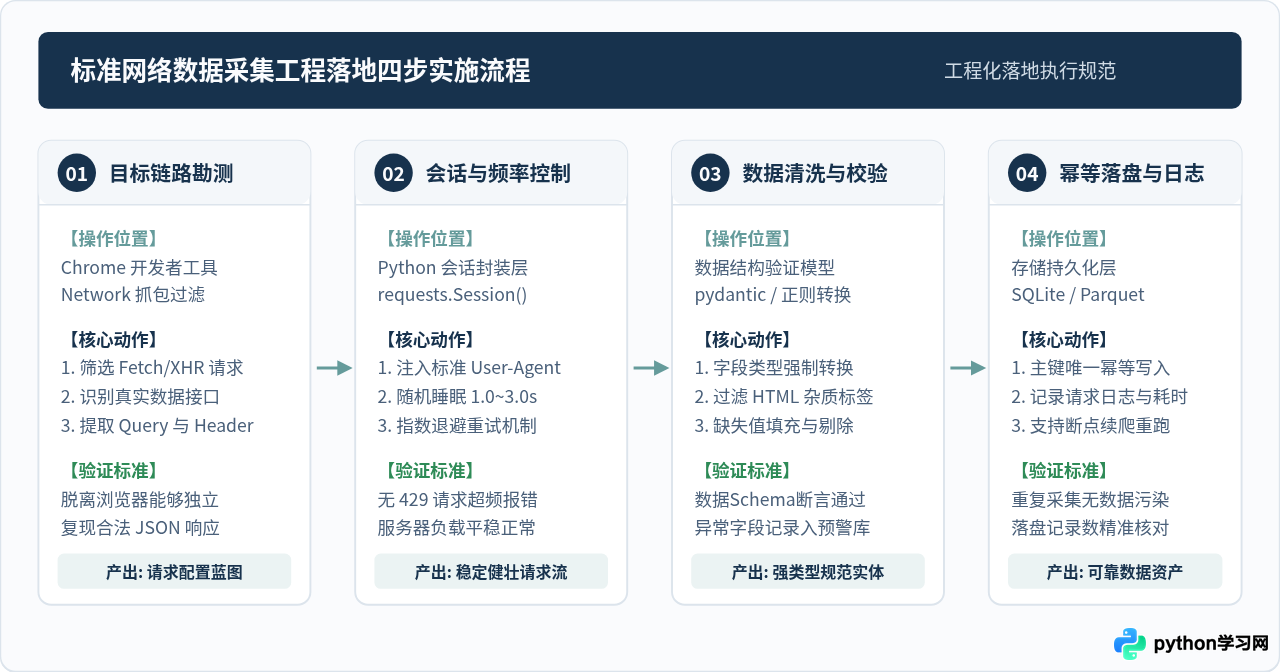
进行网络数据采集时,规范的工程流程不仅能够大幅提升采集效率,更是防范程序失控、避免向对方服务器施加突发压力的必要防线。一个合格的爬虫工程必须经过“链路勘测、会话控制、数据清洗、幂等持久化”四个阶段。
步骤 1:目标链路勘测与数据源定位
在编写任何请求代码之前,先打开 Chrome 或 Firefox 浏览器的开发者工具(F12),切换至 Network(网络) 面板。执行以下检查:
- 勾选 Preserve log(保留日志),并在过滤器中优先选择 Fetch/XHR。
- 在页面触发翻页、筛选或下拉动作,观察网络瀑布流中新增的网络请求。
- 检查请求响应的
Content-Type:若为application/json且包含目标字段,记录其 Request URL、请求方式(GET/POST)、Headers 中的必要鉴权参数以及 Query Parameters。
步骤 2:会话构建、请求头模拟与并发限速
为了保持网络连接复用并模拟正常的浏览器访问行为,必须使用 requests.Session() 管理连接池,并注入标准的 User-Agent、Accept 与 Referer 请求头。更重要的是,必须严格限制请求频率,绝不能使用无延时的死循环并发抓取。
# -*- coding: utf-8 -*-
"""
标准数据采集请求客户端示例
执行环境:Python 3.9+ 依赖 requests, urllib3
"""
import time
import random
import requests
from requests.adapters import HTTPAdapter
from urllib3.util import Retry

def create_safe_session() -> requests.Session:
    """构建具备重试退避与标准请求头的安全会话"""
    session = requests.Session()

    # 配置指数退避重试机制,防止偶发网络抖动导致任务崩溃
    retries = Retry(
        total=3,
        backoff_factor=1.0,
        status_forcelist=[500, 502, 503, 504],
        raise_on_status=False
    )
    adapter = HTTPAdapter(max_retries=retries, pool_connections=5, pool_maxsize=5)
    session.mount("https://", adapter)
    session.mount("http://", adapter)

    # 模拟真实浏览器请求头
    session.headers.update({
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/124.0.0.0 Safari/537.36",
        "Accept": "application/json, text/plain, */*",
        "Accept-Language": "zh-CN,zh;q=0.9,en;q=0.8",
        "Referer": "https://example.com/data-center"
    })
    return session

def fetch_data_safely(session: requests.Session, endpoint: str, page: int) -> dict:
    """执行带有随机节流的请求"""
    params = {"page": page, "page_size": 20}

    # 强制随机休眠 1.5 ~ 3.0 秒,严格遵守服务器友好原则
    sleep_interval = random.uniform(1.5, 3.0)
    time.sleep(sleep_interval)

    response = session.get(endpoint, params=params, timeout=10)

    if response.status_code == 200:
        return response.json()
    elif response.status_code == 429:
        # 命中限流保护,记录告警并延长退避时间
        raise RuntimeError(f"触发目标端限流 (HTTP 429),立即熔断采集流程。")
    else:
        response.raise_for_status()
        return {}
步骤 3:数据清洗与强类型 Schema 校验
采集回来的原始数据往往伴随数据脏污、格式漂移或空值情况。直接将原始 JSON 写入数据库会导致下游分析阶段频繁崩溃。推荐使用轻量级强类型模型(如 Python 的 dataclasses 或 pydantic)进行字段校验与清洗:
from dataclasses import dataclass
from typing import Optional
from datetime import datetime

@dataclass(frozen=True)
class ArticleItem:
    item_id: str
    title: str
    publish_date: str
    view_count: int
    source_url: str

def parse_and_validate(raw_item: dict) -> Optional[ArticleItem]:
    """清洗单条原始字典并转换为强类型实体"""
    try:
        # 字段清洗与空值剔除
        item_id = str(raw_item.get("id", "")).strip()
        title = str(raw_item.get("title", "")).strip()
        if not item_id or not title:
            return None

        # 数值规范化转换
        raw_views = raw_item.get("views", 0)
        view_count = int(raw_views) if str(raw_views).isdigit() else 0

        return ArticleItem(
            item_id=item_id,
            title=title,
            publish_date=str(raw_item.get("pub_time", "")).strip(),
            view_count=view_count,
            source_url=str(raw_item.get("url", "")).strip()
        )
    except (ValueError, TypeError) as exc:
        # 记录清洗异常日志,不中断主流程
        return None
步骤 4:幂等持久化与执行审计日志
采集任务可能因为网络抖动、主机断电或目标更新而发生中断。存储设计必须具备幂等性(Idempotency),即重复运行不会生成冗余脏数据。
- 对于关系型存储(如 SQLite / PostgreSQL),必须为目标主键(如
item_id)建立UNIQUE约束,并使用INSERT OR IGNORE或ON CONFLICT ... DO UPDATE语句。 - 建立采集运行流水日志,详细记录每次批处理的启动时间、耗时、请求总量、成功数、空值数与网络状态码。
三、技术应用边界:遇到哪些限制不应强行突破?
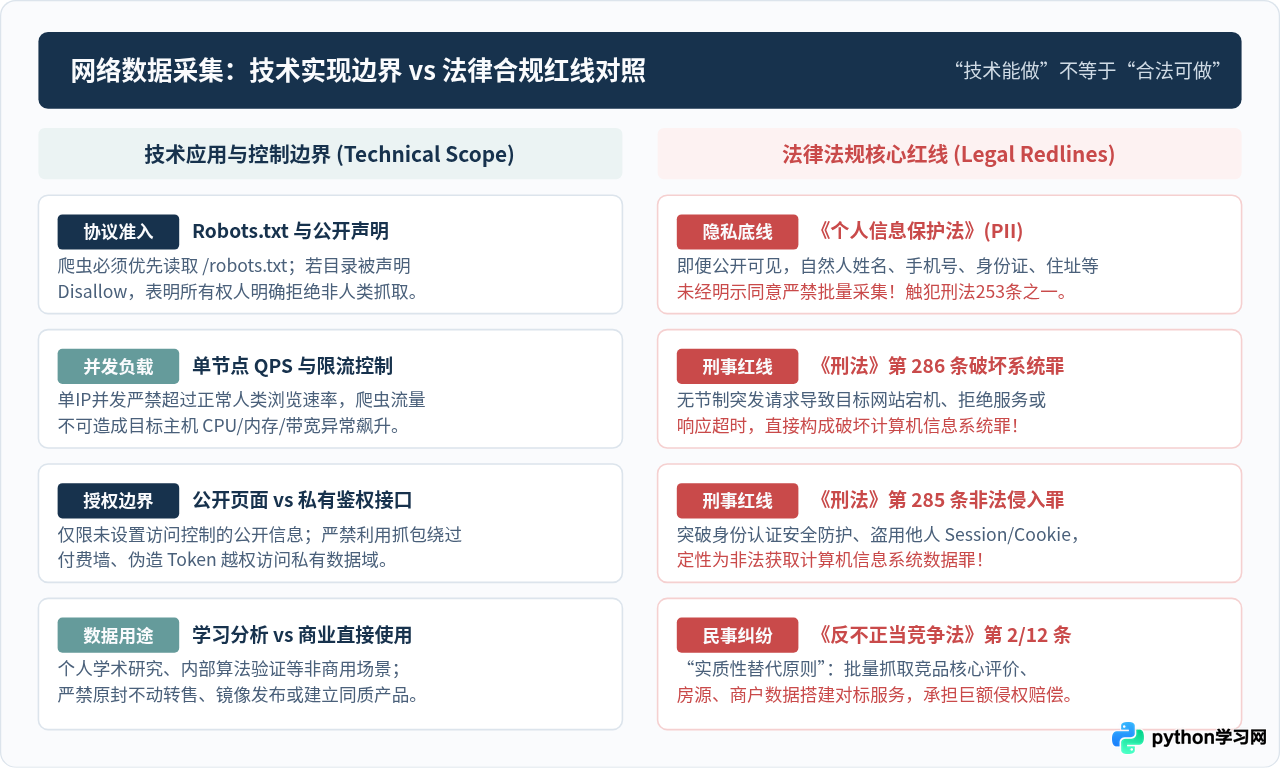
在技术人员的视角中,几乎所有的客户端反爬措施(如字体加密、JS 动态签名、滑动拼图验证码、IP 限制)都能通过逆向分析、动态仿真或引入第三方打码服务来绕过。然而,“技术上有能力突破”与“工程上允许突破”是两套完全不同的逻辑。在工程实践中,必须严格恪守以下四道技术应用边界:
1. 协议准入边界:Robots.txt 协议的效力
每个规范的网站根目录下通常包含 robots.txt 文件(如 https://example.com/robots.txt),该文件基于“网络爬虫排除协议(Robots Exclusion Protocol)”向搜索引擎和自动化脚本声明允许抓取与禁止访问的路径。
虽然纯粹的 Robots 协议在法律上多被视为行业自治公约,但在我国司法实践中,Robots 协议是判定数据所有权人主观意愿的重要依据。若目标网站在 robots.txt 中明确通过 Disallow: /api/ 拒绝抓取,而爬虫开发者依然强制绕过该指令批量抓取对应数据,法院极易认定采集方具备明显的“主观恶意”,在不正当竞争纠纷中处于极其被动的劣势。
2. 服务器负载边界:高频并发与拒绝服务(DoS)
爬虫程序可以在几秒钟内发出成千上万次请求。如果开发人员不设限制地使用数十个异步协程或分布式节点疯狂请求,目标服务器的带宽、连接池、数据库 CPU 将在极短时间内被打满,导致真实用户的正常访问被拒绝甚至服务器宕机。
在法律层面上,因编写缺陷或故意高并发导致目标计算机系统无法正常运行、造成经济损失的,直接触犯《中华人民共和国刑法》第二百八十六条规定的破坏计算机信息系统罪。因此,单节点采集必须将并发限制在极低水平(常规公开网站建议低于 2~5 次/秒),并在夜间业务低谷时段调度运行。
3. 身份与凭证边界:公开未授权与私有鉴权接口
网络数据采集的合法客体严格局限于“无需身份凭据即可在公开互联网浏览的信息”。如果目标数据隐藏在登录保护、付费墙之后,或者该接口需要特定的用户鉴权 Session、JWT Token 才能读取:
- 通过撞库、爆破、盗用他人账号凭证获取数据的;
- 通过抓包逆向越权调用未对公众开放的私有后台微服务接口的;
此类行为已完全脱离了正常网络爬虫的范畴,属于典型的未授权非法侵入计算机系统。
4. 逆向对抗边界:打码平台与实质性安全防护
网站为了防御自动化脚本,会引入诸如极验、Cloudflare Turnstile 等滑动验证码、点选验证码或生物轨迹分析机制。这些防护属于《网络安全法》认可的实质性技术防护措施。
如果通过外挂、接入黑灰产打码平台(通过人工打码众包或破解算法绕过验证码),在司法审查中将被直接认定为“采用非法手段突破安全技术防护”,极易构成非法获取计算机信息系统数据罪。
四、法律合规红线:网络数据采集的三大核心基石
网络爬虫本身作为一种自动化数据检索技术,中立且合法。但在具体使用过程中,所抓取的数据内容、采用的技术手段以及采集后的使用目的,必须严格契合我国现行的法律法规框架。
1. 《个人信息保护法》:绝对不可逾越的隐私底线
《中华人民共和国个人信息保护法》(PII)规定,个人信息是以电子或者其他方式记录的与已识别或者可识别的自然人有关的各种信息(包括但不限于姓名、出生日期、身份证件号码、生物识别信息、住址、电话号码、电子邮箱、健康生理信息、行踪轨迹等)。
很多初学者存在严重误区:“既然这些手机号、个人简历在招聘网站或社交平台上公开挂着,我用爬虫抓下来是不是就合法?”答案是坚决否定的!公开个人信息不等于自然人放弃了其人格权。未经自然人明示同意,大批量爬取、聚合、清洗、加工并存储个人隐私数据,甚至向第三方出售,直接触犯《刑法》第二百五十三条之一规定的侵犯公民个人信息罪,面临三年以上七年以下有期徒刑。
2. 《反不正当竞争法》:商业数据权属与实质性替代原则
在商业竞争场景中,即便目标数据不涉及个人隐私(例如电商平台的商品价格库、餐饮商户的真实点评、房产平台的精细房源信息),这些数据也是原平台投入了数千万甚至上亿元的服务器成本、运营成本与商务推广成本所沉淀下的核心商业数据资产。
根据《反不正当竞争法》第二条(一般条款)和第十二条(互联网专条),司法裁判遵循“实质性替代原则”与“非公益性搭便车判定”:
- 如果 A 公司通过爬虫批量抓取 B 公司的评价数据或房源信息,直接用于填充自身的新产品,或者打包为商业 API 向下游客户收费销售;
- 导致原本属于 B 公司的用户流量、点击率与潜在交易被分流转移;
司法机关将认定该行为破坏了公平的市场竞争秩序,构成不正当竞争,采集方将面临停止侵权、消除影响并赔偿巨额经济损失的民事责任。
3. 《刑法》第 285 与 286 条:系统安全与服务稳定
在刑法领域,涉及爬虫案件的两大约束罪名是:
| 罪名条款 | 核心构成要件 | 爬虫开发常见高危触碰场景 |
|---|---|---|
| 第285条 非法获取计算机信息系统数据罪 | 违反国家规定,侵入计算机信息系统或者采用其他技术手段,获取该计算机信息系统中存储、处理或者传输的数据。 | 伪造 Token、盗用他人 Session、破解加密签名接口、绕过付费壁垒抓取未公开接口。 |
| 第286条 破坏计算机信息系统罪 | 违反国家规定,对计算机信息系统功能进行删除、修改、增加、干扰,造成计算机信息系统不能正常运行,后果严重。 | 多线程高频爬取打满对方带宽、打垮数据库,导致正常业务中断或网站宕机。 |
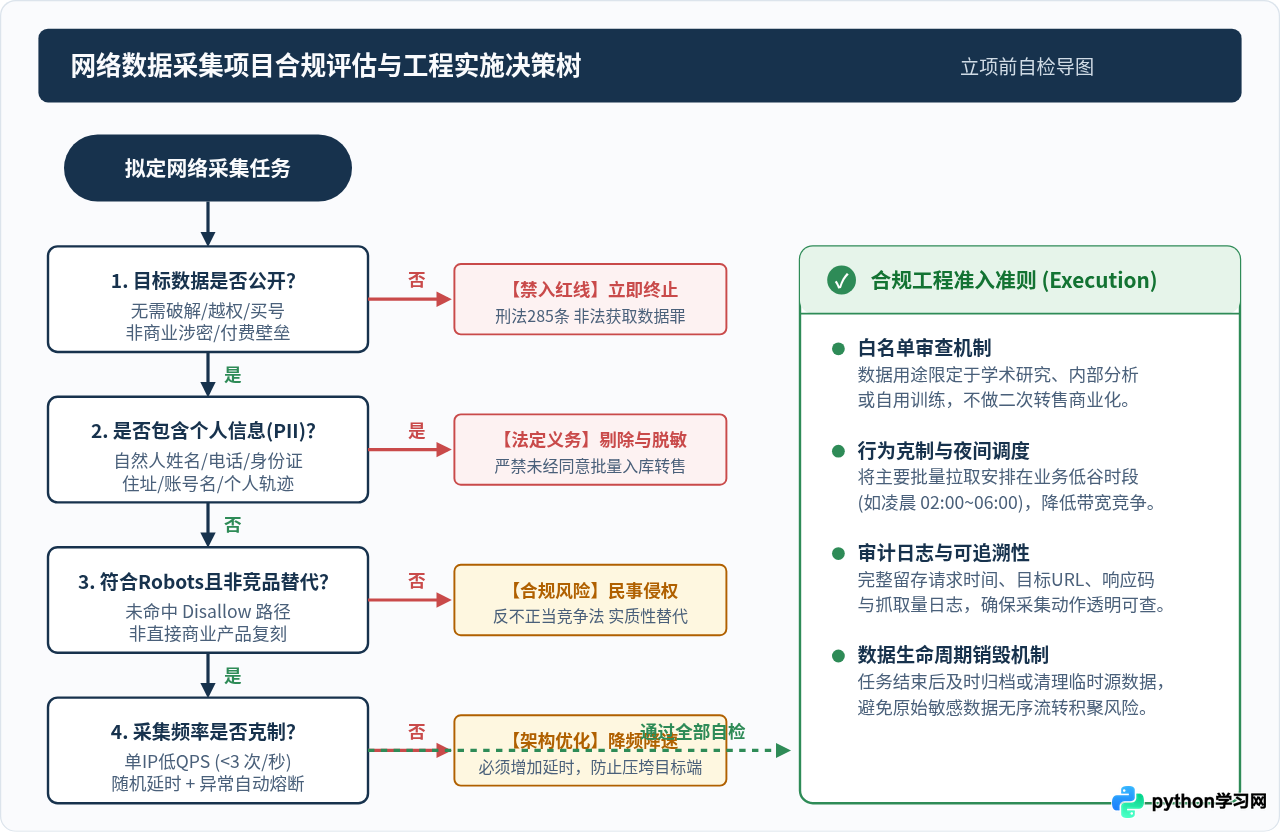
五、工程落地自检指南:网络数据采集决策自检树
为确保企业与开发者在启动任何数据采集项目时做到合规自查,技术团队在编写代码前应当严格执行以下“合规四步自检流程”。
自检落地的四个核心准则
- 客体合法:审查数据源属性。优先判断目标数据是否具备公开性。严禁涉及国家机密、商业核心机密、国防涉密及付费私有数据。遇到自然人 PII(姓名、电话、身份证、微信号等),必须在采集前进行技术层面的过滤与强脱敏,不做批量持久化入库。
-
意愿尊重:核查授权与协议。主动解析网站的
robots.txt,核实目标抓取路径是否在允许清单中;查阅网站服务条款(Terms of Service),若平台有明确的 API 开放接口,应优先申请正规开放平台 Key。 - 手段克制:实施文明低频调度。在工程代码中强制约束单 IP 请求速率(建议小于 2~3 QPS),必须注入随机延时;采集任务尽量调度在夜间业务低谷期(02:00 ~ 06:00);设置异常熔断机制,一旦连续出现 HTTP 429、500 等异常,立即自动停止采集任务,杜绝拖垮对方服务。
- 用途合规:限定使用边界与生命周期。明确采集数据仅供个人学术研究、内部算法验证或数据分析,严禁将采集数据未经实质性加工即打包转售或搭建同质化竞争产品。建立数据销毁机制,临时分析完成后及时归档销毁源数据,避免数据积聚带来的安全隐患。
总结
Python 爬虫是网络互联时代极其高效的数据获取与分析生产力工具。从技术维度来看,凡是公开通信通道中呈现的数据形态,爬虫都可以借助 Python 丰富的生态库予以解析和提取。然而,技术可行性永远不能凌驾于法律合规与伦理底线之上。
一名优秀的软件工程师在编写网络数据采集代码时,不仅要有熟练定位接口、清洗数据的技术功底,更应具备清晰的合规敏感度。坚持“来源公开、手段克制、用途合规”这十二字原则,才能确保数据采集工程在安全、合法的航道上发挥真正的商业与研究价值。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















