


Python支持哪些数据导入格式?CSV、Excel、JSON等常用类型盘点
全面盘点Python支持的常用数据导入格式,包括CSV、Excel、JSON、SQL数据库、Parquet与XML等,提供内置模块与Pandas库的导入示例、适用场景对比及常见排错指南。
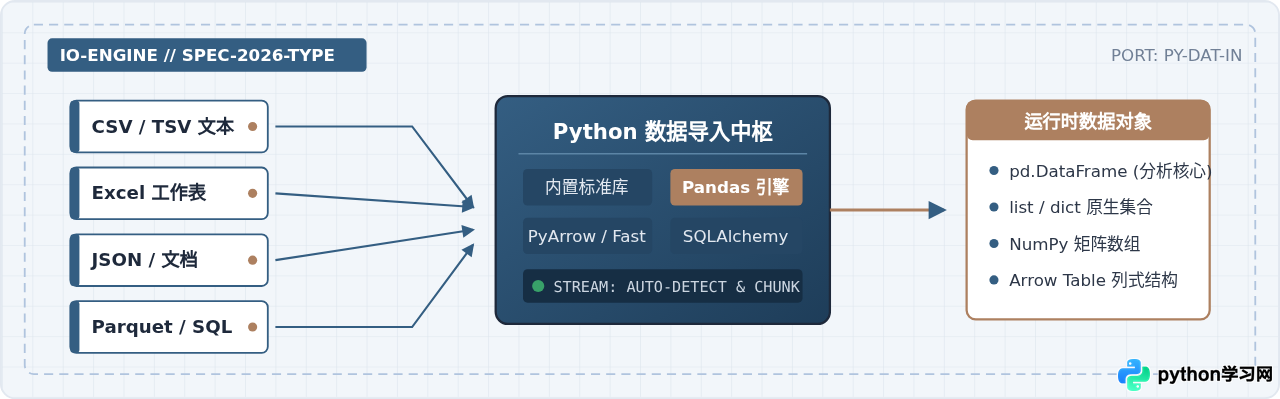
Python凭借其标准库内置模块与庞大的第三方计算生态,几乎能够导入现代计算机软件世界中所有常见的数据存储格式。在实际开发和数据分析场景中,绝大部分输入数据都可以归结为纯文本定界表格(如CSV/TSV)、电子报表(如Excel)、轻量半结构化文档(如JSON/XML)、高性能列式存储(如Parquet/Feather)以及关系型数据库查询结果(SQL)。本文直接梳理这些主流格式的读取方案、标准示例、适用边界以及工程排错要点,帮助读者在面对不同数据源时建立清晰的选型标准与实现路径。
一、Python数据导入格式分类全景
评估一种数据格式能否在Python中高效导入,通常需要衡量四个维度:人工可读性、解析效率与内存占用、数据模式(Schema)保留能力,以及跨系统通用性。根据底层组织形式,Python支持的数据输入格式可以划分为四大层级体系。
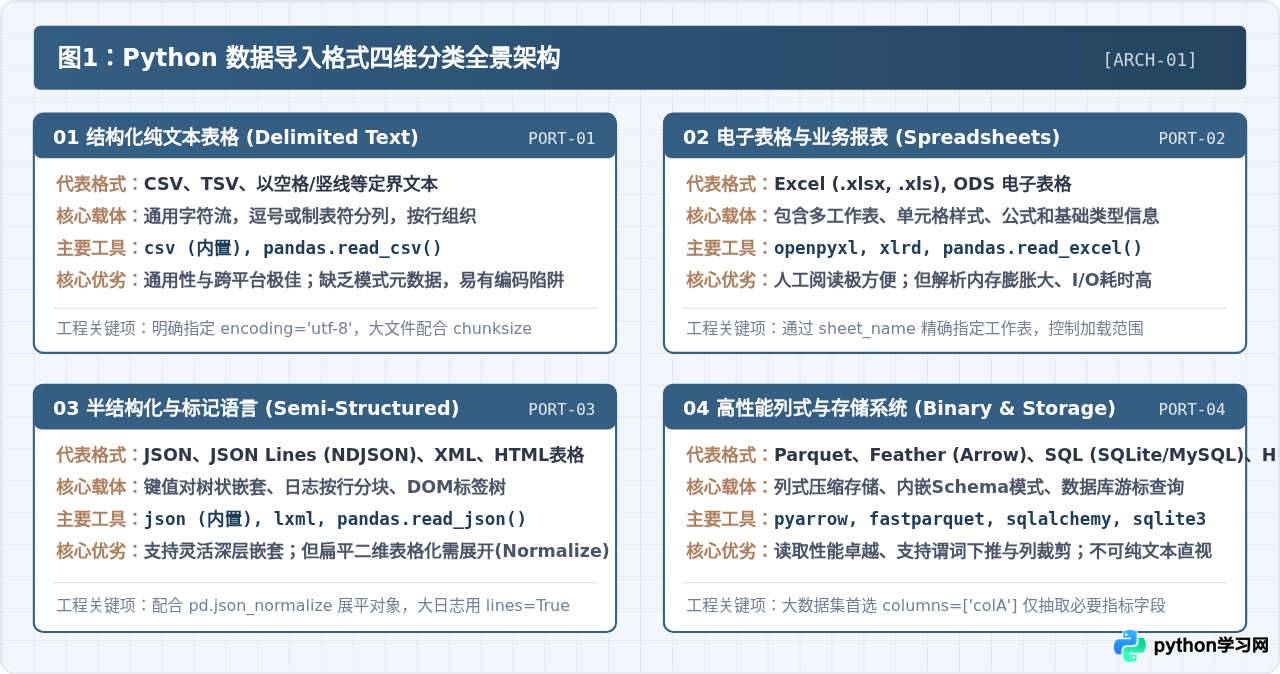
纯文本定界格式兼容性最高,但丢失了严格的类型信息;电子表格适合人机协作但体积膨胀明显;JSON具备树形嵌套灵活性但在转为二维表时开销较大;列式二进制文件(Parquet等)则专为大规模分析而生,兼顾存储压缩与按列投影性能。理解这一全景架构,是选择导入工具的前提。
二、常用格式读取实践与完整代码示例
1. CSV 与 TSV:轻量通用的纯文本表格
CSV(逗号分隔值)和TSV(制表符分隔值)是跨平台数据交换中使用最广泛的格式。Python既可以通过内置的 csv 模块进行轻量解析,也可以借助 pandas.read_csv() 直接生成数据帧。
对于简单脚本或无外部依赖环境,优先使用内置 csv 模块:
# 示例:使用 Python 内置 csv 模块读取
import csv

file_path = "orders_data.csv"
orders = []

with open(file_path, mode="r", encoding="utf-8") as f:
    reader = csv.DictReader(f)
    for row in reader:
        orders.append(row)

# 示例输出:[{'order_id': '1001', 'amount': '250.0', 'status': 'PAID'}]
print(f"成功读取 {len(orders)} 条记录,首条数据: {orders[0] if orders else 'None'}")
在数据分析与清洗场景中,通常使用 pandas.read_csv()。该函数支持定界符自动嗅探、缺失值识别与多线程解析:
# 示例:使用 Pandas 高效读取并指定核心参数
import pandas as pd

df_csv = pd.read_csv(
    "orders_data.csv",
    sep=",",                  # 定界符,TSV可设为 '	'
    encoding="utf-8",        # 字符编码,Windows文件若乱码可尝试 'gb18030'
    usecols=["order_id", "amount", "order_date"], # 仅加载必要列
    parse_dates=["order_date"], # 自动解析日期类型
    na_values=["NULL", "N/A", ""]  # 统一缺失值标识
)
print(df_csv.head(2))UnicodeDecodeError,切忌盲目忽略错误,应将编码明确设为 encoding="utf-8-sig" 或 encoding="gb18030"。此外,若字段内含有未加引号的逗号导致列错位,需使用 quotechar='"' 或改用 engine='python' 配合容错参数。
2. Excel 工作簿 (.xlsx / .xls):业务协同首选
Excel文件通常由业务人员维护,包含多工作表(Sheet)、富文本与公式。Python读取现代 .xlsx 文件主要依赖底层的 openpyxl 引擎,旧版 .xls 则需配合 xlrd(注意 xlrd 2.0+ 已不再支持 xlsx)。
# 示例:读取 Excel 指定工作表并跳过非数据行
import pandas as pd

excel_path = "finance_report_2026.xlsx"

# 方案A:读取单一工作表
df_sheet = pd.read_excel(
    excel_path,
    sheet_name="Q1_Summary",  # 也可传整数索引如 sheet_name=0
    header=1,                  # 若第1行为说明,指定第2行(索引1)为表头
    engine="openpyxl"
)

# 方案B:批量读取全部工作表为字典
all_sheets = pd.read_excel(excel_path, sheet_name=None, engine="openpyxl")
for sheet, data in all_sheets.items():
    print(f"Sheet [{sheet}] 包含记录数: {len(data)}")
3. JSON 与 JSON Lines:半结构化与接口数据
JSON是Web API交互与无模式配置的标准。当JSON具有深层嵌套对象时,直接读取为表格可能导致字典被整体作为单元格。此时应使用 json.load 配合 pd.json_normalize 进行展平。
# 示例:解析嵌套 JSON 并展开子字段
import json
import pandas as pd

json_str = '''[
  {"id": 101, "user": {"name": "Alice", "city": "Beijing"}, "tags": ["vip", "active"]},
  {"id": 102, "user": {"name": "Bob", "city": "Shanghai"}, "tags": ["trial"]}
]'''

raw_data = json.loads(json_str)

# 将 user.name 等级联属性展平为平面列
df_flattened = pd.json_normalize(
    raw_data,
    record_path=None,
    meta=["id"],
    sep="_"
)
print(df_flattened)
# 输出包含列: id, tags, user_name, user_city
针对海量日志数据,每行一个独立JSON对象的 NDJSON/JSON Lines 格式更加普及。此时使用 pd.read_json("log.jsonl", lines=True) 可以避免一次性将整个庞大树状文档解析至内存。
4. 关系型数据库(SQL):生产环境核心数据接入
直接从数据库中导入数据是后端服务与分析管道的基本操作。通过 SQLAlchemy 建立连接池,结合 pandas.read_sql() 或内置 sqlite3,可直接将SQL查询结果无缝映射为DataFrame。
# 示例:通过 SQLAlchemy 引擎安全执行参数化查询
import sqlite3
import pandas as pd
from sqlalchemy import create_engine, text

# 创建示例内存 SQLite 连接
engine = create_engine("sqlite:///:memory:")

# 初始化演示表
with engine.connect() as conn:
    conn.execute(text("CREATE TABLE inventory (sku TEXT, stock INT, updated_at DATE)"))
    conn.execute(text("INSERT INTO inventory VALUES ('A100', 50, '2026-03-01'), ('B200', 0, '2026-03-02')"))
    conn.commit()

# 结构化带参导入,规避 SQL 注入
sql_query = text("SELECT sku, stock FROM inventory WHERE stock > :min_stock")
df_sql = pd.read_sql(sql_query, con=engine, params={"min_stock": 0})
print(df_sql)
5. Parquet 与 Feather:大数据分析的高性能列式存储
当单表规模超过百兆甚至千万行时,文本格式的I/O损耗将极为严重。Parquet作为分析型数据库的标准文件格式,具备列式存储、内嵌元数据和强压缩特性。读取时只需加载目标列,极大降低I/O开销。
# 示例:使用 pyarrow 引擎快速导入 Parquet 数据
import pandas as pd

parquet_file = "telemetry_2026.parquet"

# 核心优势:投影下推(Projection Pushdown),仅加载指定两列
df_parquet = pd.read_parquet(
    parquet_file,
    engine="pyarrow",
    columns=["device_id", "metric_value"]  # 避免读入全量百列
)
print(f"内存中占用: {df_parquet.memory_usage().sum() / 1024**2:.2f} MB")
6. XML、HTML 与科学二进制格式(HDF5 / Pickle)
- XML 与 HTML:网页结构化表格可直接通过
pd.read_html("https://example.com/table.html")自动抓取全部<table>标签;专用XML文档则使用内置模块xml.etree.ElementTree或第三方库lxml按照XPath路径提取节点。 - HDF5 (Hierarchical Data Format):通过
h5py或pd.read_hdf()处理高维矩阵与科学计算传感器序列,支持按切片部分加载。 - Pickle (.pkl):Python专用的全对象序列化工具,通过
pickle.load(f)可以100%还原Python内部对象类型。安全提醒:绝对不要读取不可信来源的Pickle文件,因其在反序列化时允许执行任意Python代码。
三、数据导入标准化执行步骤与排错机制
在工程化项目中,不加防御地直接调用读取函数往往会导致内存崩溃或静默数据损坏。建议遵循标准化的五步导入流水线:
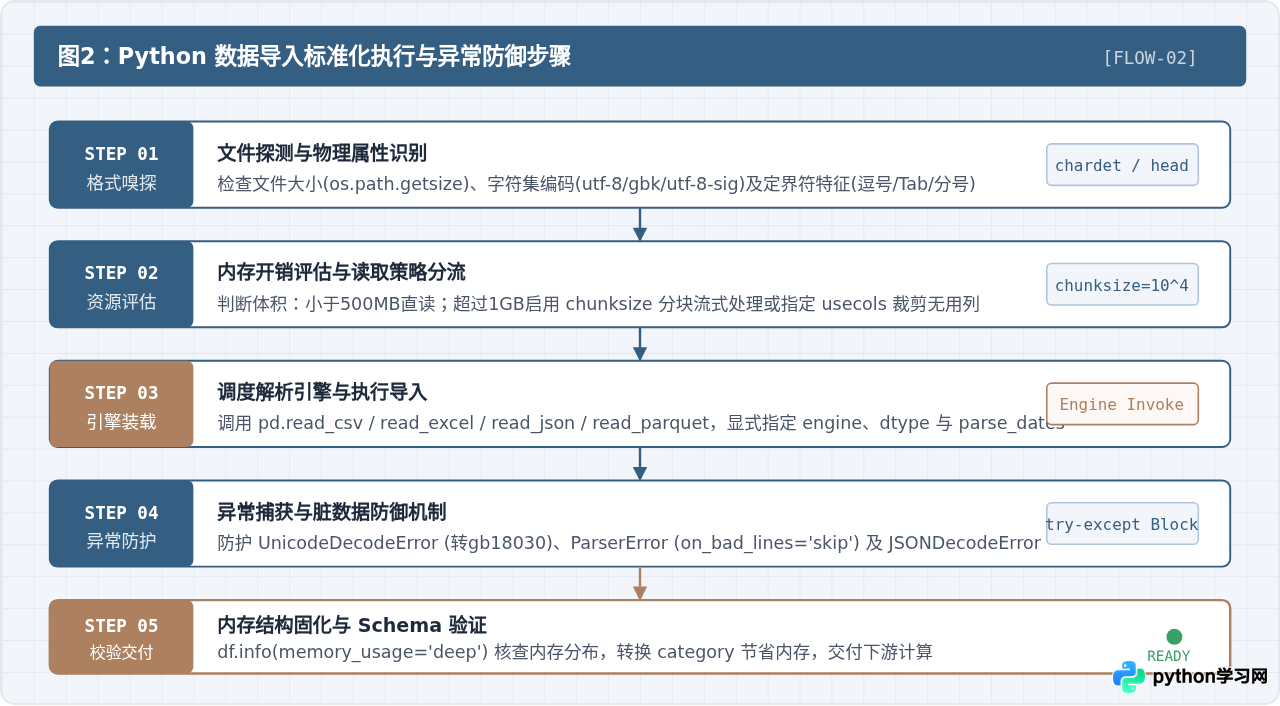
针对超大文件(如5GB以上的CSV),切勿一次性 read_csv。可通过 chunksize 参数实现流式批处理:
# 示例:大文件分块流式读取与聚合
import pandas as pd

total_valid_rows = 0
chunk_size = 50000  # 每次仅载入5万行进内存

for chunk in pd.read_csv("large_clickstream.csv", chunksize=chunk_size):
    # 过滤清洗并实时计算
    filtered = chunk[chunk["is_valid"] == 1]
    total_valid_rows += len(filtered)

print(f"流式统计完成,有效总行数: {total_valid_rows}")
四、核心格式技术特性与资源开销对比
为了帮助开发者根据硬件条件和系统要求做出合理权衡,图3汇总了五大主流格式在读取吞吐、空间占用及类型保留上的指标表现:
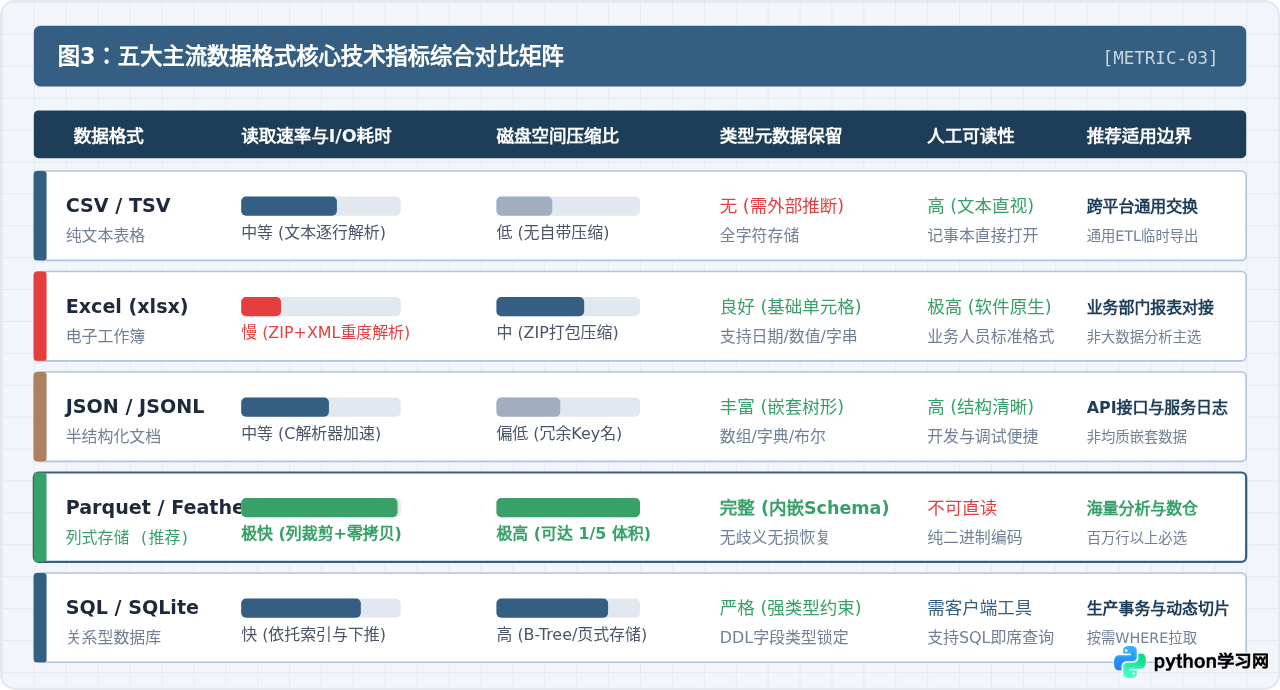
以下为各格式在典型生产场景下的工程属性速查表:
| 格式类型 | 典型扩展名 | 主要推荐库 | 模式(Schema)支持 | 内存/解析速度 | 典型应用场景 |
|---|---|---|---|---|---|
| CSV / TSV | .csv, .tsv | csv (内置), pandas | 弱 (文本字符推断) | 中等 | 系统通用数据导出、第三方ETL中转 |
| Excel | .xlsx, .xls | openpyxl, pandas | 中 (单元格内置类型) | 较慢 (高内存消耗) | 业务汇报、财务审计、人工复核 |
| JSON / NDJSON | .json, .jsonl | json (内置), pandas | 灵活 (动态嵌套对象) | 中等 | Web微服务接口、NoSQL导出、日志流水 |
| Parquet | .parquet | pyarrow, fastparquet | 强 (内嵌严格模式) | 极快 (列式压缩与裁剪) | 数据湖、特征工程、海量离线计算 |
| SQL 查询 | - | SQLAlchemy, sqlite3 | 强 (DDL约束) | 快 (计算下推与索引) | 生产事务数据库直连、局部条件切片 |
五、综合选型决策指南与落地建议
在设计系统输入模块时,应结合数据产生方、数据体量及下游计算需求选择格式。盲目选择CSV会带来频繁的类型隐式转换开销,而过度使用Excel则容易造成计算节点内存耗尽。
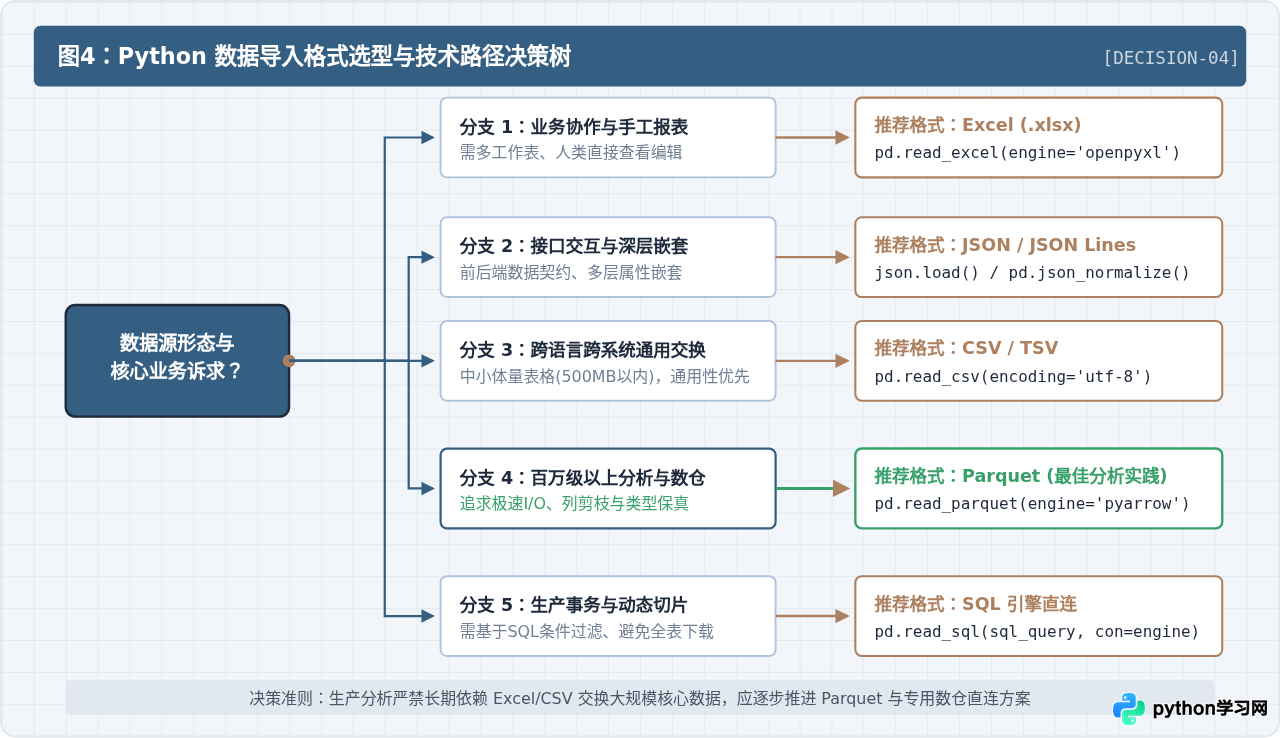
落地实施时,可牢记以下三项具体准则:
- 业务交互与自动化边界明确:面向非技术业务同事交付的输入模板使用 Excel;而在脚本或系统之间自动化流转时,统一转为 CSV 或 Parquet,避免在服务器中运行昂贵的
openpyxl引擎。 - 体积与速度拐点选择:数据量一旦突破 10 万行或文件大于 100MB,应优先评估转换为 Parquet 存储。相比 CSV,Parquet 不仅体积可缩减 60%~80%,读取耗时更可降低至原先的 1/5 以下。
- 防御性编码兜底:外部输入的纯文本与JSON必须包裹在
try-except结构中,对UnicodeDecodeError和ParserError做降级捕获,严禁因个别异常行中断整体计算任务。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















