


Python bytes与bytearray序列类型的使用场景解析
深入解析Python中bytes与bytearray序列类型的核心区别、底层内存模型、性能特征与工程选型依据。结合网络I/O、协议封包、密码学与文件处理等具体场景,指导开发者写出高效稳定的二进制处理代码。
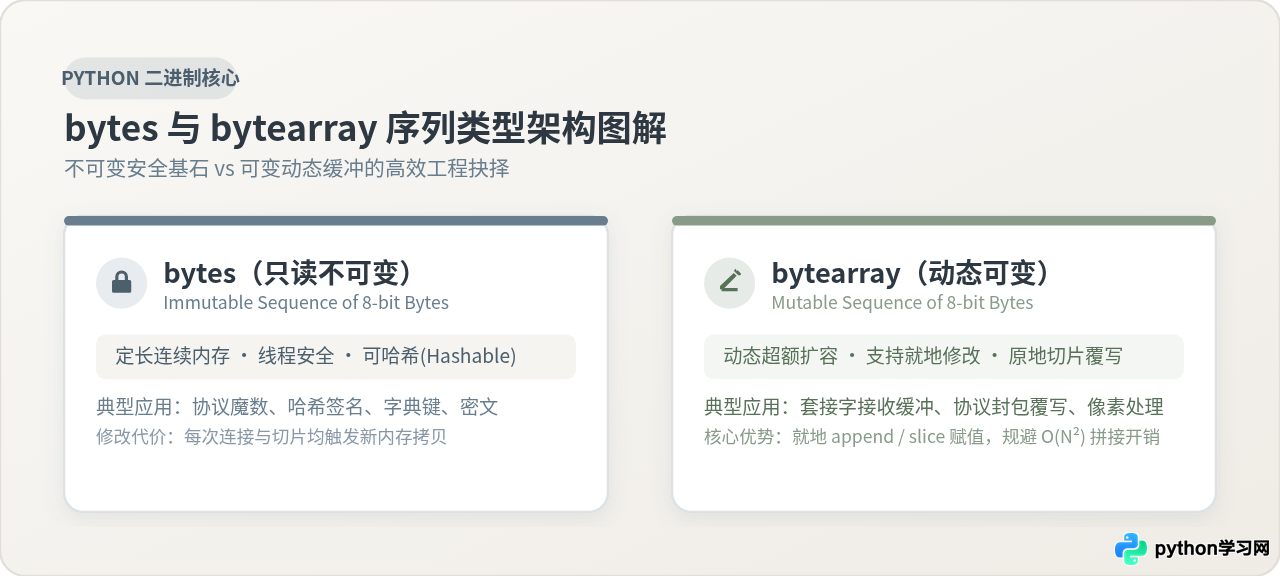
bytes 与 bytearray 是处理纯粹二进制数据(0 至 255 的 8 位字节序列)的两个内置核心类型。二者最关键的本质差异在于不可变性(Immutability):bytes 一旦创建即不可更改且支持哈希,而 bytearray 允许就地修改、动态扩容与原地切片覆写。选用哪一种类型,直接决定了程序在网络 I/O、协议封包、多线程交互及大内存操作时的性能表现与安全性。本文将从底层内存机制切入,系统解析两种类型的适用场景与实战准则。
一、核心机制与底层内存模型差异
为了在实际开发中做出正确的类型选型,首先需要理解两者在 CPython 底层实现上的根本差异。虽然它们都表示单字节整数的连续序列,但在内存分配与对象头设计上存在明显的权衡。
-
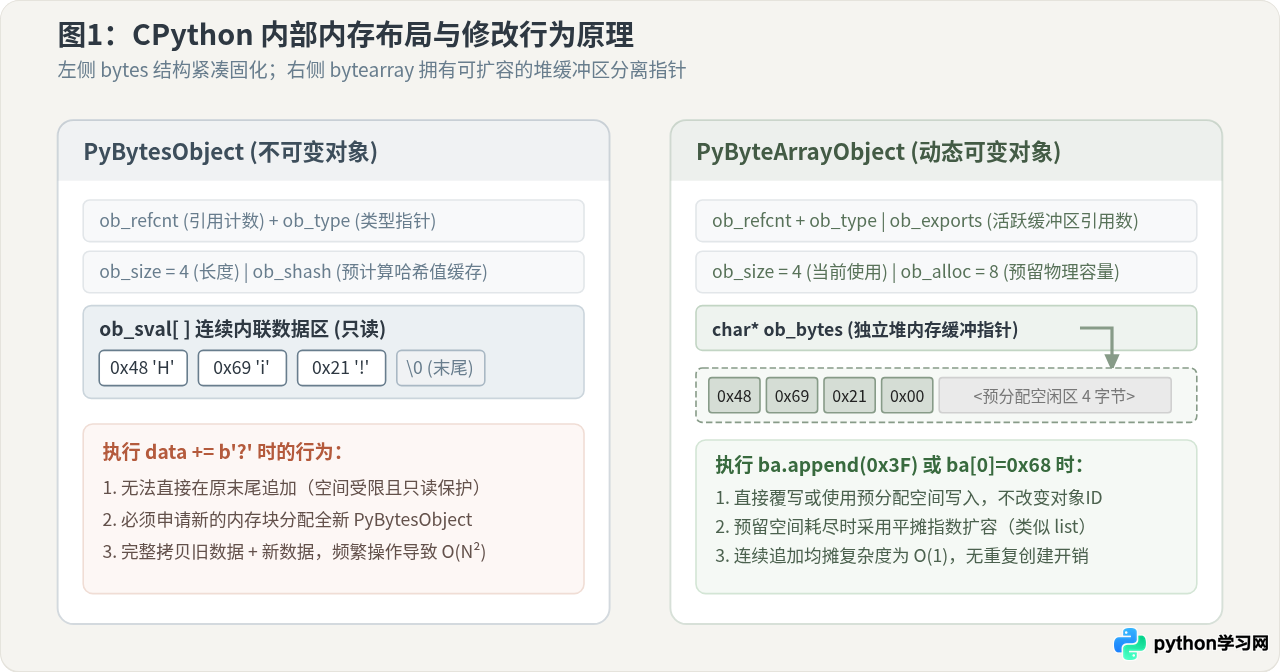
bytes(紧凑型内联存储):底层由
PyBytesObject实现。对象头记录了引用计数、类型指针以及预计算的哈希值(ob_shash)。紧随其后的是连续固定的字节数组缓冲区。由于其不可变性,创建完成后长度与内容彻底固化。对bytes执行拼接(如+=)或切片操作时,Python 必须开辟一段全新的内存空间并将旧数据完整拷贝过去,这在频繁操作的循环中会退化为 $O(N^2)$ 的时间复杂度。 -
bytearray(分离式动态堆缓冲):底层由
PyByteArrayObject实现。对象内部维护一个指向独立堆内存区域的指针ob_bytes、当前逻辑长度ob_size以及预分配容量ob_alloc。这种结构与 Python 的list非常相似,采用了超额分配(Over-allocation)策略。当在尾部追加字节或就地修改指定索引的值时,操作直接在现有堆内存上进行,平摊时间复杂度仅为 $O(1)$,完全避免了频繁销毁与创建对象带来的内存碎片与垃圾回收停顿。
二、bytes 的典型使用场景与设计考量
不可变性赋予了 bytes 极高的安全性和确定性。在程序无需对字节流进行原地变动、或者强烈依赖数据不可篡改的场景下,bytes 是首选类型。
1. 协议魔数、文件头签名与固定常量
许多二进制文件格式与通信协议均使用固定的魔数(Magic Number)来验证文件类型或帧起始符。例如 PNG 图像前 8 个字节为 b'PNG
',ZIP 文件头部为 b'PK'。将这些常量定义为 bytes,可以杜绝运行过程中被任何模块误修改的可能。
# 校验二进制文件魔数
PNG_MAGIC = b'PNG
'
def is_png_file(file_path: str) -> bool:
with open(file_path, 'rb') as f:
header = f.read(8)
# bytes 之间可直接进行恒定比较
return header == PNG_MAGIC2. 密码学哈希、数字签名与密钥管理
Python 标准库中的 hashlib、hmac 以及第三方密码学库(如 cryptography)在处理密钥、公私钥证书、随机盐(salt)和哈希摘要时,均以 bytes 作为标准输入输出。不可变性确保了密钥在多层函数调用传递时不被篡改,杜绝了并发线程下的状态污染隐患。
import hashlib
import hmac

secret_key = b'system_audit_master_key_2026'
payload = b'action=transfer&amount=5000&dest=bank_09'

# 计算 HMAC-SHA256 签名,生成确定且不可变的校验字节
signature = hmac.new(secret_key, payload, hashlib.sha256).digest()
print(f"签名长度: {len(signature)} 字节, 示例值: {signature.hex()}")
3. 作为字典的键(Dict Key)或集合元素(Set Element)
Python 中的字典键必须是可哈希(Hashable)对象。bytes 是只读的,在内部会缓存自身哈希值,因此能够作为字典键或放入 set 进行高速查找;而 bytearray 是可变对象,没有实现 __hash__,若强行将其作为字典键会立即抛出 TypeError: unhashable type: 'bytearray' 异常。
# 使用 bytes 作为哈希表索引(例如二进制 Token 或特征指纹缓存)
session_cache = {}
token_bytes = b'ñ¸'
session_cache[token_bytes] = {"user_id": 10024, "role": "admin"}
# 尝试使用 bytearray 作为键(将触发错误)
try:
invalid_key = bytearray(token_bytes)
session_cache[invalid_key] = {"user_id": 10024}
except TypeError as err:
print(f"捕获预期异常: {err}")
# 输出示例:捕获预期异常: unhashable type: 'bytearray'4. 多线程与多进程共享只读资源
在并发编程中,共享可变状态往往是死锁与竞态条件的根源。当多个工作线程需要并发读取同一份二进制特征库、预训练权重字典或静态资源时,使用 bytes 无需加锁保护即可保证数据一致性,消除了锁竞争开销。
三、bytearray 的典型使用场景与就地修改优势
在涉及大量动态流式传输、频繁数据修改或大规模数据组装的场景中,bytearray 展现出强大的性能优势。它能够像操作普通列表一样,通过下标直接更改单字节数值,或通过切片原地覆写一段区间。
1. 网络套接字流式缓冲与拆包组包
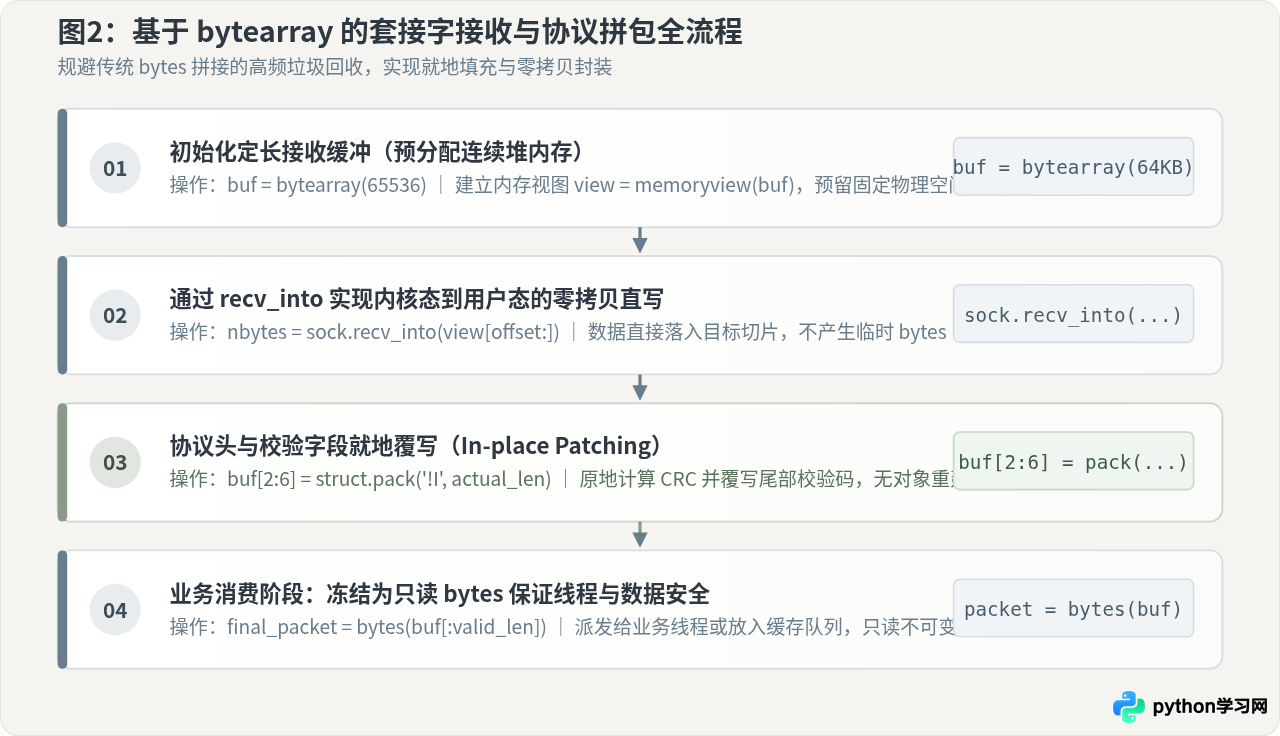
在网络编程中,由于 TCP 存在粘包与分包现象,接收端往往需要在一个循环中持续读取数据直到收满一个完整的协议帧。如果使用 bytes 执行 data += chunk,每次都会分配新内存并拷贝既有数据;当单个连接传输数十兆数据时,内存拷贝开销和 GC 负担会显著拖垮吞吐量。使用 bytearray 则能以均摊常数时间持续追加。
2. 原地覆盖协议头与校验和字段(In-place Patching)
在组装复杂的自定义二进制报文时,报文头部的“数据包总长度”或尾部的“CRC32 校验和”往往需要在有效载荷(Payload)完全确定后才能计算。传统做法需要切片并重新拼接三段 bytes,而使用 bytearray 可以直接就地覆写对应的字节区间。
import struct
import zlib

def build_protocol_frame(command_id: int, payload_data: bytes) -> bytearray:
    # 报文规范:[2字节魔数][2字节命令][4字节总长度][N字节载荷][4字节CRC32]
    total_len = 2 + 2 + 4 + len(payload_data) + 4

    # 1. 预先构建基础帧结构
    frame = bytearray()
    frame.extend(b'\xAA\x55')                       # 魔数
    frame.extend(struct.pack('!H', command_id))       # 命令字
    frame.extend(b'\x00\x00\x00\x00')              # 长度占位符
    frame.extend(payload_data)                        # 载荷数据
    frame.extend(b'\x00\x00\x00\x00')              # 校验和占位符

    # 2. 就地覆写总长度字段 (偏移量 4 到 8)
    frame[4:8] = struct.pack('!I', total_len)

    # 3. 计算 CRC32 并就地覆写尾部 4 字节
    calculated_crc = zlib.crc32(frame[:-4])
    frame[-4:] = struct.pack('!I', calculated_crc)

    return frame

frame = build_protocol_frame(0x0102, b'status=online')
print(f"最终帧长度: {len(frame)} 字节, 十六进制: {frame.hex()}")
3. 配合 socket.recv_into 与 memoryview 实现零拷贝 I/O
Python 的 socket 提供了 recv_into() 方法,可以直接将内核接收缓冲区中的字节流写入实现了缓冲区协议(Buffer Protocol)的可写对象中。结合 bytearray,可以在应用层彻底实现零临时对象的流式读取:
import socket

def read_exact_frame(sock: socket.socket, expected_size: int) -> bytearray:
    # 预分配固定大小的连续堆缓冲区
    buffer = bytearray(expected_size)
    view = memoryview(buffer)
    bytes_received = 0

    while bytes_received < expected_size:
        # 直接写入 buffer 对应切片的物理内存地址,无中间 bytes 对象生成
        n = sock.recv_into(view[bytes_received:])
        if n == 0:
            raise ConnectionError("套接字连接异常中断")
        bytes_received += n

    return buffer
4. 图像像素与音视频裸流的局部变换
在处理灰度图、RGBA 像素阵列或 PCM 音频裸流时,算法经常需要执行逐像素反相、Alpha 通道混合、按位异或掩码(XOR Mask)或字节序反转。使用 bytearray 可直接索引修改元素,每个索引赋值操作直接写入单字节(0~255 的整数),效率远高于构建新列表再转回 bytes。
def xor_mask_inplace(data_buffer: bytearray, key: int) -> None:
    # 简单异或掩码原地加密/解密:无需分配额外内存
    for i in range(len(data_buffer)):
        data_buffer[i] ^= key

raw_stream = bytearray(b'SensitiveFinancialRecord2026')
xor_mask_inplace(raw_stream, 0x5A)
print(f"混淆后十六进制: {raw_stream[:12].hex()}")
xor_mask_inplace(raw_stream, 0x5A)
print(f"还原后明文: {raw_stream.decode('ascii')}")
四、性能基准与工程选型依据
为了直观展示两种类型在不同操作下的行为差异,下表汇总了核心维度的具体对比:
| 对比维度 | bytes | bytearray |
|---|---|---|
| 可变性(Mutability) | 完全不可变(Immutable) | 可变(Mutable),支持索引/切片就地赋值 |
| 可哈希性(Hashability) | 支持,计算并缓存 Hash 值,可用作字典键 | 不支持,无 __hash__,不可作为字典键 |
| 单元素访问返回值 | int(0~255 的整数) |
int(0~255 的整数) |
| 切片操作返回值 | 返回新的 bytes 对象(拷贝内存) |
返回新的 bytearray 对象(拷贝内存) |
| 追加/拼接时间复杂度 | 循环内 += 为 $O(N^2)$(频繁重新分配与拷贝) |
append() / extend() 均摊 $O(1)$(动态容量扩展) |
| 内存开销(小对象) | 极致紧凑,仅包含对象头与实际数据 | 额外维护堆指针与容量计数字段,存在过分配空闲区 |
| 零拷贝接收适配 | 不可写,不支持 socket.recv_into |
原生支持 recv_into 与可写 memoryview |
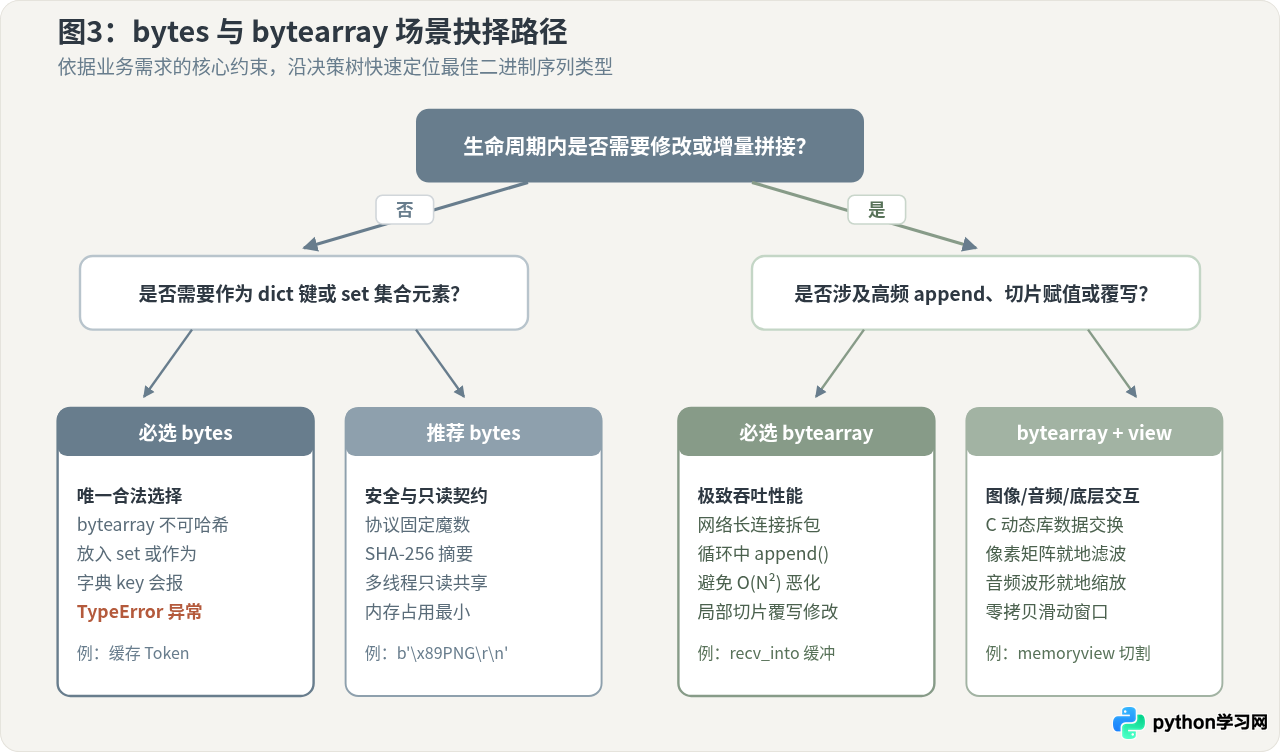
无论对
bytes 还是 bytearray,单元素索引 data[0] 返回的都是一个 整数(int) 而非单字节序列!例如 b'A'[0] 返回数值 65。如果需要获取单字节的切片序列,必须使用切片语法 data[0:1](返回 b'A')。同时,对 bytearray 的单个索引赋值时,也必须传入 0 <= x <= 255 的整数,传入单字符字符串将引发 TypeError。
五、相互转换与协同工程实践
在工业级 Python 系统中,bytes 与 bytearray 并非相互割裂,而是高度互补的。一种被广泛采用的工程架构是:“内部使用 bytearray 动态组装加工,外部交付与持久化时冻结为 bytes”。
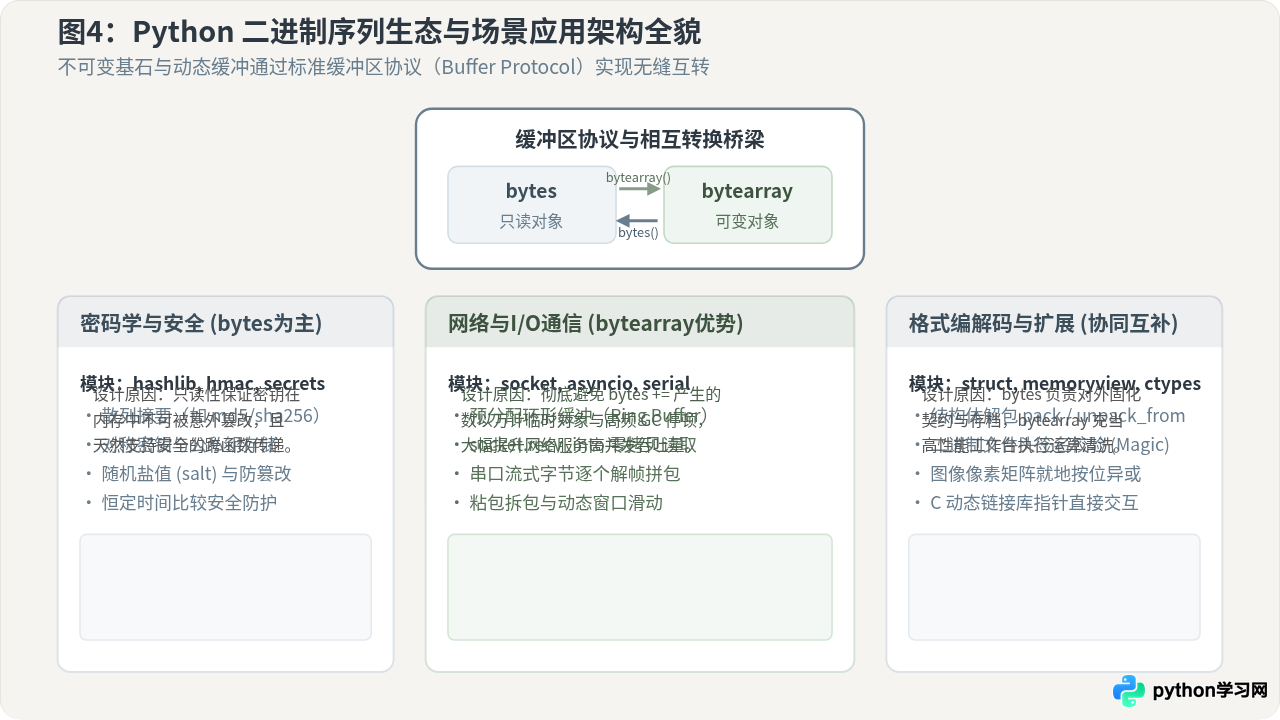
1. 协同转换的最佳实践
通过 bytes(ba) 可以快速将可变的 bytearray 固化,生成一个只读快照;通过 bytearray(b) 则可将只读的字节串载入工作台开始编辑。
# 阶段 1:使用 bytearray 在局部函数内高速收集网络数据
collector = bytearray()
for chunk in incoming_stream_generator():
    collector.extend(chunk)

# 阶段 2:在数据收集完成、准备发布事件时固化为不可变 bytes
final_message = bytes(collector)

# 阶段 3:安全交付给事件总线或消息队列,各订阅方并发读取,无被篡改风险
event_bus.publish(topic="telemetry", payload=final_message)
2. 借助 memoryview 避免切片拷贝开销
当数据体量达到数兆至数十兆级别时,即使是只读切片 b[1000:50000] 也会创建一份 49KB 的新对象。此时可以借助 Python 内置的 memoryview。无论是 bytes 还是 bytearray,均可被 memoryview 包装,在底层共享同一块连续物理内存,实现真正意义上的切片零拷贝。
large_data = bytearray(10 * 1024 * 1024)  # 10MB 缓冲区
# 包装为内存视图
view = memoryview(large_data)

# 切片获取子视图,不发生任何实际内存复制
header_view = view[:64]
payload_view = view[64:1024*1024]

# 对可变 bytearray 的 memoryview 赋值,会直接同步映射到底层数据
header_view[0:4] = b'POST'
assert large_data[:4] == b'POST'
六、总结与选型速查准则
总结而言,选择 bytes 还是 bytearray,本质是在“状态不可变性带来的安全与确定性”与“就地可变性带来的极致 I/O 与拼接性能”之间做权衡:
- 选择 bytes 的场景:存储配置魔数、文件头标识、加密密钥、散列哈希值;作为字典键或集合元素;跨模块/跨线程发布只读消息;数据量小且一次性生成的只读二进制串。
-
选择 bytearray 的场景:网络套接字(Socket)长连接循环接收与拆包;二进制协议报文就地组装与长度/校验字段回填;音视频或图像等密集流式数据的局部像素变换;需要配合
recv_into执行零拷贝读写的场景。
掌握两者的设计哲学与底层特性,结合场景合理切换与协同运用,是编写出低延迟、高并发与内存安全 Python 二进制处理代码的关键基础。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















