


Python怎么从混合字符串中提取英文字符
详细讲解在Python中如何从包含汉字、数字、特殊符号的混合字符串中提取英文字符。涵盖正则表达式抽取、Unicode与isalpha边界辨析、列表推导式过滤及海量数据性能优化方案。
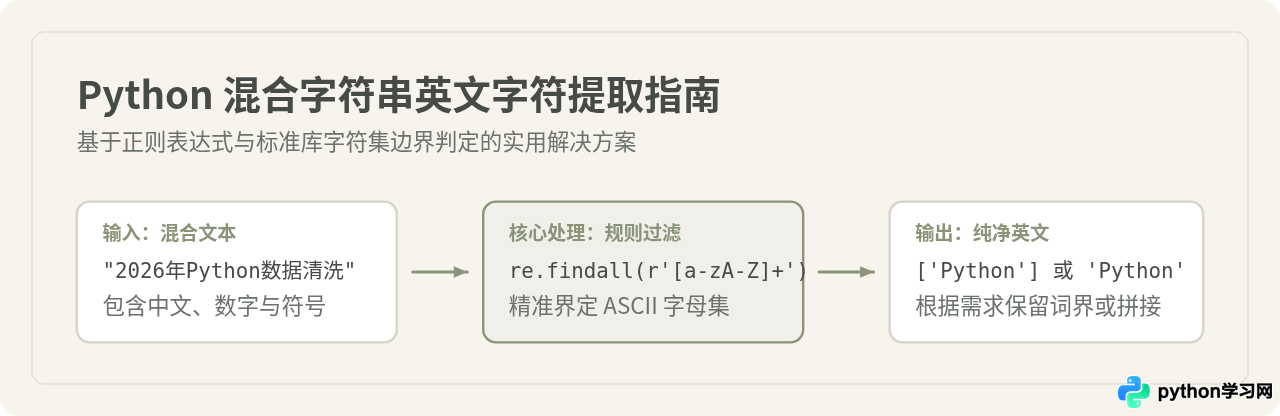
re.findall(r'[a-zA-Z]+', text);如果目标是过滤掉所有杂质、仅拼接出连续的纯英文字符串,可以使用 re.sub(r'[^a-zA-Z]', '', text) 或基于 c.isascii() and c.isalpha() 的推导式。掌握这两种模式与字符集边界,便能应对绝大多数文本清洗任务。
一、基于正则表达式的高效提取法
Python 内置的 re 模块是处理此类问题最直接、代码量最少的工具。针对不同的业务诉求,正则表达式通常有两套截然不同的提取逻辑。
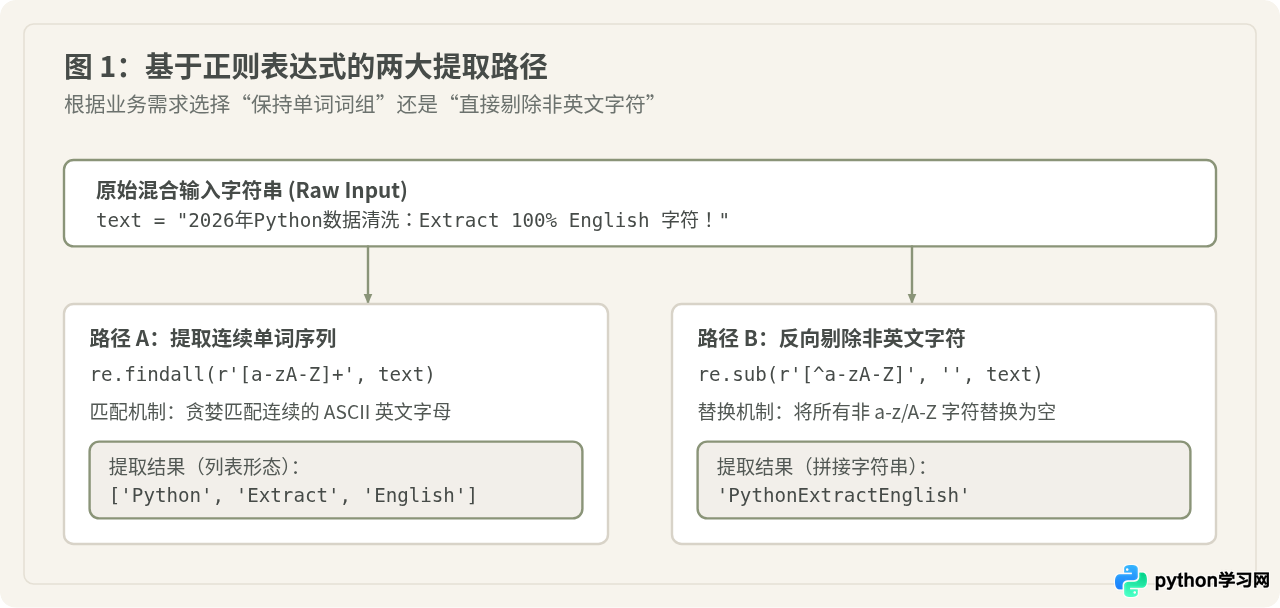
1. 模式一:提取连续的英文单词列表
在很多数据清洗任务中,我们希望把每个英文词汇作为单独单元提取出来,例如从商品标题或中英混排日志中抽取英文品牌名或参数标签。使用贪婪量词 + 的 re.findall 可以精准匹配连续的英文字母段。
import re

text = "2026年Python数据清洗:Extract 100% English 字符!"

# 提取连续的英文单词
words = re.findall(r'[a-zA-Z]+', text)
print("提取到的单词列表:", words)

# 如果需要将单词重新用空格拼接成自然语句
clean_sentence = " ".join(words)
print("空格连接的结果:", clean_sentence)空格连接的结果: Python Extract English
正则表达式 r'[a-zA-Z]+' 表示匹配由一个或多个大小写英文字母组成的连续序列。中文、阿拉伯数字、空格及全半角标点符号都会作为天然的分隔符被直接跳过。
2. 模式二:过滤非英文字符并得到紧密字符串
如果任务要求将所有零散分布的英文字符收集起来,拼接成一段紧密的纯英文字符串(如验证码脱敏、代码标识符比对),可以使用 re.sub() 进行反向替换:
import re

text = "2026年Python数据清洗:Extract 100% English 字符!"

# 反向替换:将非英文字母全部置为空字符串
clean_str = re.sub(r'[^a-zA-Z]', '', text)
print("纯英文字符串:", clean_str)
这里的 r'[^a-zA-Z]' 中的脱字符 ^ 位于方括号内部第一位,代表字符类的非运算,即匹配任何非 ASCII 大小写英文字母的字符并将其剔除。
二、标准库与推导式:警惕 Unicode 下 isalpha() 的误区
在不引入正则表达式时,不少初学者习惯使用列表推导式配合 Python 字符串内置的 isalpha() 方法来提取英文字母。然而,在包含汉字的混合字符串中,直接调用 isalpha() 会导致严重的逻辑错误。
'中'.isalpha() 会返回 True?isalpha() 均返回 True。
我们可以通过一段简单的交互代码来验证这个特性:
chinese_char = "中"
print("汉字 isalpha 判断:", chinese_char.isalpha())  # 输出 True!

latin_char = "é"
print("变音拉丁字母 isalpha 判断:", latin_char.isalpha()) # 输出 True!变音拉丁字母 isalpha 判断: True
1. 正确做法 A:结合 isascii() 进行双重校验
Python 3.7 及以上版本为字符串对象提供了 isascii() 方法。若要安全提取英文字符,必须同时满足“是字母”并且“处于 ASCII 码表范围内(0~127)”这两个条件:
text = "2026年Python数据清洗:Extract 100% English 字符!"

# 双重判断:既是 ASCII 字符又是字母
english_chars = [c for c in text if c.isascii() and c.isalpha()]
result = "".join(english_chars)
print("正确提取的英文字符:", result)2. 正确做法 B:基于 string.ascii_letters 集合筛选
标准库 string 模块提供了预定义的纯 ASCII 字母常量 string.ascii_letters(包含全部 52 个大小写字母)。将其转换为集合 set 后执行成员测试,不仅逻辑更透明,查找性能也是 O(1):
import string

text = "2026年Python数据清洗:Extract 100% English 字符!"

# 构建查找集合
ascii_set = set(string.ascii_letters)

# 单次扫描过滤
result = "".join(c for c in text if c in ascii_set)
print("基于集合过滤提取:", result)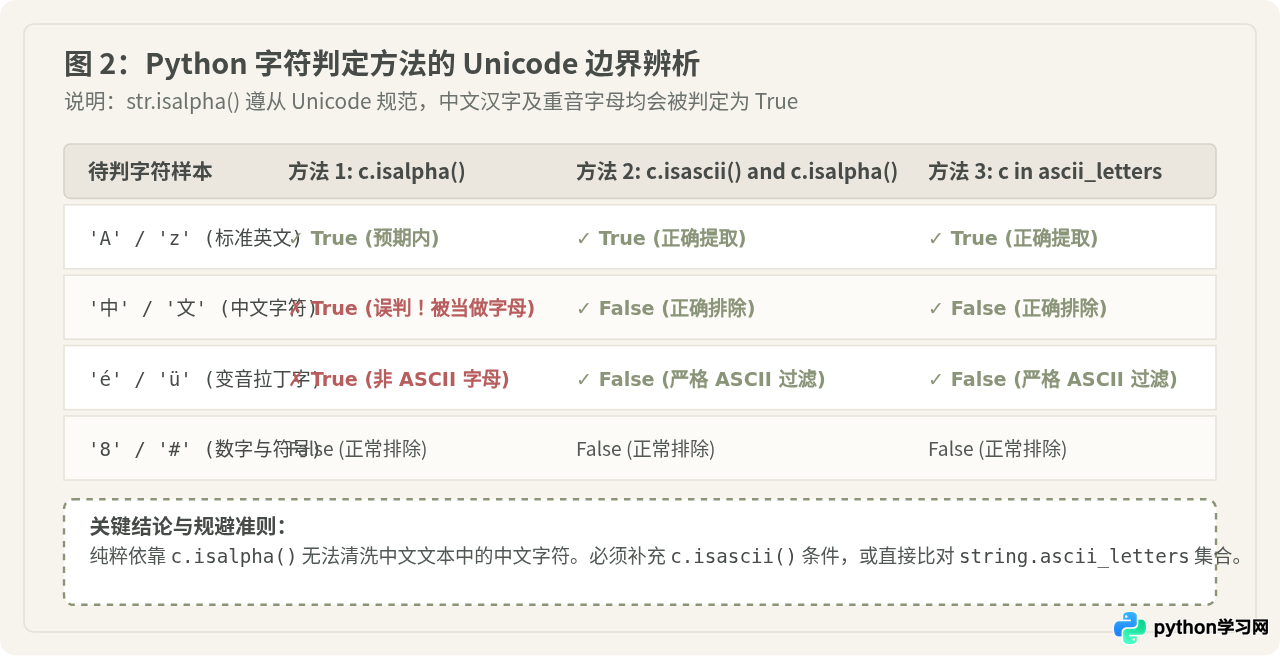
三、提取目标的数据形态与下游消费场景
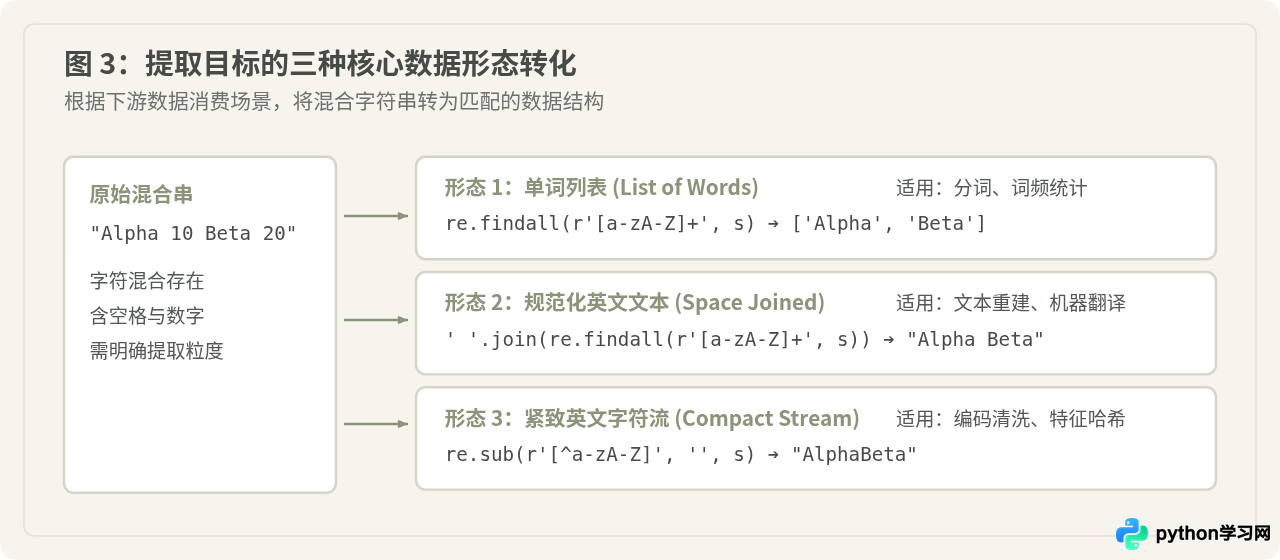
从混合字符串中提取英文字符并不是单一操作,输出的数据形态应直接服务于后续的数据结构需要。通常可以分为以下三种常见形态:
- 形态 1:单词列表 (List of Words):适合后续进行分词、英文停用词过滤、词频统计或建立倒排索引。
- 形态 2:规范化空格连接串 (Normalized Words):适合将混合杂乱的段落整理为易读的纯英文句式,便于送入机器翻译或大语言模型做下一步分析。
- 形态 3:紧致字符流 (Compact Stream):适合比对哈希值、清洗编码序列、提取特定字母代号。
import re

raw = "Item编号:SKU-982A-ProdX版本 (RevB)"

# 形态 1:抽取词块列表
word_list = re.findall(r'[a-zA-Z]+', raw)
print("形态 1 (词列表):", word_list)

# 形态 2:空格连接规范化
spaced_text = " ".join(word_list)
print("形态 2 (空格连接):", spaced_text)

# 形态 3:单串紧致字母
compact_str = "".join(re.findall(r'[a-zA-Z]', raw))
print("形态 3 (紧致字母):", compact_str)形态 2 (空格连接): Item SKU A ProdX RevB
形态 3 (紧致字母): ItemSKUAProdXRevB
四、批量清洗与高性能场景优化
当需要处理数百万条混合文本记录(如爬虫数据清洗、日志流分析)时,代码的执行性能和资源消耗便成为了决定性考量。
1. 正则表达式预编译
在循环或批处理中反复调用 re.findall() 或 re.sub() 时,虽然底层有缓存机制,但显式使用 re.compile() 能避免每次解析模式串的微小开销,并且语义更加严谨:
import re

# 预先编译正则表达式对象
pattern_word = re.compile(r'[a-zA-Z]+')
pattern_clean = re.compile(r'[^a-zA-Z]')

batch_data = [
    "第一行:OrderNo-8839-XYZ完成",
    "第二行:User_Admin_2026登录成功",
    "第三行:Device#ModelA99离线"
]

# 批量抽取单词
cleaned_batch = [pattern_word.findall(item) for item in batch_data]
print("批量处理结果:", cleaned_batch)2. 使用 str.translate 快速过滤 (C 语言层极速执行)
对于单纯“剔除非英文字符”的高并发场景,str.translate 是 Python 内置最快的方法之一。通过构建一个将所有非 ASCII 字母映射为 None 的转换表,可以在底层的 C 层面完成字符丢弃:
import string

# 构造删除映射表:将所有不是 ascii_letters 的 Unicode 码位删除
# 针对常见 0~65535 字符范围,可以直接删除所有非英文码位
allowed = set(ord(c) for c in string.ascii_letters)
# 构建删除字典:将所有需要排除的 ASCII 字符映射为 None
delete_dict = dict.fromkeys([i for i in range(128) if i not in allowed], None)

text = "2026年Python清洗:Batch-99-Data"
# 先过滤掉 ASCII 范围内的数字与符号
ascii_cleaned = text.translate(delete_dict)
# 再剔除多字节非 ASCII 字符(如中文)
final_res = "".join(c for c in ascii_cleaned if c.isascii())
print("translate 过滤结果:", final_res)五、方案选型与技术对比
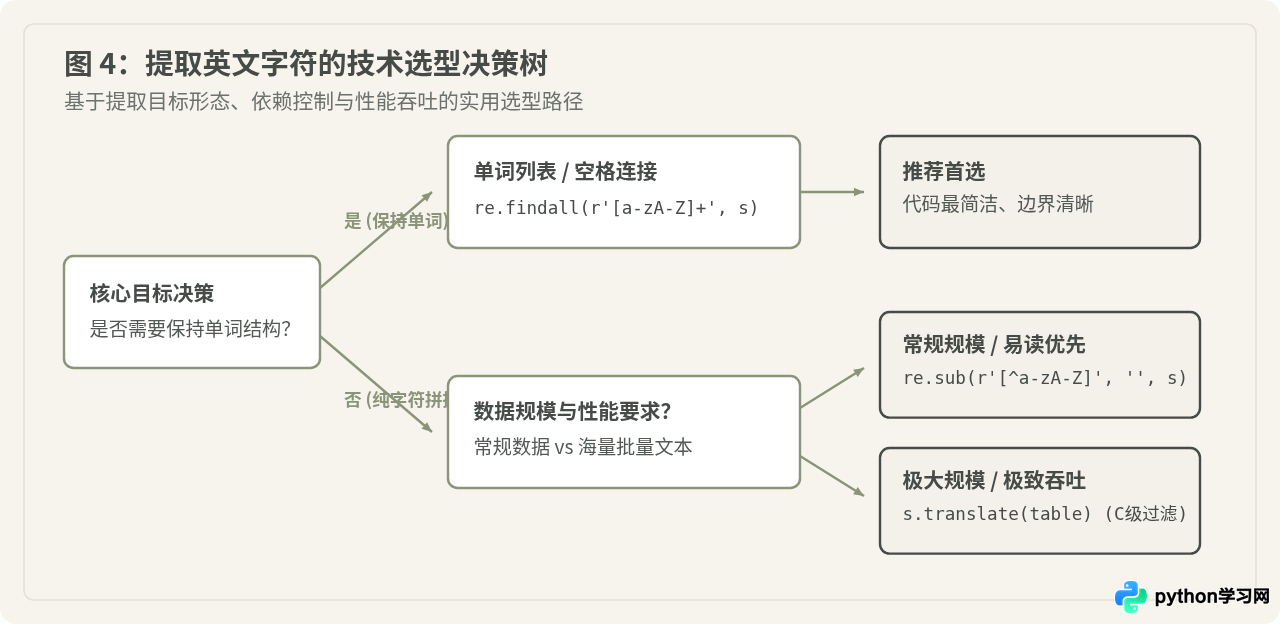
为了便于在日常开发中根据实际项目约束做出正确的技术选型,以下梳理了各主要方案的核心特征:
| 实现方案 | 典型代码 | 保留单词结构 | 中文防误判安全性 | 性能表现 | 适用场景推荐 |
|---|---|---|---|---|---|
| 正则分词提取 | re.findall(r'[a-zA-Z]+', s) |
是 (返回词列表) | 极高 (显式限定范围) | 良好 (正则引擎匹配) | 日常首选,需提取单词实体 |
| 正则反向剔除 | re.sub(r'[^a-zA-Z]', '', s) |
否 (拼接为单串) | 极高 (显式剔除非字母) | 良好 (单次正则替换) | 仅需要纯英文字符串拼接 |
| ASCII与字母双判 | [c for c in s if c.isascii() and c.isalpha()] |
否 (返回字符序列) | 极高 (精确过滤) | 中等 (纯 Python 循环) | 无需导入模块,简单轻量 |
| 集合成员推导 | [c for c in s if c in ascii_set] |
否 (返回字符序列) | 极高 (精确匹配) | 良好 (集合哈希查找) | 字符集合自定义扩展时首选 |
| 原生 isalpha 过滤 (误用) | [c for c in s if c.isalpha()] |
否 | 极低 (汉字被误判) | 良好 | 不适用于含中文的混合串 |
六、注意事项与边界条件
在实际工程应用中,还需留意以下两个经常出现的边界细节:
- 外来借词中的音标与扩展拉丁字符:若混合字符串中存在类似
café、naïve或résumé这类包含变音符号(Diacritics)的词汇,r'[a-zA-Z]'与isascii()会将带声调的元音字母直接舍弃,导致单词断裂为['caf', 'na', 've']。若业务场景要求保留这些扩展拉丁字母,应配合unicodedata.normalize('NFKD', s)先将重音字符拆解为基础英文字符加变音符,再过滤出基础字母;或改用正则 Unicode 脚本类别匹配。 - 大小写敏感性与规范化时机:如果提取后的英文词汇需要用于去重或字典统计,建议在提取后使用
.lower()统一大小写。在提取前使用.lower()并不会影响提取逻辑,但先过滤非英文字符再调用.lower()可以减少字符串方法在大文本上的无用调用。
总结而言,在 Python 中提取混合字符串中的英文,提取单词用 re.findall(r'[a-zA-Z]+', text),清除杂质用 re.sub(r'[^a-zA-Z]', '', text),推导式中务必搭配 isascii() 阻断汉字的干扰。明确输出格式与字符集边界,即可写出健壮、高效且易于维护的数据清洗代码。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















