


Dify开源版和云版怎么选?部署方式与功能差异说明
全面解析Dify开源社区版与Dify云版(SaaS)的核心差异、网络与系统架构、功能矩阵对比、开源版Docker Compose部署步骤以及多维度选型决策指南。
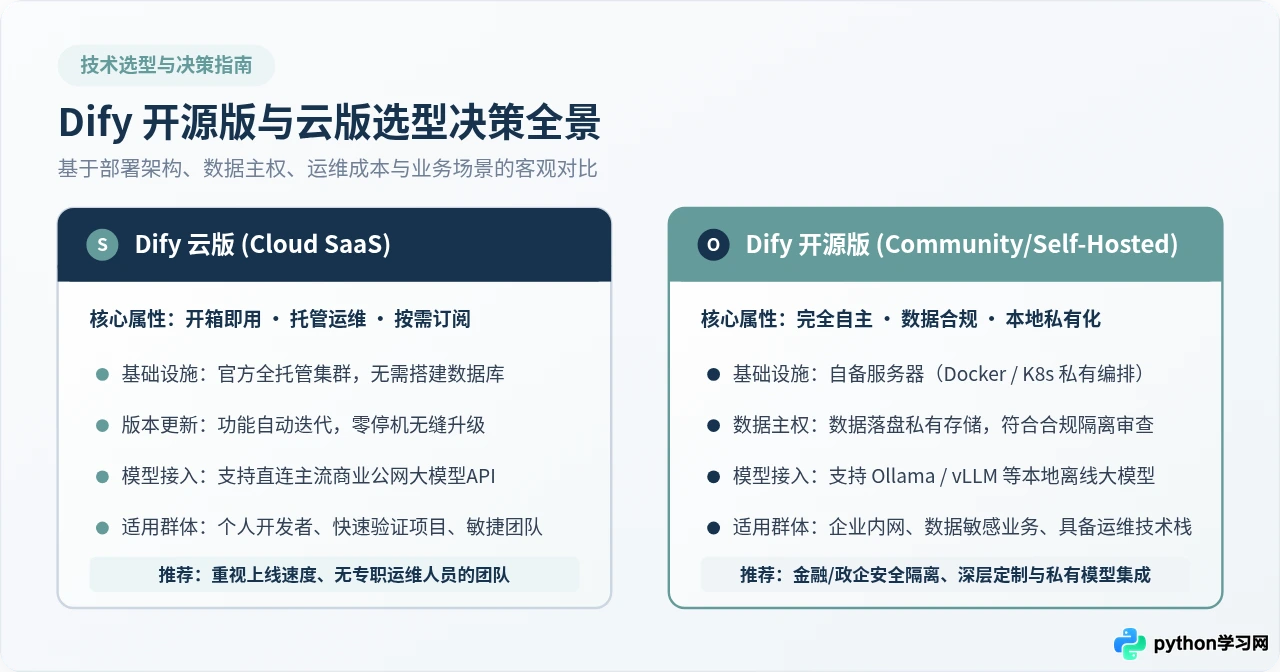
作为当前主流的开源 LLM(大语言模型)应用开发平台,Dify 凭借可视化 Prompt 编排、强大的 RAG 检索增强管道、灵活的工作流(Workflow)设计以及 Agent 智能体工具链,吸引了大量个人开发者与企业团队。然而,很多初次接触 Dify 的读者往往会面临首要难题:究竟是直接注册云版开箱使用,还是在自己的服务器上拉起一套开源版?二者在实际使用中的能力边界、维护成本与数据流向究竟有何差异?本文将从底层架构、功能细节、实操部署和决策逻辑四个维度为你全面拆解。
一、底层定位与网络拓扑架构差异
理解云版与开源版的第一步,在于看清它们背后的服务承载形式和网络拓扑结构。两者的技术内核一脉相承,但运行环境和控制权完全不同。
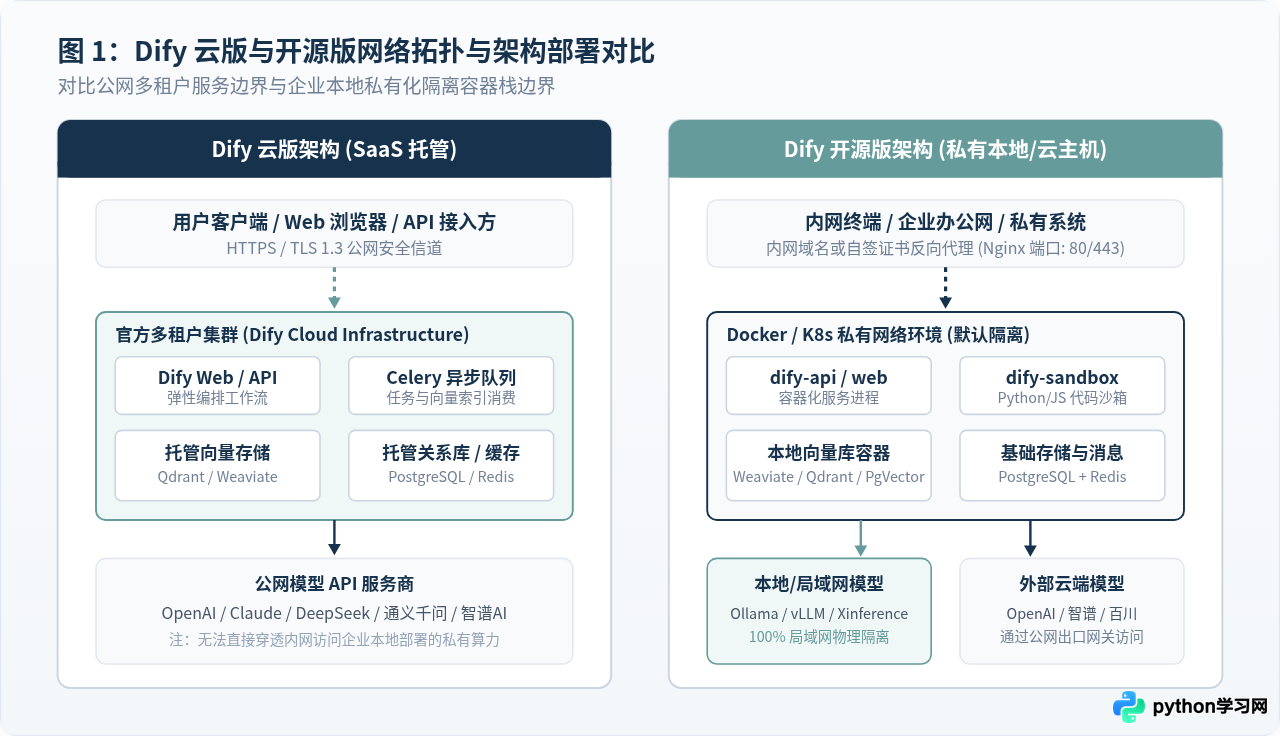
1. Dify 云版 (Cloud SaaS):全托管的弹性架构
Dify 云版是由官方团队负责维护的多租户 SaaS 平台。用户无需采购服务器、配置域名证书或关注数据库高可用。底层的 Web 网关、Celery 异步任务队列、PostgreSQL 业务库、Redis 缓存以及 Qdrant/Weaviate 等向量数据库全部运行在云端集群中。
在网络交互上,云版平台通过公共互联网向外发起请求。这意味着云版可以流畅接入 OpenAI、Anthropic Claude、DeepSeek、通义千问、智谱清言等带有公网 API 端点的模型服务。然而,云版无法直接访问企业内部私网 IP 或本地离线运行的 Ollama 实例,除非你额外搭建内网穿透(如 ngrok、frp 或公网反向代理),但这通常会引入额外的安全隐患与网络延迟。
2. Dify 开源版 (Self-Hosted):全自主掌控的容器化技术栈
Dify 开源版则以开源代码库的形式发布,用户可以通过 Docker Compose 或 Kubernetes(Helm Chart)将整个系统完整运行在本地物理机、私有数据中心或云厂商的 VPC 虚拟机中。
在开源自建模式下,知识库原始文档、向量切片嵌入、聊天日志、API 凭据全部存储在私有宿主机或自建数据库中。更重要的是,开源版天然处于内网环境,能够与局域网内的私有算力集群通过低延迟、高带宽的内网高速互联,形成真正意义上的数据闭环。
二、关键功能与运维边界对比
许多初学者误以为开源版就是云版的简单本地镜像,但在实际落地过程中,由于运营模式和环境依赖的不同,二者在功能支持、配置权限和日常运维上存在明显的边界差异。
1. 数据主权与安全合规
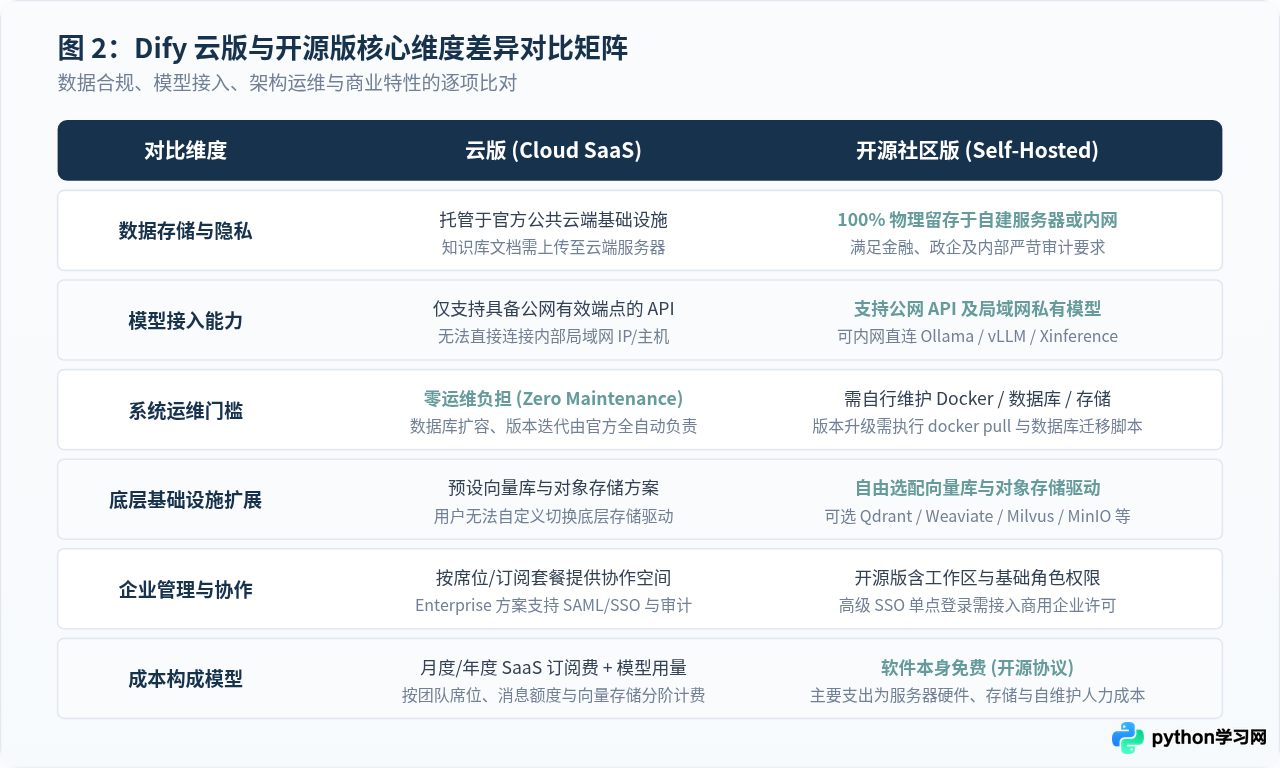
在云版中,用户上传的所有知识库资料(PDF、Word、Markdown)和问答记录均暂存在云端服务集群中。虽然官方具备严格的数据隔离措施,但对于金融、医疗、军工、政企等行业而言,任何涉及核心商业秘密或用户隐私的数据外传都会面临合规审查红线。
在开源版中,所有文本切片和关系数据均落在本地 Docker 卷或企业自建的 PostgreSQL 与向量数据库中,支持完全物理隔离(甚至断开外网),从物理根源上消除了数据泄露和跨境合规风险。
2. 大模型与向量基础设施的灵活性
云版为了保证平台稳定性和多租户服务一致性,其底层的向量索引引擎、对象存储策略均由官方固化,普通用户无法自定义调整分块底层的向量引擎类型。
开源版则赋予了开发者完全的基础设施选择自由:
- 模型接入:除了调用公网各大厂商的 API Key,开源版可一键打通部署在同局域网 GPU 服务器上的开源大模型(如 Llama 3、Qwen 2.5、DeepSeek-R1/V3),真正实现 0 算力 API 费用支出。
- 向量存储选型:默认使用 Weaviate,同时支持通过环境变量无缝切换为 Qdrant、Milvus、PgVector、Chroma 等,方便与企业已有的向量数据库基础设施并网。
- 对象存储扩展:支持集成本地目录、MinIO 专用对象存储集群,或是企业自建的阿里云 OSS、AWS S3 桶。
3. 系统运维与持续升级成本
运维负担是选择开源版必须付出的隐性成本。在云版中,Dify 官方几乎每周都会发布特性补丁、模型能力支持与 UI 优化,用户完全无感;而在开源版中:
- 版本升级:需要系统管理员手动执行
git pull、重新拉取镜像、运行数据库迁移脚本(flask db upgrade),一旦涉及大版本跨越(如数据库结构调整),需要有处理 schema 冲突的应急能力。 - 监控与容灾:必须自行建立 Docker 进程保活、PostgreSQL 数据定期备份、Redis 内存监控及磁盘扩容机制。
三、开源版实际部署方式与配置要点
如果你基于安全或私有模型需求决定采用开源版,那么掌握官方推荐的 Docker Compose 部署链路是不可或缺的实操技能。以下为生产环境标准的落地步骤与配置细节。
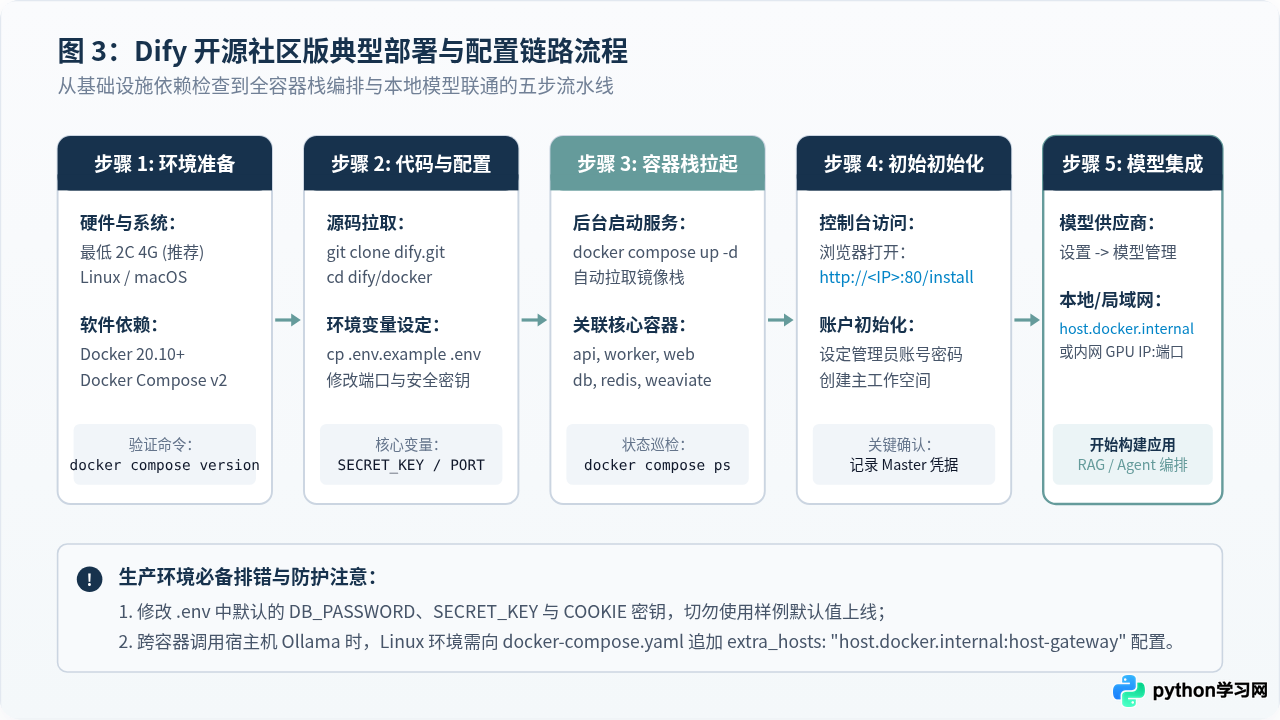
1. 硬件准备与环境校验
Dify 开源完整栈包含多个容器组件(Nginx、API 后端、Web 前端、Celery Worker、PostgreSQL、Redis、Weaviate 向量库以及 Sandbox 沙箱执行器)。因此,宿主机需要满足基本资源底线:
- 最低配置:2 核 CPU,4 GB 内存(仅供快速体验与单并发测试)。
- 生产推荐配置:4 核 CPU,8 GB 或 16 GB 内存,50 GB+ SSD 高速存储(随着知识库文档向量化增多,向量库和数据库对内存及 I/O 吞吐有较高要求)。
- 前置软件:安装 Docker 20.10+ 及 Docker Compose v2.0+。
2. 代码获取与关键环境变量调整
克隆官方代码仓库并切换至 docker 配置目录:
git clone https://github.com/langgenius/dify.git
# 2. 进入容器编排目录
cd dify/docker
# 3. 复制样例环境变量文件
cp .env.example .env
使用文本编辑器修改 .env 文件,以下三个核心参数在正式使用前必须确认:
- 安全密钥(SECRET_KEY):用于会话状态和敏感凭证加密,切勿保留默认空串或样例值,可使用
openssl rand -base64 42生成随机强密钥。 - Web 访问端口(EXPOSE_NGINX_PORT):默认监听
80端口。如果服务器已有 Nginx 或其他服务占用了 80 端口,可修改为8080或3000。 - 控制台外部访问地址(CONSOLE_API_URL / APP_API_URL):如果配置了独立公网域名或反向代理,需调整此项以防止前端 CORS 跨域拦截。
3. 启动容器集群与状态检查
docker compose up -d
# 查看各容器健康状态
docker compose ps
正常情况下,输出列表中应当看到 docker-api-1、docker-web-1、docker-worker-1、docker-db-1、docker-redis-1、docker-weaviate-1 等全部处于 Up 或 healthy 状态。
4. 初始化超级管理员账户
在浏览器中输入服务器 IP 与对应端口,例如:http://<服务器IP>/install,首次访问会自动跳转至初始化向导页面。在此处设置企业超级管理员的邮箱与强密码,提交后即完成整套本地私有 Dify 实例的安装。
当 Dify 运行在 Docker 容器内部,而你的 Ollama 或 vLLM 运行在宿主机本体(监听 11434 端口)时,在 Dify 后台模型配置中填写 http://127.0.0.1:11434 会连接失败(因为 127.0.0.1 在容器内部指向容器自身)。
正确解法:macOS/Windows 环境直接使用 http://host.docker.internal:11434;Linux 环境需在 docker-compose.yaml 中为 api 和 worker 服务增加 extra_hosts: ["host.docker.internal:host-gateway"] 映射,或者直接填写宿主机的局域网真实物理 IP。
四、选型决策路径与落地场景建议
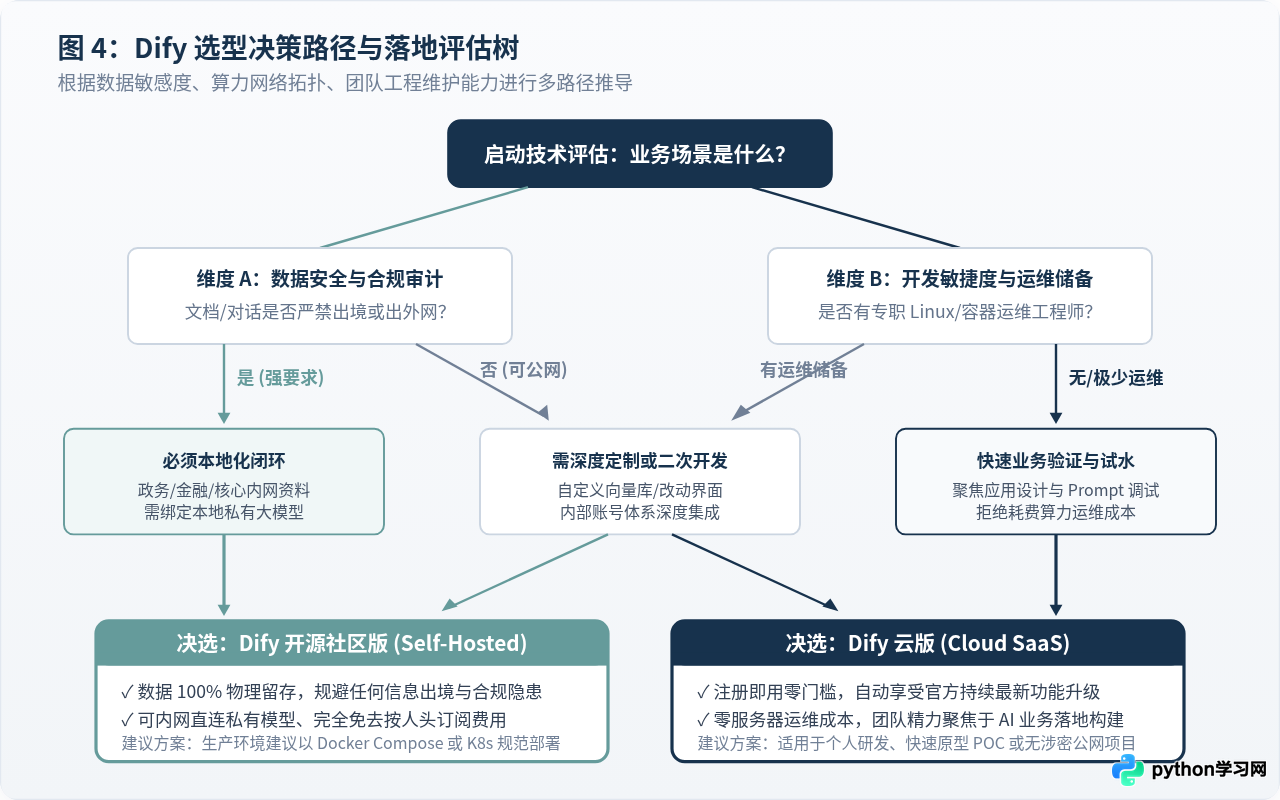
为了帮助不同规模的团队快速做出准确选择,我们梳理出如图 4 所示的选型决策树,并针对三种典型业务画像提供对应建议。
典型场景 1:个人独立开发者 / 初创团队快速做 POC 验证
推荐方案:首选 Dify 云版。
在此阶段,核心目标是验证业务逻辑与产品可行性(Product-Market Fit),精力应百分之百投入到 Prompt 调优、知识库切分效果评估以及 Workflow 流程设计上。云版免去了服务器购置、数据库维护及各种网络配置时间,团队可在 10 分钟内完成原型搭建,成本和效率优势最显著。
典型场景 2:中大型企业 / 数据敏感型部门内部知识库系统
推荐方案:坚决选择 Dify 开源版(私有化自建)。
涉及公司规章制度、技术代码库、财务审计凭证或销售合同样本时,公网云端托管存在不可接受的安全敞口。企业应利用内部局域网服务器或私有云 VPC 部署开源版,搭配本地私有部署的模型推理算力,彻底实现数据不离企、模型不联网的安全运行体系。
典型场景 3:混合过渡模式(双轨制落地)
推荐方案:云版探索验证 + 开源版生产沉淀。
很多成熟团队采用“混合双轨策略”:产品与设计人员利用 Dify 云版高效进行应用原型设计和测试。由于 Dify 支持将应用配置、Prompt、工作流一键导出为标准的 DSL(YAML 文件),在云版调试成熟后,工程团队可直接将 DSL 导入内部自建的开源版生产环境中,既兼顾了前期的开发敏捷度,又保障了后期的生产安全与合规归属。
总结归纳
Dify 开源版与云版并非相互替代的关系,而是服务于不同阶段与安全等级的两种形态。云版重在“敏捷与免运维”,适合追求速度与轻资产运营的项目;开源版重在“自主与高合规”,适合对数据主权、硬件架构与深度定制有明确掌控诉求的生产环境。根据你的团队工程储备与数据合规红线进行匹配,就是最合理的选型方案。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















