


Python str.replace()用法详解:基础字符替换与不可变性说明
深入解析Python中str.replace()方法的核心用法,包括基础字符替换、count限制次数、原理机制以及字符串不可变性(Immutability)带来的常见编程陷阱与最佳实践。
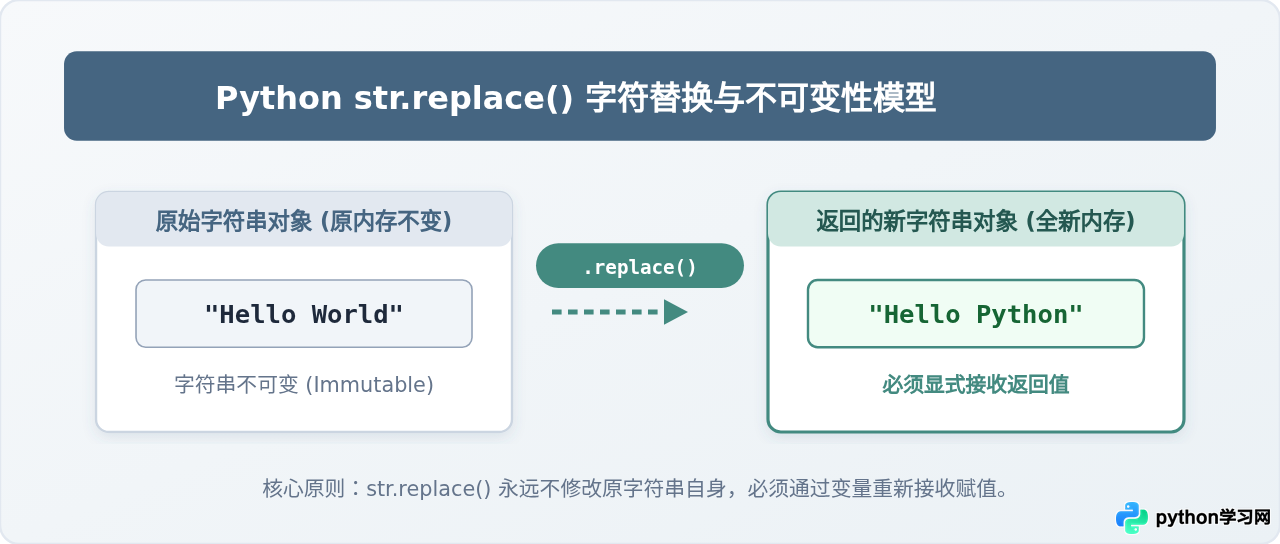
在 Python 中,处理文本替换最常用且直接的内置工具是 str.replace() 方法。无论是清洗日志中的无用符号、修正错别字,还是格式化模板变量,该方法都能快速达成目标。然而,许多初学者在第一次使用它时,常常会遇到“调用了 replace() 但原字符串完全没有改变”的困惑。这一现象并非程序出错,而是由 Python 字符串的不可变性(Immutability)决定的。本文将系统拆解 str.replace() 的语法参数、执行逻辑,并结合内存模型彻底讲清字符串不可变性的实际影响与应对方式。
一、str.replace() 的基础语法与参数解析
str.replace() 是 Python 字符串对象的内置方法,用于将字符串中出现的指定子串替换为新的文本。其完整方法原型如下:
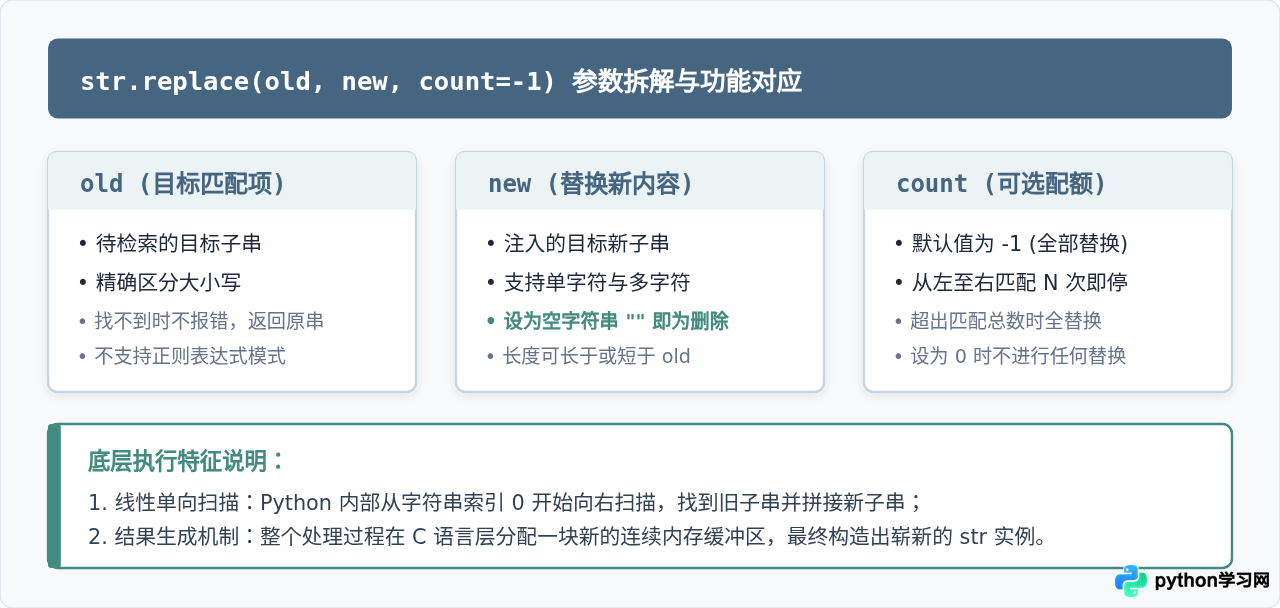
str.replace(old, new, count=-1)该方法接受三个参数,其中前两个为必选位置参数,第三个为可选参数:
old(必选,字符串):需要被替换的旧子字符串。如果在原字符串中未找到该子串,方法不会报错,而是直接返回原文本的一份新拷贝。new(必选,字符串):用于替换旧子串的新文本内容。若希望直接删除某些字符,将其传入空字符串""即可。count(可选,整数):最大替换次数。默认值为-1,代表无限制,即替换字符串中出现的所有匹配项;如果指定了正整数N,则仅从左到右替换前N次。
基础使用代码示例
下面展示最常见的两种基础操作:将指定文本替换为新内容,以及将指定字符替换为空以实现“删除”效果。
# 示例 1:常规全局替换
raw_text = "Python 2 is outdated. Python 2 code should migrate."
upgraded_text = raw_text.replace("Python 2", "Python 3")

print("替换后内容:", upgraded_text)

# 示例 2:传入空字符串实现删除指定符号
messy_phone = "010-8888-9999"
clean_phone = messy_phone.replace("-", "")

print("剔除分隔符后:", clean_phone)剔除分隔符后: 01088889999
二、核心机制与关键认知:字符串的“不可变性”
在 Python 中,基本数据类型被划分为可变对象(Mutable)和不可变对象(Immutable)。列表(list)和字典(dict)是典型的可变对象,可以在原有内存空间就地增删改;而字符串(str)、整数(int)和元组(tuple)属于不可变对象。
replace()、strip()、lower() 等),其本质都是基于原字符串计算并新建一个全新的字符串对象。
新手最常踩的“静默失效”陷阱
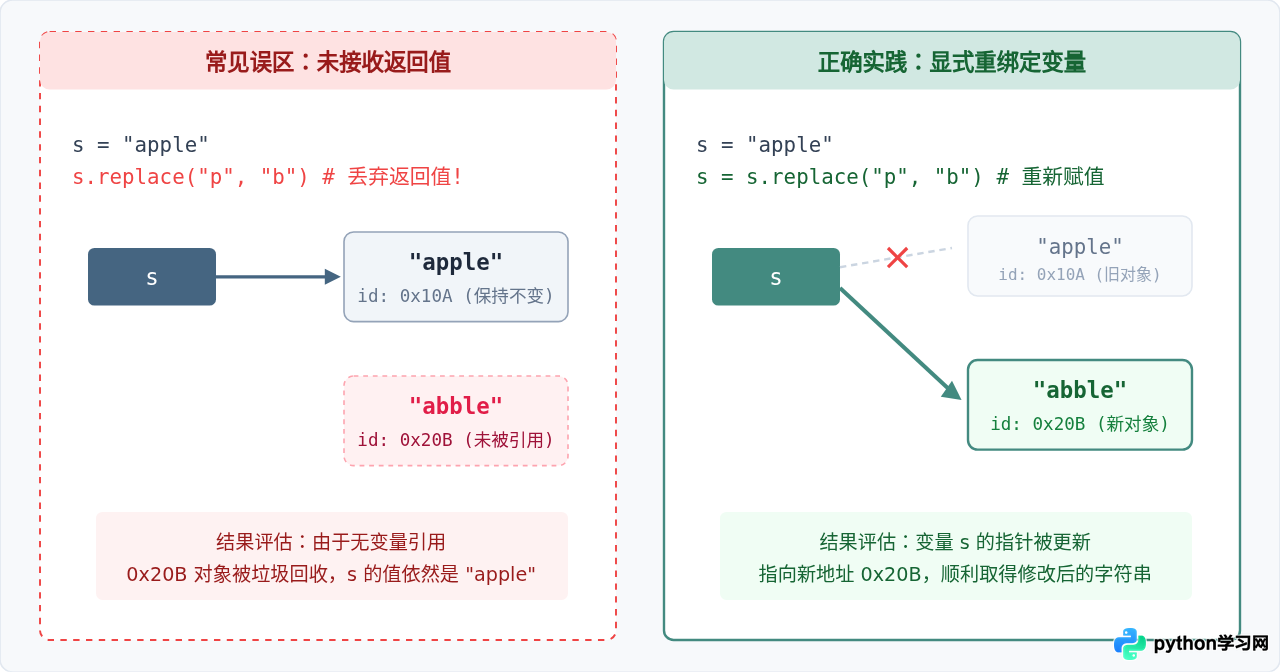
很多开发者在初学时,容易习惯性地像操作列表一样调用方法,写出如下代码:
filename = "report_2024.csv"
# 错误写法:未接收返回值
filename.replace(".csv", ".xlsx")

print("打印文件名:", filename)输出结果依然是 report_2024.csv,替换似乎完全“失效”了。但事实上,replace() 确实执行了,并且在内存中准确生成了 "report_2024.xlsx" 这个新字符串。然而,由于没有使用变量去绑定这个返回值,Python 随后将该临时对象丢弃回收,而变量 filename 依然指向最初的内存对象。
通过 id() 验证内存地址变化
我们可以使用 Python 内置的 id() 函数打印对象在内存中的唯一地址,直观验证这一行为:
original = "database_prod"
print(f"原字符串内容: {original}, 内存地址: {id(original)}")

# 发生替换并重新赋值
original = original.replace("prod", "test")
print(f"替换后内容: {original}, 内存地址: {id(original)}")替换后内容: database_test, 内存地址: 4358514480
两个输出的内存地址(id)完全不同,这直接印证了:变量 original 并非在旧内存块上被“涂改”,而是指向了全新创建的字符串实体。
三、精确控制替换次数:count 参数实战解析
在默认情况下,replace() 会贪婪地替换所有匹配到的子串。但在许多实际业务中,我们往往只需要替换前一次或前固定次数。例如处理网络路径、格式化首个分隔符、或脱敏首个匹配字符时,count 参数提供了最简单直接的控制手段。
count 参数的扫描执行步骤
当传入 count=N 时,Python 解释器的内部执行逻辑非常严谨:
- 从左侧索引
0处开始遍历扫描; - 每成功匹配到一个与
old相同的子串,就用new填充到结果缓冲区,并将剩余配额计数器减 1; - 一旦配额减至
0,立即终止匹配,将剩余的原文本不做任何处理直接拼接到结果缓冲区末尾; - 包装缓冲区内容为不可变的
str对象并返回。
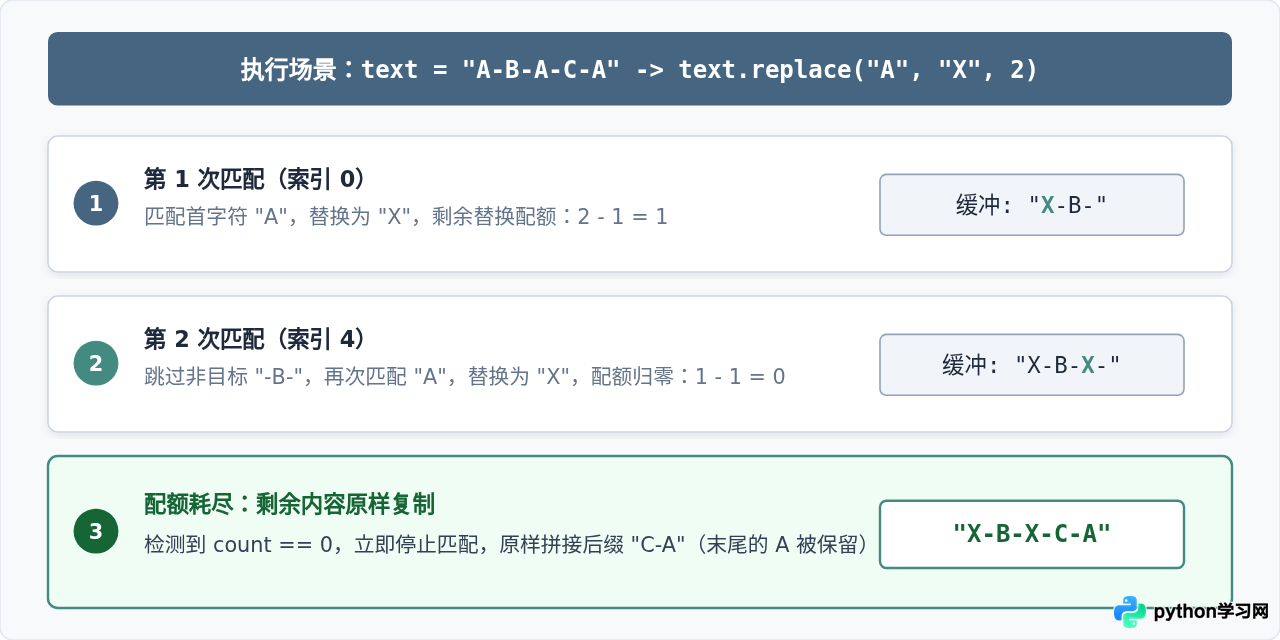
count 参数应用代码
raw_tags = "python;flask;django;fastapi;tornado"

# 仅替换前 2 个分号为逗号
partial_tags = raw_tags.replace(";", ", ", 2)
print("部分替换 (count=2):", partial_tags)

# 边界情况:当 count 设为 0 时
no_change = raw_tags.replace(";", ", ", 0)
print("不执行替换 (count=0):", no_change)不执行替换 (count=0): python;flask;django;fastapi;tornado
四、进阶场景与常见字符替换方案对比
在日常开发中,字符替换的需求往往不仅限于单次固定文本。针对链式替换、多规则映射和正则表达式匹配,Python 提供了不同的技术方案。合理选型能够避免冗余代码并提升运行性能。
1. 链式调用(Chaining)
由于 replace() 返回的始终是标准字符串对象,因此可以直接连续调用多次 .replace()。这种方式结构直观,适合处理少量(2~4 个)固定规则的清洗任务:
raw_input = "  [Notice]: System Error!  "
# 连续清理空格、中括号以及感叹号
cleaned = raw_input.strip().replace("[", "").replace("]", "").replace("!", "")
print("链式清理结果:", cleaned).replace() 都会在内存中经历一次“完整遍历 + 新建字符串”的过程。如果一个几兆的大文本连续进行 10 次链式替换,就会产生 10 次大内存分配与垃圾回收。面对大规模复杂替换时,应优先考虑 str.translate() 或 re.sub()。
2. 常见字符替换方案横向对比
为了让读者在实际编码中有据可依,下表梳理了 Python 中最主流的三种字符替换方案及适用场景:
| 方案 | 核心方法 | 匹配规则 | 主要优势 | 局限与注意事项 |
|---|---|---|---|---|
| str.replace() | text.replace(old, new, count) |
固定子串(精确匹配) | 零导入成本、执行快、可读性极佳 | 不支持模糊匹配、正则与忽略大小写 |
| str.translate() | text.translate(maketrans) |
单字符对单字符映射 / 删除 | C底层映射表极速执行,批量单字符清洗极快 | 构造映射表稍显繁琐,不适用于多字符子串替换 |
| re.sub() | re.sub(pattern, repl, text) |
正则表达式(模式匹配) | 支持动态模式、通配符、捕获组、回调函数 | 需导入 re 模块,正则编译与执行开销相对较大 |
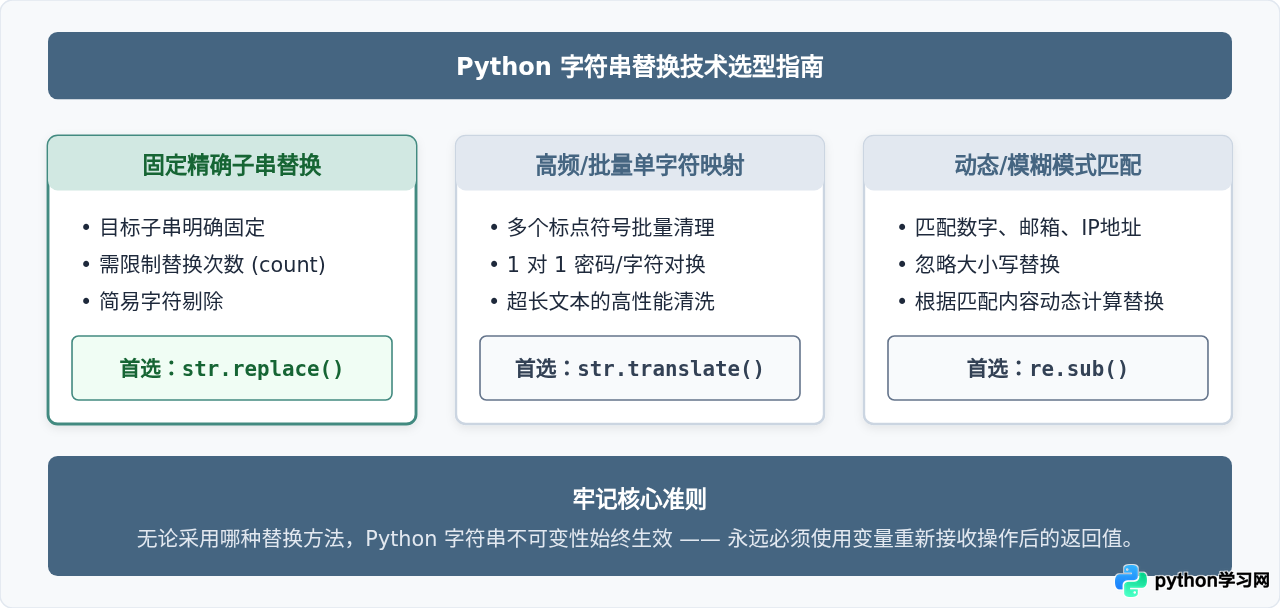
五、总结与编码规范自查清单
在编写涉及 str.replace() 的代码时,建议按以下三点进行自查:
- 检查返回值是否已赋值:确保代码写成了
s = s.replace(...)或赋值给了新变量,切勿单独执行s.replace(...)并期望原字符串改变。 - 确认是否需要限制 count:如果只希望替换第一个匹配项(如修正前缀或首个标记),务必显式传入
count=1,避免误伤后续正常内容。 - 明确匹配精确性:
str.replace()是区分大小写且严格子串匹配的。如果需要“不区分大小写”或“基于通配符匹配”,应果断切换到re.sub()。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















