


Python使用re模块按正则模式截取复杂字符串内容
深入讲解在Python中利用re模块按正则模式截取复杂字符串内容的完整实现方案。涵盖函数选型、命名捕获组、环视断言、多行跨度提取与生产环境容错技巧。
在处理日志、接口报文、HTML/XML 片段或格式混合的半结构化文本时,常规的 str.split() 或切片往往无法准确应对多变或嵌套的格式。Python 内置的 re 模块提供了以正则表达式为核心的模式匹配与截取能力。掌握从目标定位、捕获组划分到非贪婪匹配与环视断言的组合方法,能够高效、稳定地从复杂长字符串中提取目标字段。
一、核心截取函数与返回数据结构选型
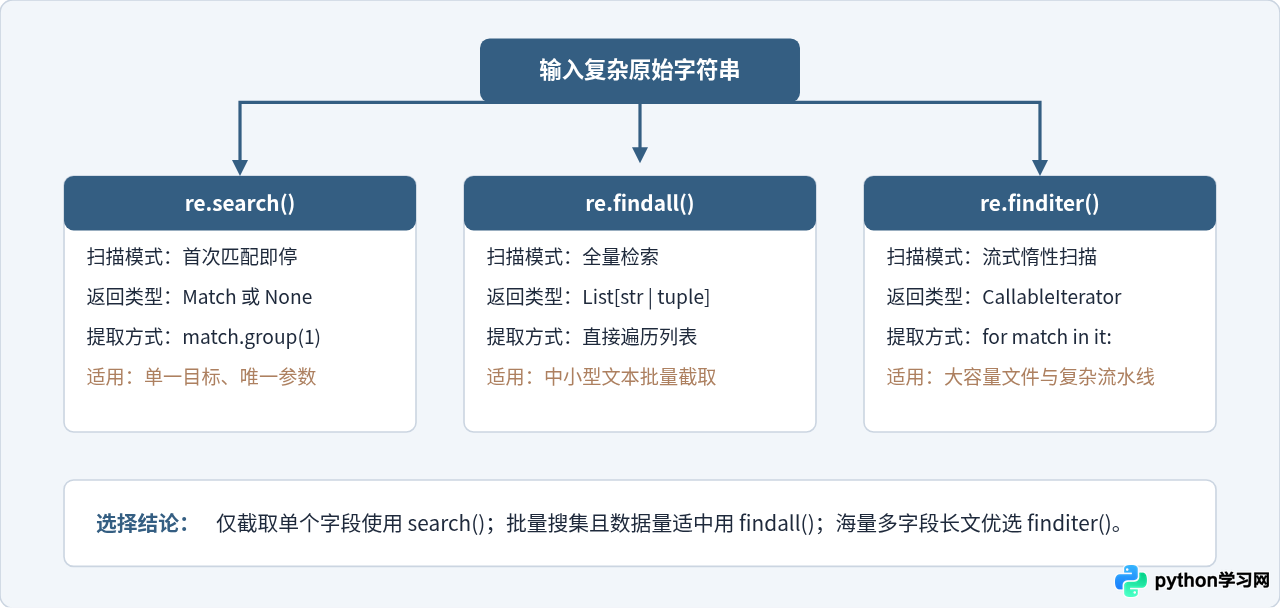
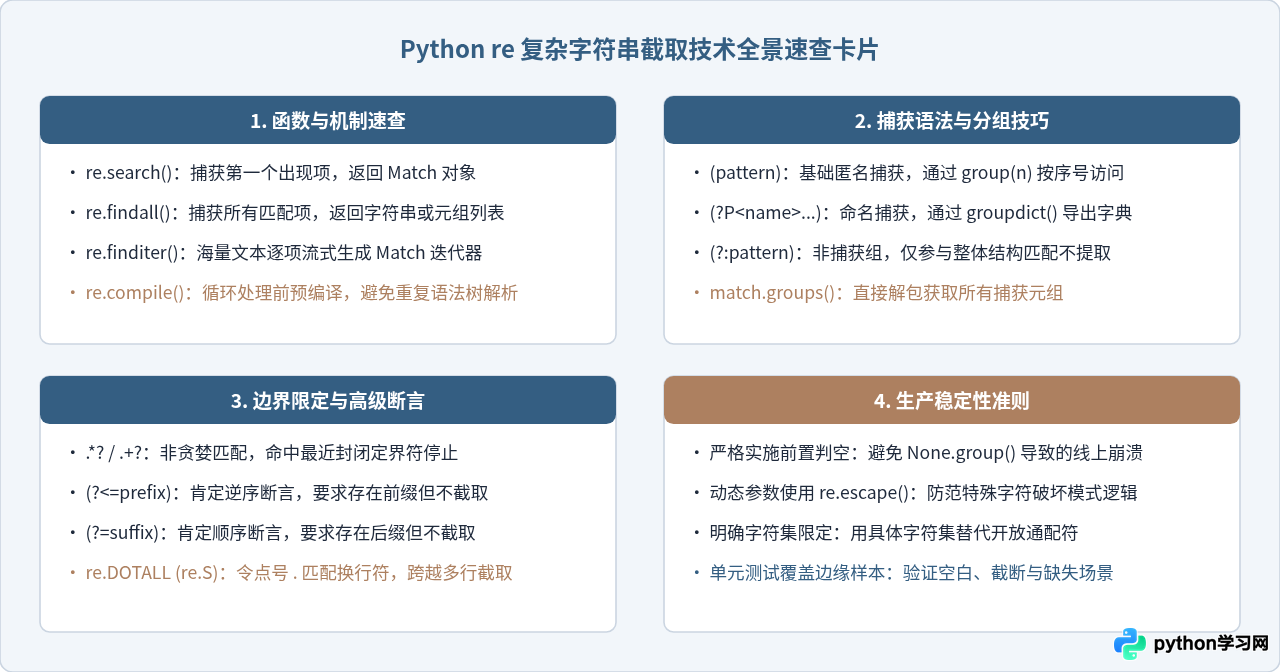
在编写正则表达式之前,首先需要根据截取目标在全文中的出现频次与内存预算,选择正确的 re 执行函数。re.search()、re.findall() 与 re.finditer() 在返回值结构与处理机制上存在显著区别:
- re.search(pattern, string):扫描整个字符串并返回第一个成功匹配的
Match对象;未匹配则返回None。适用于提取全局唯一的键值对或特定配置块。 - re.findall(pattern, string):扫描全文并以列表(
list)形式返回所有匹配项。当正则中包含捕获组时,返回由字符串或元组构成的列表。 - re.finditer(pattern, string):返回一个按顺序生成每个匹配
Match对象的迭代器。在处理大容量日志文件时,避免一次性在内存中创建大型列表。
二、使用捕获组与命名捕获组精准切分字段
复杂字符串通常由前缀标识、时间戳、状态码、主体内容等多种元素交织而成。若只匹配整体模式,后续还需要二次清洗。通过在正则表达式中使用圆括号 () 定义捕获组,可以在模式匹配的同时直接提取目标子串。
在维护复杂业务逻辑时,数字索引捕获组(如 match.group(1)、group(2))容易因模式调整产生索引偏移。推荐使用命名捕获组 (?P<name>...),不仅使模式自解释,还能通过 match.groupdict() 一步转换为字典结构。
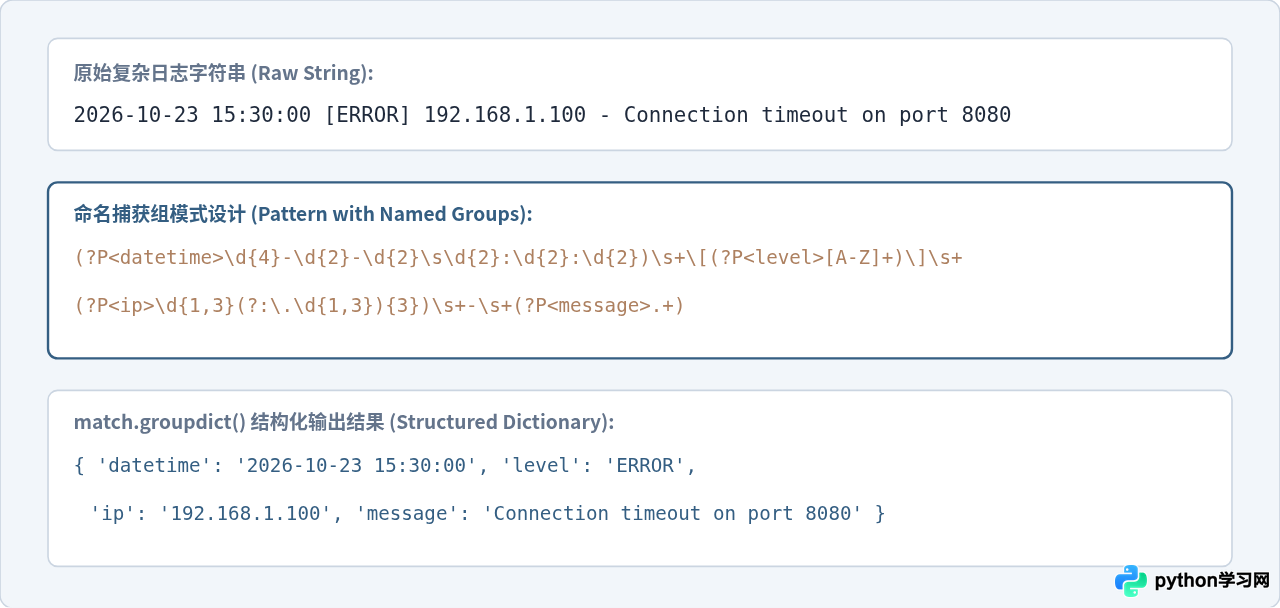
下面给出一段完整的工程级提取代码,演示如何使用命名捕获组解析多条混合格式的服务器调用记录:
import re

raw_logs = """
[2026-10-23 14:10:02] client=10.0.4.15 action=AUTH status=SUCCESS duration=12ms
[2026-10-23 14:10:05] client=192.168.2.88 action=QUERY status=TIMEOUT duration=1500ms
[2026-10-23 14:10:09] client=172.16.0.4 action=UPDATE status=FAILED duration=45ms error="disk full"
"""

# 定义针对复杂单行日志的命名模式
log_pattern = re.compile(
    r'\[(?P<timestamp>[^\]]+)\]\s+'
    r'client=(?P<client_ip>\S+)\s+'
    r'action=(?P<action>\w+)\s+'
    r'status=(?P<status>\w+)\s+'
    r'duration=(?P<duration>\d+)ms'
    r'(?:\s+error="(?P<error_msg>[^"]+)")?'
)

extracted_records = []
for match in log_pattern.finditer(raw_logs.strip()):
    data = match.groupdict()
    # 将数值字段规范化
    data['duration'] = int(data['duration'])
    extracted_records.append(data)

# 打印提取结果示例
for item in extracted_records:
    print(f"[{item['timestamp']}] {item['client_ip']} -> {item['action']} ({item['status']})")
输出示例(示例展示):
[2026-10-23 14:10:02] 10.0.4.15 -> AUTH (SUCCESS)
[2026-10-23 14:10:05] 192.168.2.88 -> QUERY (TIMEOUT)
[2026-10-23 14:10:09] 172.16.0.4 -> UPDATE (FAILED)
三、复杂边界截取:非贪婪匹配与环视断言 (Lookaround)
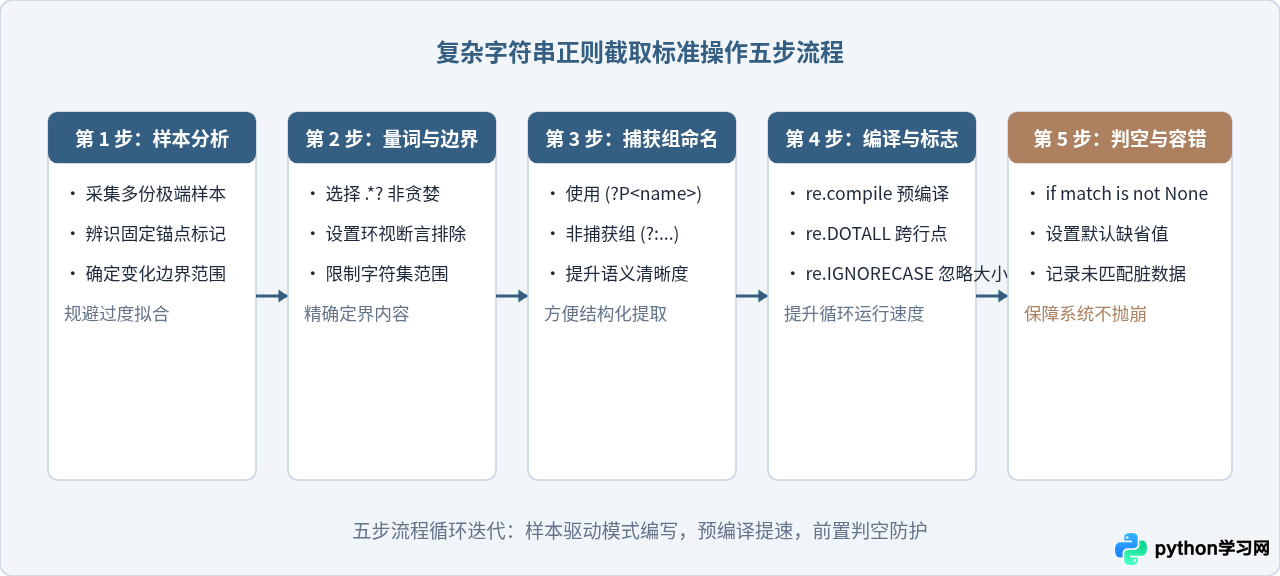
在实际业务中,目标内容往往被包裹在特定的上下文标记内,例如提取两个特定标签之间的正文、提取特定前缀后且不含前缀本身的字符。此时需要结合非贪婪匹配与环视断言。
1. 贪婪与非贪婪量词的选择
默认情况下,正则中的 *、+ 和 {m,n} 属于贪婪匹配,会尽可能吞噬更多的字符。截取两个分隔符之间的内容时,贪婪匹配会直接跨越中间的关闭标记,导致截取范围失控。在量词后添加 ?(如 .*? 或 .+?)可转换为非贪婪匹配,一旦遇到紧随其后的定界符即停止匹配。
2. 零宽环视断言(只匹配位置,不消费字符)
如果希望截取的内容中完全排除定界符本身,可以使用零宽断言:
- 肯定逆序后行断言
(?<=prefix):要求目标前必须出现prefix,但提取结果不包含prefix。 - 肯定顺序先行断言
(?=suffix):要求目标后必须紧接suffix,但提取结果不包含suffix。
3. 跨行复杂块截取实战示例
在解析带有换行的复合结构(例如 SQL 触发器配置或 HTML 注释块)时,默认的 . 无法匹配换行符 \n。此时必须传入 re.DOTALL(等价于 re.S)标志位。
import re

config_payload = """
<!-- BEGIN_CONFIG: database -->
host = 10.20.30.40
port = 5432
auth_plugin = "sha256"
<!-- END_CONFIG: database -->

<!-- BEGIN_CONFIG: redis -->
host = 127.0.0.1
port = 6379
cluster_mode = false
<!-- END_CONFIG: redis -->
"""

# 使用环视断言与跨行非贪婪匹配截取指定区块配置
# (?<=...) 确保在起始标记之后开始截取,(?=...) 确保在结束标记前终止截取
block_pattern = re.compile(
    r'(?<=<!-- BEGIN_CONFIG: database -->)(.*?)(?=<!-- END_CONFIG: database -->)',
    re.DOTALL
)

match = block_pattern.search(config_payload)
if match:
    # strip() 移除两侧换行与空白
    extracted_block = match.group(1).strip()
    print("成功截取 database 配置块:")
    print(extracted_block)
else:
    print("未找到指定配置块")
输出示例(示例展示):
成功截取 database 配置块:
host = 10.20.30.40
port = 5432
auth_plugin = "sha256"
四、生产级截取的边界排查与性能陷阱
search() 提取都必须有判空分支;高频正则必须预编译;动态文本拼接必须转义。
1. 防御 AttributeError: 'NoneType' object has no attribute 'group'
这是正则截取中最常见的线上错误。当原始字符串中因脏数据、网络丢包或字段缺失未能匹配时,re.search() 返回 None,直接链式调用 .group() 将导致程序崩溃。应采用显式条件守卫或封装安全提取函数:
def safe_extract(pattern: re.Pattern, text: str, default: str = "") -> str:
    match = pattern.search(text)
    return match.group(1) if match else default
2. 动态模式拼接时使用 re.escape()
如果截取的定界符来自用户输入或外部变量(如变量中包含 $、(、[、* 等特殊元字符),直接拼接进正则模式会引发语法错误或产生非预期逻辑。使用 re.escape(var) 可自动对特殊字符进行转义处理:
delimiter = "[SYSTEM_ID]"
# 正确转义特殊方括号字符
safe_pattern = re.compile(rf"{re.escape(delimiter)}:\s*(\w+)")
3. 规避灾难性回溯 (Catastrophic Backtracking)
当正则中出现多个重叠的量词嵌套时(如 (a+)+$ 或 (.*)*),在匹配失败的极端边界情况下,正则引擎会尝试指数级的可能路径,导致 CPU 使用率瞬间攀升至 100% 出现卡死。优化方式是收紧匹配字符集,例如使用 [^"\n]+ 替代无限制的 .*?。
五、总结与技术选型速查
在 Python 中使用 re 模块按模式截取复杂字符串内容时,应当遵循“模式越精确、提取越简练、边界越受控”的设计逻辑。根据任务特点选择最合适的截取范式:
| 截取目标场景 | 推荐模式 / 工具 | 典型提取代码 |
|---|---|---|
| 单字段唯一提取 | re.search() + 捕获组 |
match.group(1) if match else None |
| 复杂多字段结构化 | re.finditer() + 命名捕获组 |
[m.groupdict() for m in pattern.finditer(s)] |
| 两边界间内容(无边界) | 环视断言 (?<=A).*?(?=B) |
re.search(r'(?<=prefix).*?(?=suffix)', s) |
| 多行代码或区块配置 | re.DOTALL + 非贪婪匹配 |
re.compile(r'START(.*?)END', re.DOTALL) |
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















