


Python基础知识点全景梳理:从变量数据类型到控制流
系统梳理Python基础核心知识点,从变量的内存引用模型与数据类型划分,深入剖析条件分支、循环遍历及流程中断机制,帮助初学者建立扎实的语法体系。
掌握一门编程语言的核心路径,在于理清数据在内存中如何存放,以及指令逻辑如何依序推进。Python 通过动态类型系统和引用机制简化了语法表述,但在实际编码中,如果不理解对象的可变性与引用传递,很容易在变量赋值、容器修改与循环遍历中遇到隐蔽的逻辑缺陷。本文直接梳理 Python 最核心的底层逻辑链条:从变量标签模型与六大基础数据类型切入,进而过渡到分支判断与循环控制流,帮助读者建立连贯清晰的语言基础认知。
一、变量本质与内存引用机制
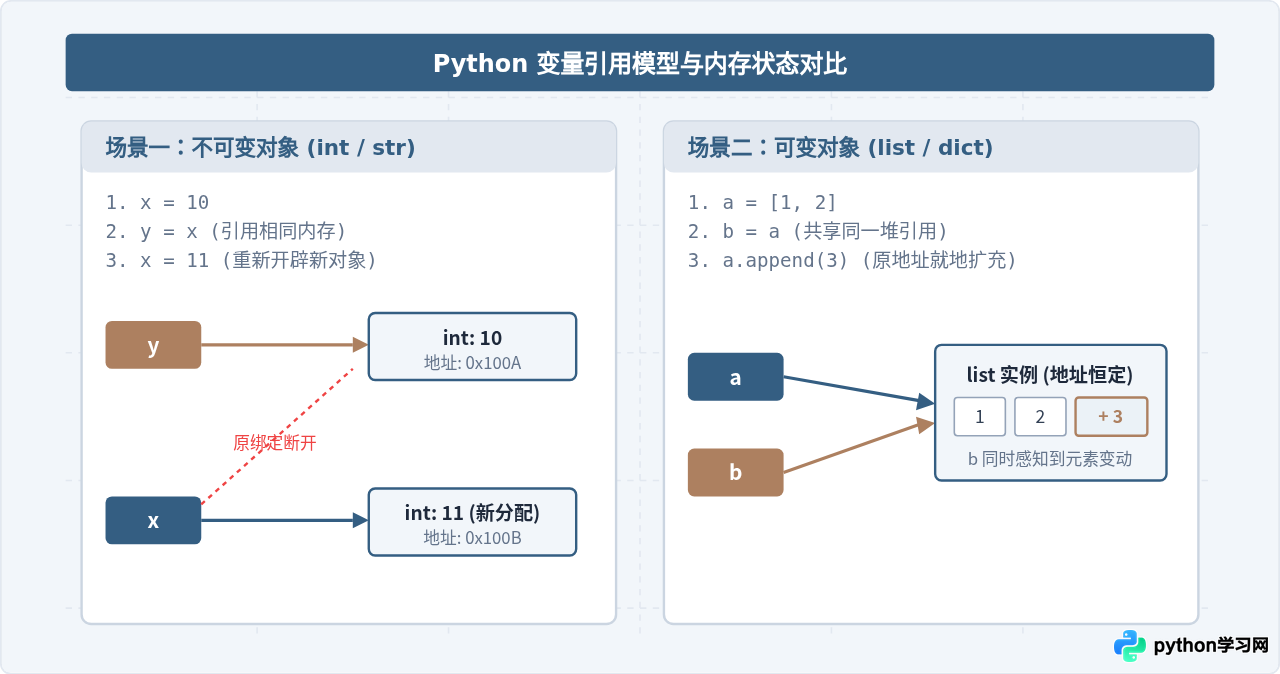
在 C 或 Java 等静态语言中,声明变量如同划分固定大小的盒子,变量名即是内存容器;但在 Python 中,变量只是贴在对象上的标签(Reference)。对象在堆内存中独立分配,包含类型标识、引用计数与具体数值。当执行 a = 100 时,Python 解释器先在内存创建整型对象 100,再将名字 a 绑定到该对象的内存地址。
理解变量的第一步是明确不可变对象(Immutable)与可变对象(Mutable)的差异:
- 不可变对象:数值(int、float、bool)、字符串(str)、元组(tuple)。一旦创建,其内部状态不可变更。任何修改操作(如字符串拼接、数值重计算)都会在内存中生成全新对象,并让变量指向新地址。
- 可变对象:列表(list)、字典(dict)、集合(set)。对象所分配的内存块允许就地(In-place)扩充、修改或移除元素,变量持有的引用地址保持不变。
判断两个变量关系的内置工具有两个:== 比较对象包含的值是否等价,而 is 比较两者引用的内存地址是否相同(即 id(a) == id(b))。
二、核心内置数据类型体系
Python 具备丰富的内置数据结构,合理选择容器类型能够直接决定代码的执行效率与逻辑清晰度。以下对常用的六种核心类型进行归纳:
| 类型标识 | 类型分类 | 可变性 | 有序性 | 典型定义与用途 |
|---|---|---|---|---|
int / float / bool |
数值标量 | 不可变 | 无 | count = 10, pi = 3.14, flag = True,基础代数与状态逻辑 |
str |
文本序列 | 不可变 | 有序 | name = "Python",文本存储,支持切片与格式化 |
list |
通用序列 | 可变 | 有序 | items = [1, "two", 3.0],动态元素增删查改 |
tuple |
只读序列 | 不可变 | 有序 | coords = (10, 20),固定元数据传递、字典有效键 |
dict |
键值映射 | 可变 | 有序(3.7+插入序) | user = {"id": 1, "role": "admin"},基于哈希的键值快速检索 |
set |
唯一集合 | 可变 | 无序 | tags = {"dev", "ops"},快速去重与交并差运算 |
1. 序列索引与切片规则
对于 str、list 和 tuple 这类有序序列,Python 支持正负双向索引与灵活切片。切片语法为 sequence[start:stop:step],原则是左闭右开(包含 start,但不包含 stop):
s = "HelloPython"
print(s[0])       # 'H'(正向首位)
print(s[-1])      # 'n'(逆向首位)
print(s[0:5])     # 'Hello'(截取索引 0 到 4)
print(s[::-1])    # 'nohtyPolleH'(步长为 -1 实现逆序)
2. 散列类型与键的约束条件
dict 的查找时间复杂度平均为 \(O(1)\),其底层依赖哈希表。因此,字典的键(Key)以及集合(Set)的成员必须是可哈希(Hashable)对象。在 Python 中,所有内置不可变类型均实现了 __hash__ 方法,因而可以作为键;而 list、dict、set 等可变对象不可哈希,不能作为键:
valid_dict = {(1, 2): "coordinates"}  # 正确:tuple 是不可变类型,可作为键
invalid_dict = {[1, 2]: "coordinates"} # 报错:TypeError: unhashable type: 'list'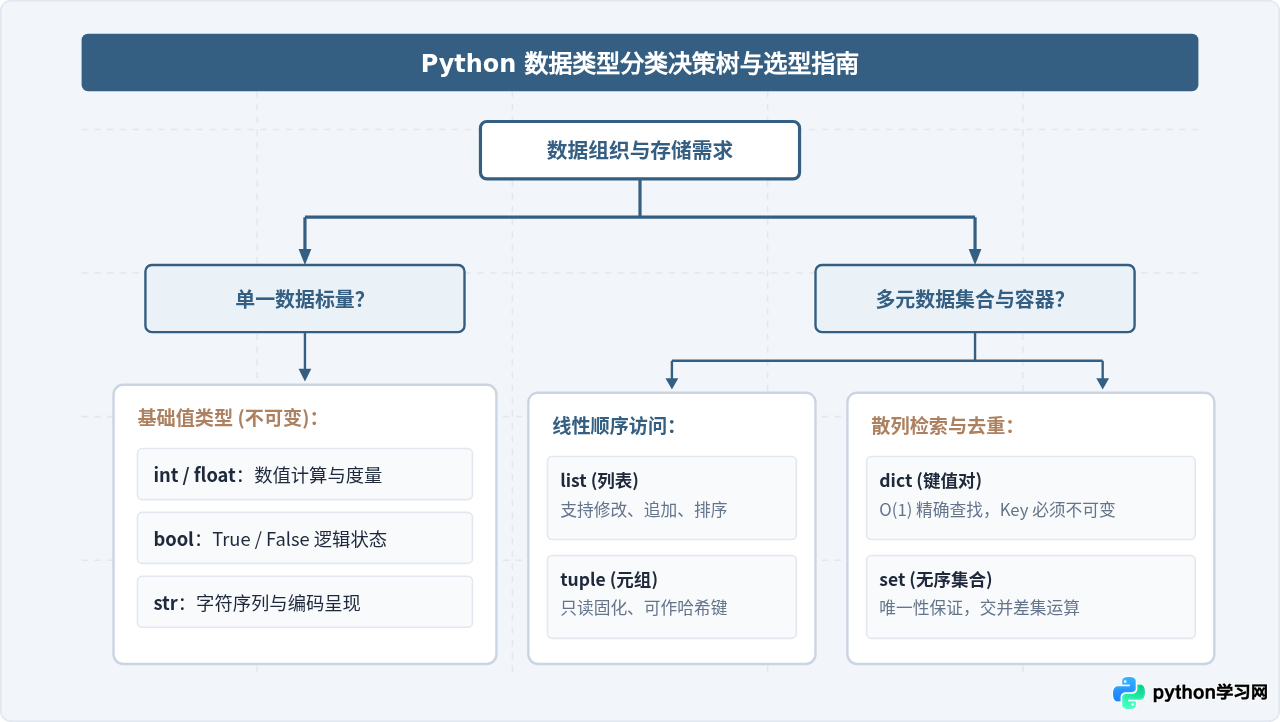
三、分支控制流:条件判断与逻辑求值
程序执行的基础分支由 if-elif-else 结构实现。Python 通过严格的代码缩进确定代码块归属,去除了花括号的冗余。编写条件逻辑时,核心关注以下两项底层机制:
1. 真值测试(Truthy & Falsy)
在 Python 的条件表达式中,不仅 bool 类型的变量可以直接作为判断条件,任何对象均拥有其布尔真值。以下对象在条件求值时均视作假(Falsy):
- 常量:
None、False - 数值零值:
0、0.0、Decimal(0) - 空容器与空序列:
""(空字符串)、[](空列表)、()(空元组)、{}(空字典)、set()(空集合)
符合 Pythonic 风格的代码会直接利用容器的真值特性,避免冗长的长度校验:
tasks = []

# 推荐写法:直接利用空列表为 Falsy 的特性
if not tasks:
    print("任务队列已空")

# 不推荐写法:冗余的长度比较
if len(tasks) == 0:
    print("任务队列已空")
2. 逻辑运算符与短路求值(Short-circuit Evaluation)
逻辑运算 and 和 or 严格遵循短路原则:
expr1 and expr2:如果expr1为假,立即返回expr1的值,不再计算expr2。expr1 or expr2:如果expr1为真,立即返回expr1的值,跳过expr2。
这个特性常用于安全防御式编程,例如前置检查对象是否存在以避免空指针类错误:
user = None
# 若 user 为 None,短路机制阻止了 user.name 的求值,从而不会引发 AttributeError
if user is not None and user.name == "Admin":
    print("通过身份验证")
四、循环控制流与中断机制
Python 主要提供两种循环方式:基于迭代协议的 for...in 循环,以及基于状态布尔值的 while 循环。
1. 常用迭代模式
for 循环本质上是通过内置的迭代器依次拉取序列中的元素,常见的内置辅助函数包括:
range(start, stop, step):惰性生成整数序列,节省内存开销。enumerate(iterable, start=0):同步产出索引号与元素,避免手动维护计数器变量。zip(iter1, iter2):聚合多个可迭代对象,并行按对提取元素。
names = ["Alice", "Bob", "Charlie"]
for idx, name in enumerate(names, start=1):
    print(f"序号 {idx}: {name}")
2. 中断控制:break、continue 与 else 结构
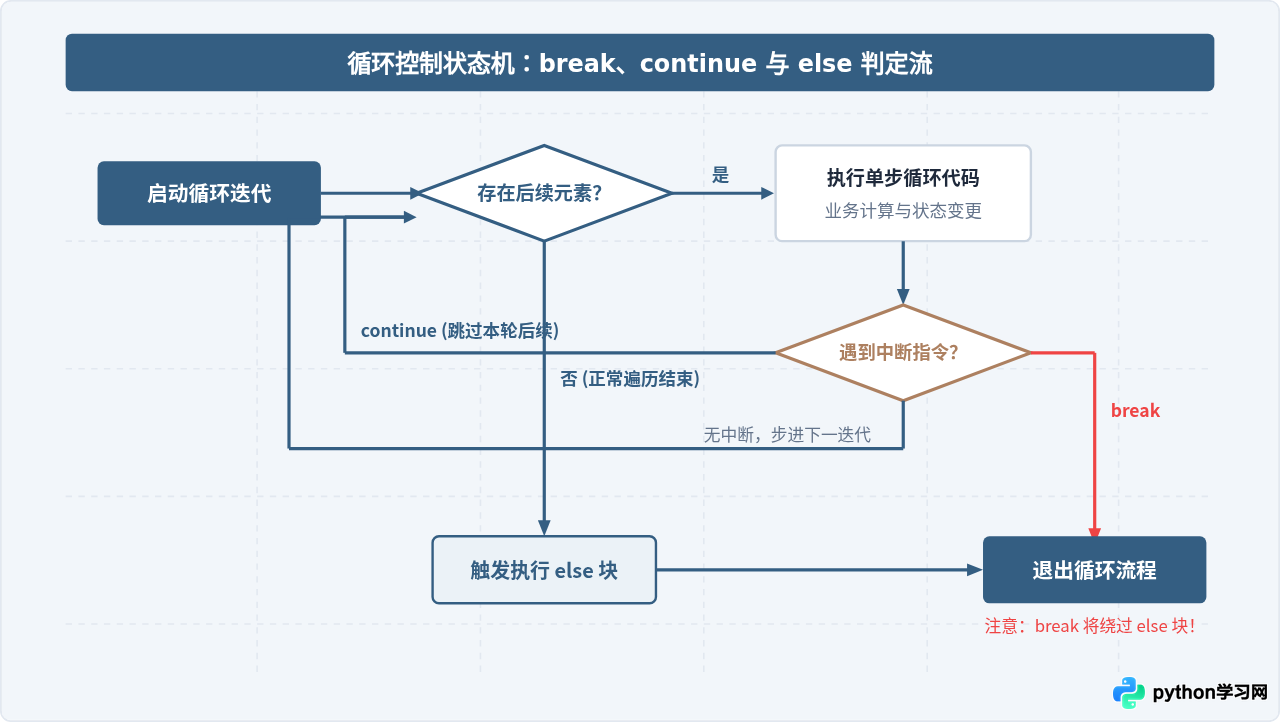
在循环体内,break 与 continue 承担着流程跳转的任务:
break:强制提前终止并跳出当前层级的整个循环。continue:立即跳过本次循环剩余代码,直接进入下一次迭代判断。- 循环自带的
else子句:这是 Python 特色语法——当循环正常遍历结束(没有被break提前打断)时,会执行else块中的语句。这在“搜索某个满足条件的项,未找到时执行备选逻辑”时尤为简洁。
五、基础阶段三大高频陷阱与规避策略
掌握基础语法只是起点,了解常见的边缘情况与陷阱能够避免大量排错时间:
陷阱一:默认参数陷阱(Default Mutable Argument)
在函数定义中使用可变对象(如 def append_item(val, target=[]))作为默认参数时,该默认列表只在函数定义阶段创建一次,而不是每次调用时重新生成。多次调用将导致数据累积污染。
规避方案:始终使用 target=None 作为哨兵值,并在函数内部通过 if target is None: target = [] 完成初始化。
陷阱二:迭代过程中修改正在遍历的列表
在 for x in my_list: 内部直接执行 my_list.remove(x) 会破坏底层的索引游标,导致部分元素被漏判。
规避方案:遍历原列表的浅拷贝切片 for x in my_list[:]:,或使用列表推导式直接生成过滤后的新列表。
陷阱三:嵌套容器的浅拷贝(Shallow Copy)
使用 list.copy() 或切片 [:] 仅复制了最外层容器,内部嵌套的子列表依然共享同一内存引用。
规避方案:若需要完全隔离复合嵌套数据,应引入标准库模块调用 copy.deepcopy()。
六、全景知识体系总结与后续进阶路径
从底层的内存标签机制,到六大核心数据类型的特性分类,再到控制流的严谨跳转,构成了 Python 程序设计的基石。理解“对象在堆中、变量是指针、容器按哈希或连续地址组织、循环依迭代协议运行”这一底层逻辑,能够帮助开发者从根本上避免语法死记硬背。
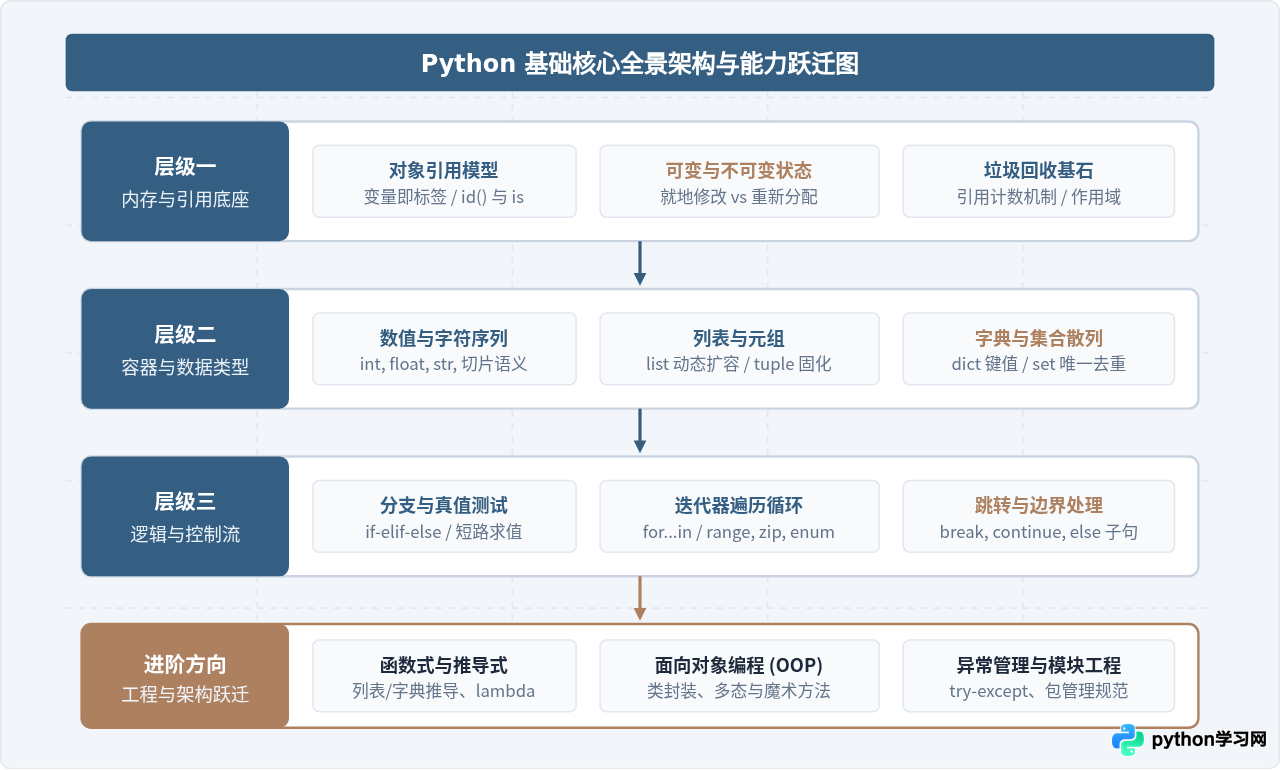
完成控制流的掌握后,建议下一步聚焦于函数封装、推导式与异常防御,逐步将离散的基础知识点组织为结构严谨、具备容错能力的模块化程序。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















