


Python for循环语法详解:遍历列表、字典与range()用法
深入解析Python中for循环的底层运行机制与实际使用方法,涵盖列表遍历、字典键值读取、range()步长控制、enumerate与zip技巧,以及安全修改和for-else语法的避坑指南。
Python 的 for 循环本质上是一个基于迭代协议的集合遍历器,不同于 C/C++ 等语言中基于计数器的 for(int i=0; i<n; i++) 结构。在 Python 中,只要一个对象是可迭代的(Iterable),for 循环就能直接取出其中的每个元素进行处理。本文系统拆解 for 循环的核心底层工作流,并针对日常开发中最为高频的列表遍历、字典访问与 range() 序列生成给出标准写法、进阶函数(enumerate/zip)与避坑指南。
一、for 循环的核心执行逻辑与语法结构
在 Python 中,for 循环的基本语法如下:
for 目标变量 in 可迭代对象:
    循环体代码块
else:
    循环正常结束时执行的代码块(可选)
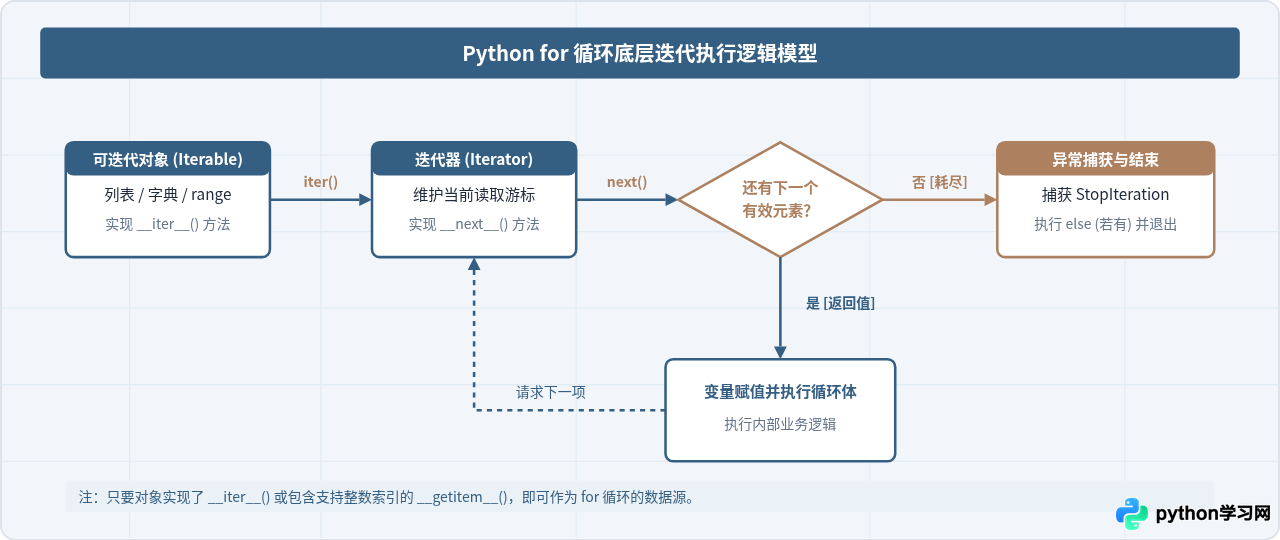
表面上看,解释器只是在逐项赋值;但在底层,Python 遵循着严格的迭代器协议(Iterator Protocol):
- 当执行
for item in iterable:时,解释器首先调用内置函数iter(iterable),从可迭代对象中获取一个独立的迭代器对象。 - 在随后的每轮循环中,解释器对该迭代器调用
next(iterator),将返回的值绑定到目标变量上,随后执行循环体代码。 - 当所有元素被取完后,迭代器会主动抛出
StopIteration异常。 - Python 内部自动捕获这个异常并平稳退出循环。如果定义了
else子句且循环未被break中断,此时将执行else代码块。
二、遍历列表(List):直接访问、索引与并行迭代
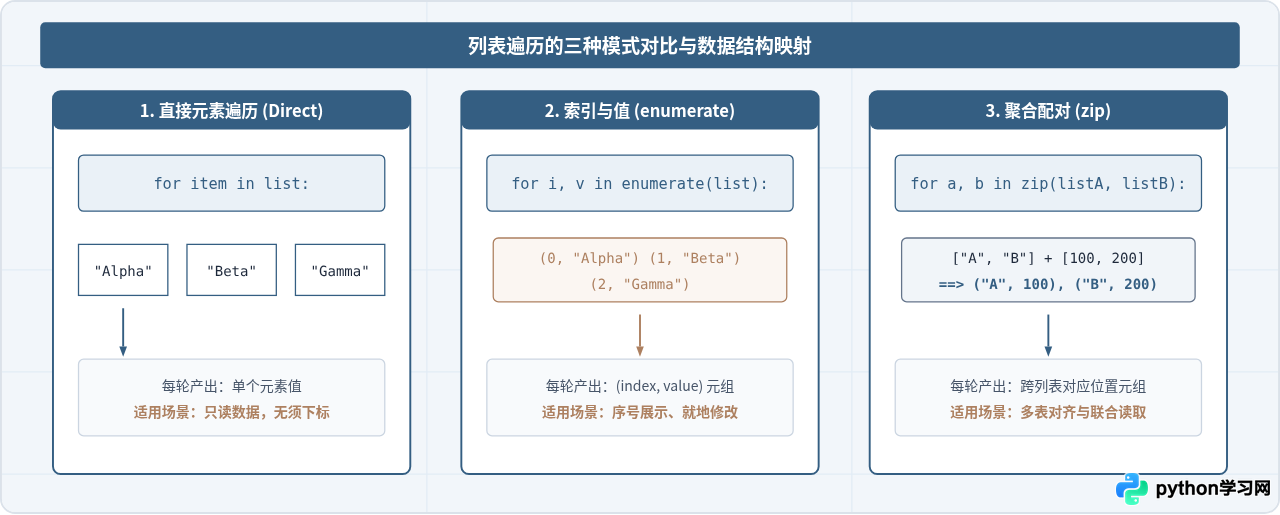
列表是 Python 中最常用的有序容器。在实际编码中,针对不同的业务需求,列表遍历主要有三种实现形式。
1. 直接遍历元素(首选方式)
当你只需要读取列表内的具体数据而不需要元素下标时,直接遍历具有最高的执行效率与代码可读性:
servers = ["web-node-01", "web-node-02", "db-primary"]

for server in servers:
    print(f"正在检查节点状态: {server}")
正在检查节点状态: web-node-02
正在检查节点状态: db-primary
2. 需要索引时的标准解法:enumerate()
初学者容易写出类似 for i in range(len(servers)): 的写法,这种方式在 Python 中被视为“反模式”(Anti-pattern),不仅冗长,而且多次通过索引寻址会降低执行效率。Python 提供了内置的 enumerate() 函数,它在迭代时同时产出 (索引, 元素) 元组:
tasks = ["环境初始化", "依赖校验", "服务启动"]

# start 参数可指定索引起始值(默认为 0,此处指定为 1)
for index, task in enumerate(tasks, start=1):
    print(f"步骤 {index}: {task}")
步骤 2: 依赖校验
步骤 3: 服务启动
3. 并行遍历多个列表:zip()
当需要同时处理两个或多个长度相关的列表时,使用 zip() 函数可以将多个可迭代对象对应位置的元素打包成元组:
users = ["Alice", "Bob", "Charlie"]
roles = ["Admin", "Developer", "Tester"]

for user, role in zip(users, roles):
    print(f"用户: {user} -> 权限角色: {role}")
用户: Bob -> 权限角色: Developer
用户: Charlie -> 权限角色: Tester
如果在遍历列表的同时删除元素,列表底层数组会前移填补空缺,但循环迭代器内部的索引仍在自增,这将直接导致部分元素被跳过漏判。解决该问题的安全方法有两种:
- 使用列表推导式或 filter 生成新列表(推荐):
filtered = [x for x in nums if x % 2 == 0] - 针对列表切片副本进行迭代:
for x in nums[:]: if cond: nums.remove(x)
三、遍历字典(Dictionary):键、值与键值对
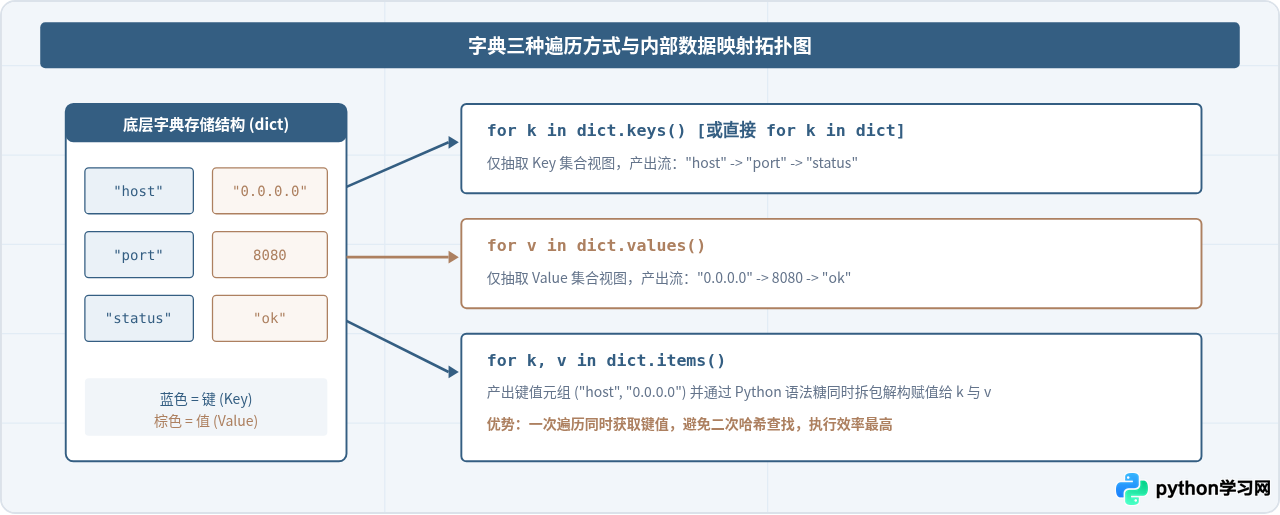
字典是基于哈希表实现的键值对容器。Python 字典提供了三种视图对象用于遍历:keys()、values() 以及 items()。
1. 默认遍历:仅获取键(Key)
当直接将字典变量传给 for 循环时,Python 默认会遍历其所有的键:
config = {"host": "127.0.0.1", "port": 8080, "timeout": 30}

# 写法等价于 for key in config.keys():
for key in config:
    print(f"键: {key} -> 值: {config[key]}")
2. 仅遍历值:values()
如果业务只关心字典中保存的数值,可以直接调用 .values() 方法跳过键的读取:
scores = {"math": 95, "english": 88, "physics": 92}

total_score = 0
for score in scores.values():
    total_score += score
print(f"总分为: {total_score}")3. 同时遍历键和值:items()(最常用推荐)
在同时需要键名与对应取值时,最地道的写法是使用 .items() 结合元组解包。该方法避免了循环内部二次哈希查找 dict[k] 的开销:
system_info = {"OS": "Ubuntu 22.04", "Kernel": "Linux 5.15", "Arch": "x86_64"}

for key, value in system_info.items():
print(f"[{key}]: {value}")[Kernel]: Linux 5.15
[Arch]: x86_64
如果在遍历字典时动态执行 dict[new_key] = val 或 del dict[k],Python 会直接抛出:
RuntimeError: dictionary changed size during iteration。
若必须在循环过程中新增或删除键,应先调用 list(config.keys()) 固化快照后再进行循环:
for key in list(config.keys()):
    if key.startswith("temp_"):
        del config[key]
四、range() 函数的参数规则与循环控制
range() 是 Python 3 内置的不可变序列类型。它并不会在内存中直接创建包含全部数字的列表,而是根据需要动态计算数值,因此即使生成一个非常庞大的区间(如 range(100000000)),所占用的内存空间也是恒定不变的(O(1) 空间复杂度)。
1. 三种参数签名与左闭右开区间
range() 函数支持 1 到 3 个整数参数,所有区间均为左闭右开(包含起始值,但不包含结束值):
| 调用形式 | 参数含义 | 产生序列示例 | 说明 |
|---|---|---|---|
range(stop) |
仅指定结束值 | range(5) → 0, 1, 2, 3, 4 |
起始值默认为 0,步长默认为 1 |
range(start, stop) |
指定起始与结束值 | range(2, 6) → 2, 3, 4, 5 |
从 start 开始,步长默认为 1 |
range(start, stop, step) |
指定起始、结束及步长 | range(1, 10, 2) → 1, 3, 5, 7, 9 |
每次增加 step,可用于跳跃取值 |
2. 倒序遍历与负步长用法
当需要从大到小倒序遍历时,步长 step 必须设为负数,同时起始值必须大于结束值:
# 倒计时循环:从 5 递减到 1
for i in range(5, 0, -1):
    print(f"倒计时: {i}")
倒计时: 4
倒计时: 3
倒计时: 2
倒计时: 1
五、流程控制与 for-else 守卫模式
在循环体内部,可以通过控制语句提前干预循环的流向:
continue:立即跳过当前轮次的剩余代码,进入下一轮迭代。break:强制提前彻底终止整个循环,跳出for结构。
for...else 结构的独特设计
许多从其他编程语言转到 Python 的开发者常对 for...else 结构感到困惑。其核心规则非常明确:
只有当 for 循环完整遍历完所有元素、没有遭遇 break 中途退出时,else 代码块才会执行。一旦被 break 终止,else 就会被完全忽略。
该机制极为适合用来编写“查找与守卫”逻辑,避免引入额外的布尔标记变量(如 found = False):
ports = [8080, 8081, 8082, 8083]
target_port = 9000

for port in ports:
    if port == target_port:
        print(f"找到目标服务端口: {port}")
        break
else:
    # 循环完整遍历未发现目标时自动触发
print(f"警告:未在配置列表中找到指定端口 {target_port}")六、循环遍历场景选型与速查总结
在实际工程开发中,根据数据结构与业务需求选择最合适的循环方式,可以显著提升代码的鲁棒性与运行效率。
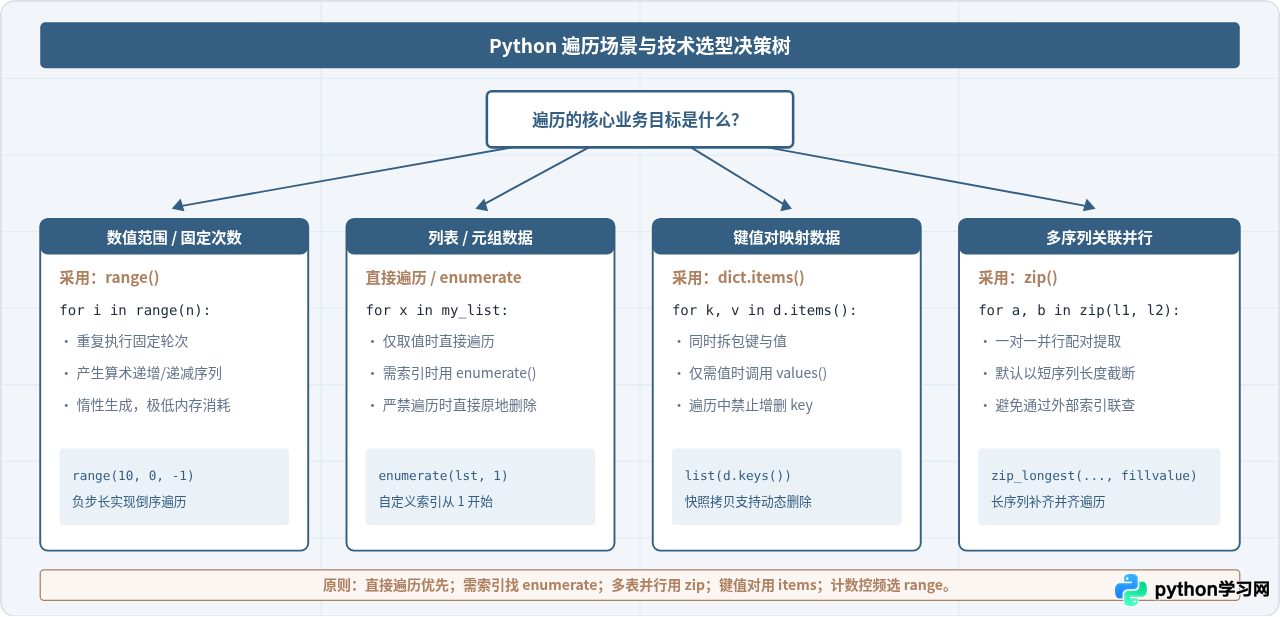
掌握上述核心概念与典型范式后,日常编程中大部分集合处理、数据转换和批量任务都能写得既清晰又稳健。遇到循环性能瓶颈或多维嵌套时,也可以进一步结合列表推导式或生成器表达式进行重构,编写出符合 Pythonic 风格的高质量代码。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















