


Python开发工程师岗位职责与核心技能要求详解
详细解析Python开发工程师的岗位职责定位、必备核心技能树、主流技术栈应用场景及能力评估标准,帮助读者清晰掌握Python工程化落地与职业进阶路径。
一、Python开发工程师的核心岗位职责
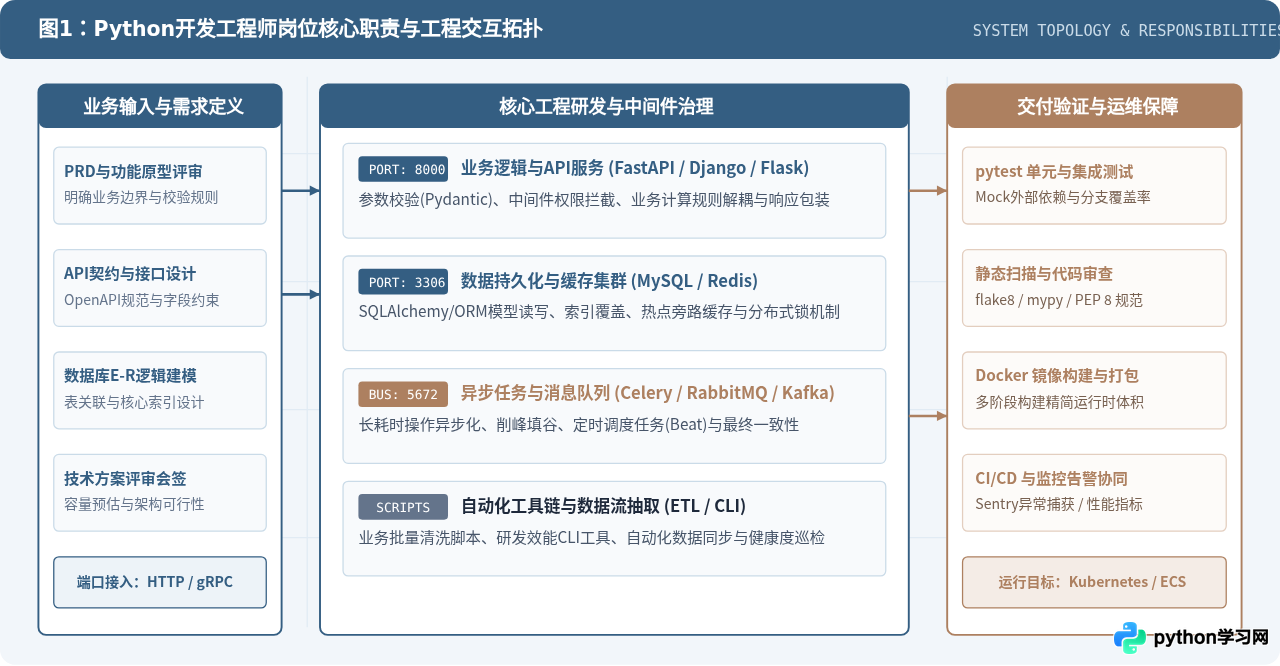
在企业的研发协作体系中,Python开发工程师不仅要完成代码编写,更需要参与从需求分析到生产运维的全生命周期。其核心工作可划分为六大维度:
1. 业务系统与API接口开发
负责业务功能模块的逻辑实现,基于RESTful规范或RPC协议设计并输出标准化的API接口。日常工作包括请求参数验证、数据模型转换、业务规则判断、统一异常拦截与OpenAPI接口文档维护,确保前端、移动端或第三方平台能够稳定、高效地对接服务。
2. 数据库设计与读写性能优化
根据业务场景完成关系型数据库(如MySQL、PostgreSQL)的数据表结构设计与E-R关系建模。熟练运用ORM框架(如SQLAlchemy、Tortoise-ORM或Django ORM)进行数据操作,同时负责复杂SQL编写、索引创建、执行计划(EXPLAIN)分析以及慢查询治理,避免全表扫描或连接池耗尽。
3. 异步任务与高并发流量解耦
对于耗时较长的操作(如邮件/短信下发、文件导出、外部接口轮询、数据汇总计算等),通过Celery、RabbitMQ或Kafka构建异步任务队列与事件总线,实现核心接口的快速响应与业务解耦,并保障任务在异常重试与分布式节点下的幂等性执行。
4. 内部自动化工具与研发脚本研发
发挥Python在脚本化与生态工具上的优势,编写自动化数据抽取、清洗、批处理及格式转换脚本;或针对研发和测试团队的痛点开发内部CLI命令行工具、Mock服务与运维辅助脚本,提升整个工程团队的交付效率。
5. 代码质量保证与工程测试规范
严格执行代码规范(如PEP 8、flake8、black),编写高覆盖率的单元测试与集成测试(使用pytest框架),利用Mock技术隔离外部数据库与网络依赖,积极参与团队Code Review,从源头消灭死锁、内存泄露与安全注入漏洞。
6. 系统部署、环境维护与线上故障排查
配合DevOps完成应用容器化打包(编写规范的Dockerfile),维护基础配置文件与环境变量。在生产出现突发故障时,利用Linux系统命令、日志收集平台(如ELK)与应用性能监控系统(APM)迅速定位性能瓶颈与异常堆栈并完成热修复。
二、Python开发工程师核心技能要求
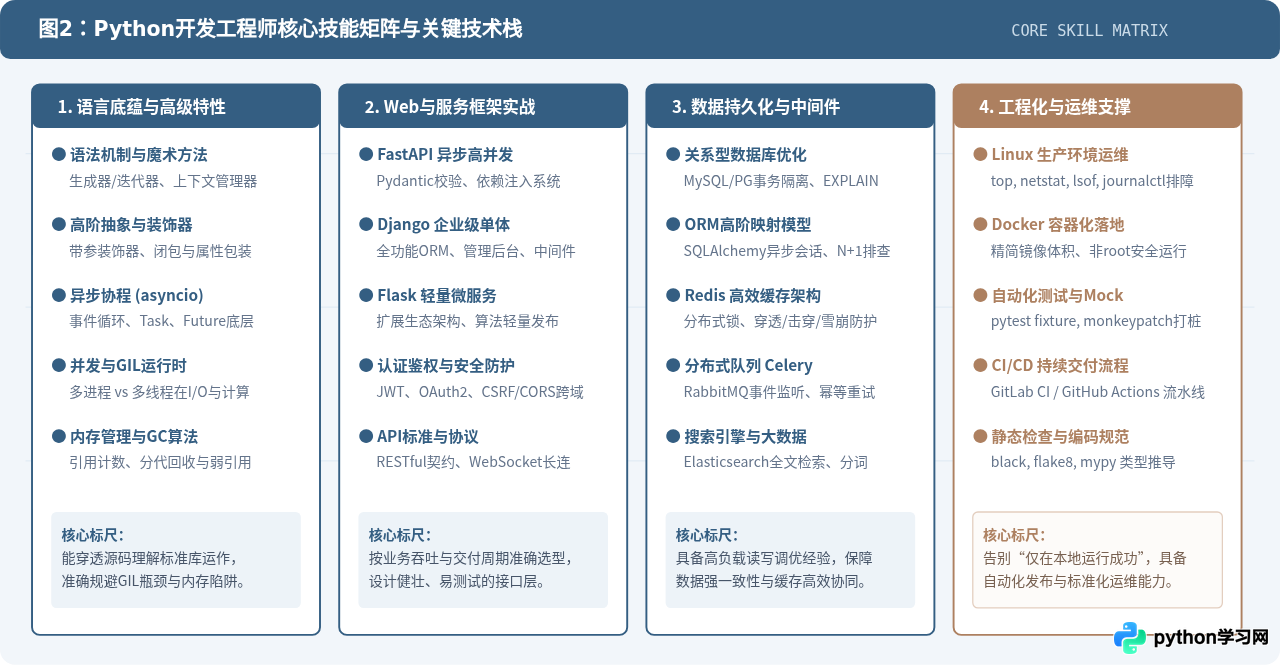
要胜任上述岗位职责,工程师需要在语言底层、框架选型、数据存储及工程化四个层面具备扎实的专业积累。以下为技术栈深度拆解:
1. Python语言基石与高级机制
- 面向对象与元编程:熟练运用类属性、实例属性、魔术方法(如
__call__、__enter__、__exit__实现上下文管理器)、描述符协议及抽象基类(abc.ABCMeta)。 - 迭代器与生成器:深刻理解迭代器协议,熟练使用
yield及生成器表达式处理海量流式数据,降低内存开销。 - 高阶函数与装饰器:能够独立编写带参装饰器、类装饰器,用于实现接口鉴权、日志追踪、执行耗时打点及缓存自动注入。
- 并发机制与GIL本质:明确全局解释器锁(GIL)对多线程CPU密集型计算的限制。在I/O密集型任务中合理采用
asyncio事件循环或threading;在CPU密集型任务中运用multiprocessing或底层C/Rust扩展。 - 内存管理与GC回收:掌握引用计数机制、标记清除(Mark-Sweep)与分代回收算法(Generations),避免循环引用导致的内存泄露。
2. 主流Web框架与微服务工程
现代Python后端开发已逐步从传统单体过渡到高性能异步微服务。掌握各框架的设计理念与适配场景是核心能力之一:
- FastAPI:现代高并发接口首选,依托Starlette与Pydantic,原生支持异步
async/await、类型提示(Type Hints)、依赖注入系统及自动生成交互式OpenAPI文档。 - Django:大型企业级项目与快速交付利器,具备开箱即用的ORM、自带Admin管理后台、完善的中间件、表单处理与会话安全机制。
- Flask:轻量级微框架,架构极简、扩展自由度高,适合编写轻量级微服务、内部工具后端或算法模型推理服务。
3. 数据存储与分布式中间件
- 关系型数据库:掌握MySQL或PostgreSQL的事务ACID特性、事务隔离级别(RC、RR)及MVCC机制;具备索引设计原则(最左前缀匹配、覆盖索引)与执行计划调优能力。
- NoSQL与缓存治理:熟练运用Redis核心数据结构(String、Hash、List、Set、ZSet),掌握缓存穿透、缓存击穿、缓存雪崩的应对策略,实现基于Lua脚本的分布式锁与限流算法。
- 分布式任务队列:精通Celery架构(Broker、Worker、Backend),处理任务路由、重试退避机制、预取限制(prefetch multiplier)与定时任务调度。
4. 交付工程化与DevOps协作
- 版本控制与代码审查:熟练遵循Git Flow或Trunk-Based分支管理规范,能够编写语义清晰的Commit信息并高质量完成合并请求(PR/MR)。
- 容器化与编排:编写高质量Dockerfile,采用多阶段构建精简镜像体积,熟悉
docker-compose本地服务编排,理解Kubernetes的Pod、Service等基本部署资源。 - 自动化测试:精通
pytest框架的fixture依赖夹具、参数化测试(@pytest.mark.parametrize)与Mock打桩技术,确保核心业务代码分支覆盖率达标。
三、主流细分方向的职责差异与技术选型决策
虽然基础语言相同,但在不同业务场景下,Python工程师的侧重点存在明显差异。下表对比了三大典型细分方向的核心差异:
| 细分研发方向 | 主要服务对象与业务场景 | 核心技术栈 | 岗位核心挑战 |
|---|---|---|---|
| Web后端 / 微服务开发 | 面向C端APP、B端SaaS平台、开放开放接口平台 | FastAPI, Django, MySQL, Redis, Celery, Docker | 高并发读写、接口低延迟响应、数据一致性与服务解耦 |
| 数据开发 / ETL工程 | 数仓建设、报表分析、流式数据管道抽取与清洗 | Pandas, PySpark, Airflow, ClickHouse, Kafka | 大吞吐数据批处理性能、分布式计算资源调度、数据清洗准确性 |
| 自动化运维 / DevOps开发 | 内部云平台管控、CI/CD平台、CMDB、监控告警中台 | Flask, Ansible, Kubernetes SDK, Prometheus, Shell | 基础设施API打通、跨云多集群调度、高可用与高安全审计 |
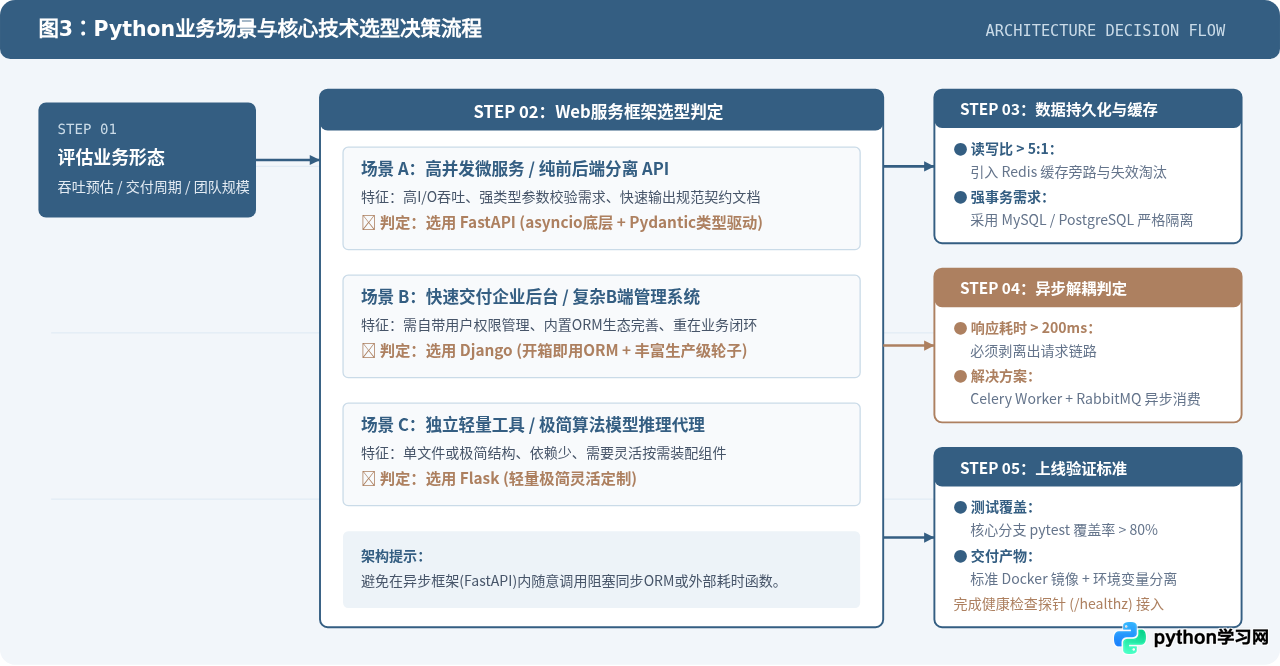
在面对具体业务需求时,技术选型不可盲目追新。应依据并发量、团队背景、交付周期建立标准决策链:
四、规范范式与生产避坑实践
为了让技能要求具体落地,以下展示一段符合现代生产标准的Python后端代码范式。该示例使用FastAPI + Pydantic + 异步SQLAlchemy,完整呈现了类型约束、数据库异步连接生命周期管理及统一异常处理:
# 生产环境标准异步接口示例:用户创建与查询接口
from typing import AsyncGenerator
from fastapi import FastAPI, Depends, HTTPException, status
from pydantic import BaseModel, Field, EmailStr
from sqlalchemy.ext.asyncio import AsyncSession, create_async_engine, async_sessionmaker
from sqlalchemy.orm import DeclarativeBase, Mapped, mapped_column
from sqlalchemy import select

# 1. 数据库异步引擎与连接池配置
DATABASE_URL = "sqlite+aiosqlite:///./production_demo.db"
engine = create_async_engine(DATABASE_URL, echo=False, pool_size=10, max_overflow=20)
AsyncSessionFactory = async_sessionmaker(engine, expire_on_commit=False)

class Base(DeclarativeBase):
    pass

class UserModel(Base):
    __tablename__ = "users"
    id: Mapped[int] = mapped_column(primary_key=True, autoincrement=True)
    username: Mapped[str] = mapped_column(unique=True, index=True)
    email: Mapped[str] = mapped_column(unique=True)
    is_active: Mapped[bool] = mapped_column(default=True)

# 2. 会话生命周期依赖注入项
async def get_db_session() -> AsyncGenerator[AsyncSession, None]:
    async with AsyncSessionFactory() as session:
        try:
            yield session
            await session.commit()
        except Exception:
            await session.rollback()
            raise

# 3. Pydantic 输入与输出契约模型
class UserCreateRequest(BaseModel):
    username: str = Field(..., min_length=3, max_length=32, description="用户唯一标识")
    email: EmailStr = Field(..., description="合法的电子邮箱地址")

class UserResponse(BaseModel):
    id: int
    username: str
    email: EmailStr
    is_active: bool

    class Config:
        from_attributes = True

# 4. 路由处理与业务逻辑
app = FastAPI(title="User Service API", version="1.0.0")

@app.post("/api/v1/users", response_model=UserResponse, status_code=status.HTTP_201_CREATED)
async def create_user(
    payload: UserCreateRequest,
    session: AsyncSession = Depends(get_db_session)
):
    # 重名检测
    stmt = select(UserModel).where(UserModel.username == payload.username)
    existing_user = (await session.execute(stmt)).scalar_one_or_none()
    if existing_user:
        raise HTTPException(
            status_code=status.HTTP_400_BAD_REQUEST,
            detail="用户名已存在,请更换后重试"
        )

    new_user = UserModel(username=payload.username, email=payload.email)
    session.add(new_user)
    await session.flush()
    await session.refresh(new_user)
return new_user- 慎用函数可变默认参数:在定义函数时切勿使用
def add_item(val, target=[]),因为默认列表在模块加载时只初始化一次,会在后续调用中持续累加造成逻辑混乱,应使用target=None并在函数体内初始化。 - 异步事件循环中禁止混入同步阻塞调用:在
async def接口中调用time.sleep()或同步文件读写、同步requests.get()会直接冻结整个主线程的事件循环,导致并发吞吐暴跌为1。必须改用asyncio.sleep()或将同步任务移至run_in_executor线程池中运行。 - 严格管理数据库连接池生命周期:避免在每次请求时重新创建数据库连接池,否则不仅消耗大量套接字与内存,还会迅速击垮数据库最大连接数上限。必须全局复用Engine并使用依赖注入按需获取Session。
五、能力进阶路径与评估验证标准
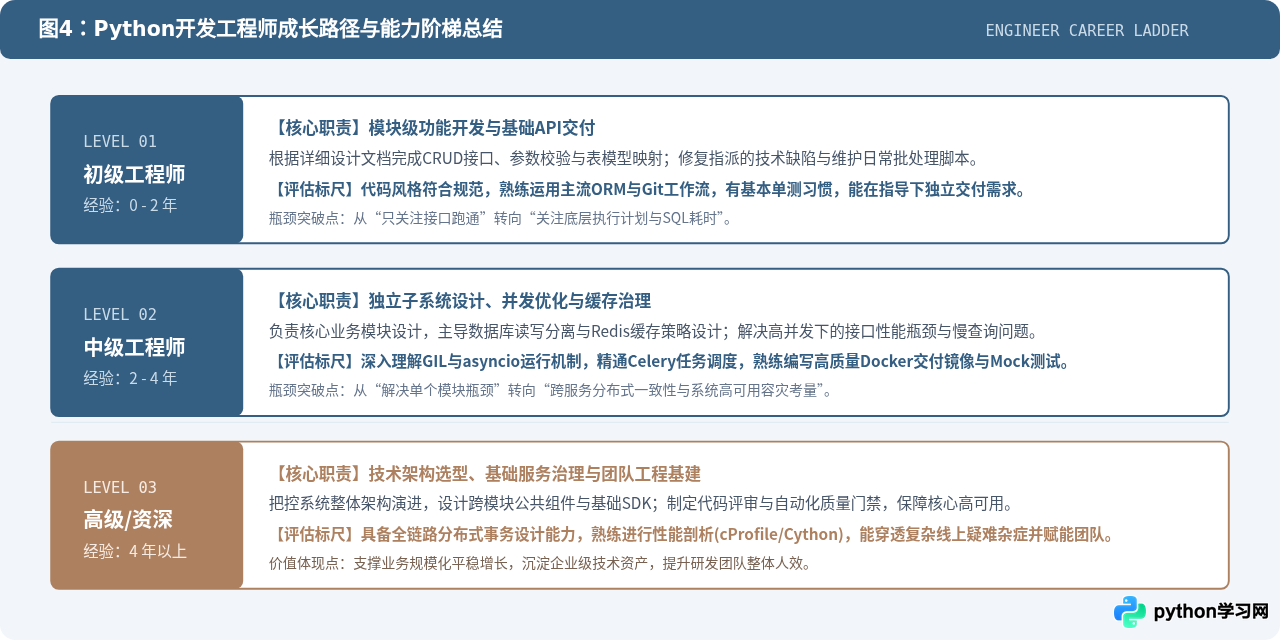
结合企业技术职级评估经验,Python开发工程师的成长通常经历由“按需实现功能”到“全局架构治理”的跃迁。以下为明确的阶段评估阶梯:
结语
Python开发工程师的核心价值不仅在于精通语法糖或编写快捷脚本,更在于以严谨的软件工程思维构建高内聚、低耦合、稳定可靠的企业级服务体系。通过系统掌握语言高级特性、现代异步Web框架、深度数据调优与标准DevOps工程链,工程师便能在日趋激烈的研发竞争中建立扎实的技术护城河。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















