


Python元组和列表在语法定义及操作方法上有何不同
深入对比Python元组与列表在语法定义、内存模型、元素修改、内置方法及适用场景等方面的核心差异,帮助开发者准确选择和使用这两种基础数据结构。
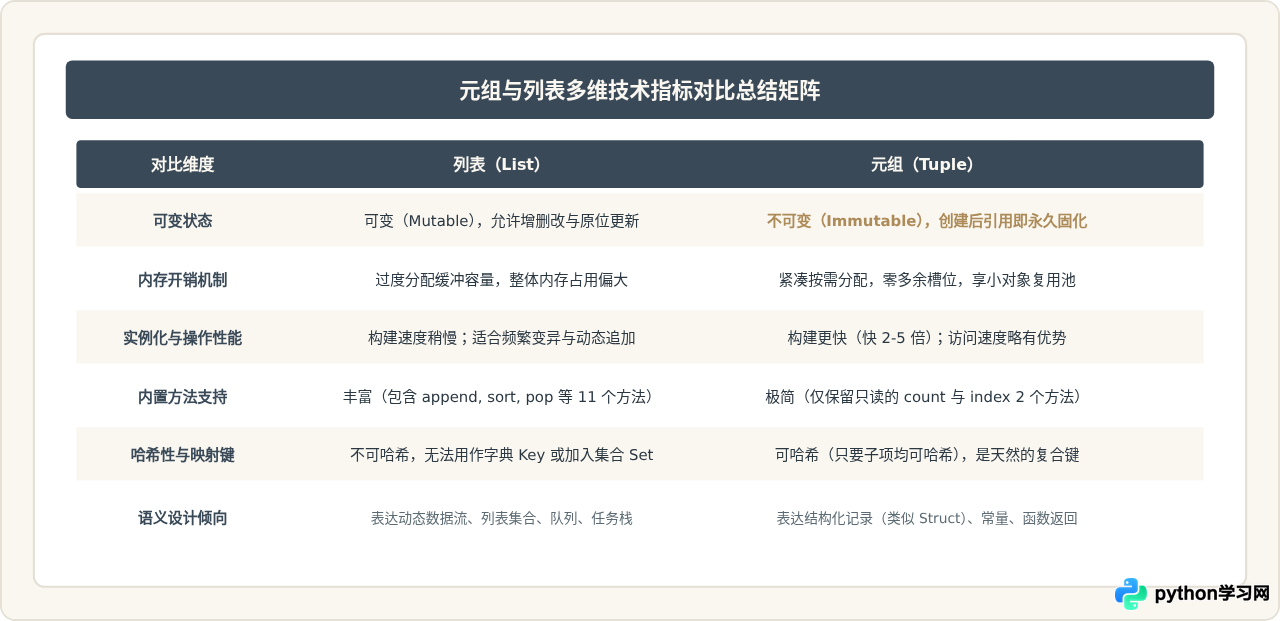
tuple)与列表(list)同属于序列型数据结构,二者最根本的技术分水岭在于可变性(Mutability):列表是可变对象,支持原地位修改、动态追加与任意缩容;元组是不可变对象,一旦分配即固定不可改动。这种底层设计差异不仅决定了它们的语法声明形式与内置方法集合,还在内存分配模型、执行性能及场景语义上形成了明确的分工。
一、语法定义层面的核心差异
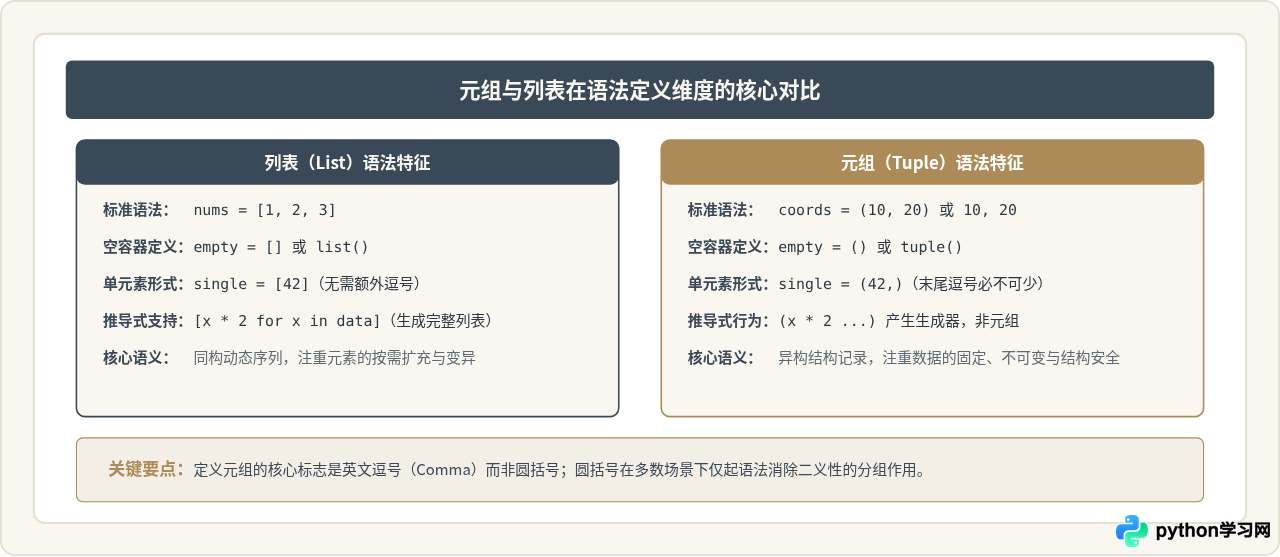
在语法书写上,列表使用方括号 [] 声明,而元组通常使用圆括号 () 或纯逗号分隔来定义。但在实际编码中,两者在空容器、单元素声明以及推导式上存在极易混淆的细节。
1. 字面量声明与单元素“逗号陷阱”
定义多元素容器时,语法的视觉区分非常直观:
# 列表定义:明确依赖方括号
fruits_list = ["apple", "banana", "orange"]

# 元组定义:圆括号可写可省略,逗号是真正决定元组语法的标记
fruits_tuple = ("apple", "banana", "orange")
point_tuple = 10, 20, 30 # 自动封包(Packing)为元组但在定义单个元素时,列表与元组的行为存在本质区别:
- 列表:写为
[42]即可被解析为长度为 1 的列表。 - 元组:如果写成
(42),Python 解释器会将其视作数学优先级表达式中的整数 42,其类型为int;必须在元素后紧跟一个英文逗号写为(42,)或42,,解释器才会将其识别为tuple。
2. 推导式语法差异
Python 原生支持列表推导式(List Comprehension),语法为 [expr for item in iterable],它会在内存中一次性完成计算并直接生成一个新列表对象。
然而,将方括号直接换成圆括号写成 (expr for item in iterable) 并不会生成元组,而是会构造一个生成器表达式(Generator Expression)。若希望通过迭代逻辑快速生成元组,必须显式调用内置工厂函数 tuple(expr for item in iterable)。
二、内存存储模型与可变性底层原理
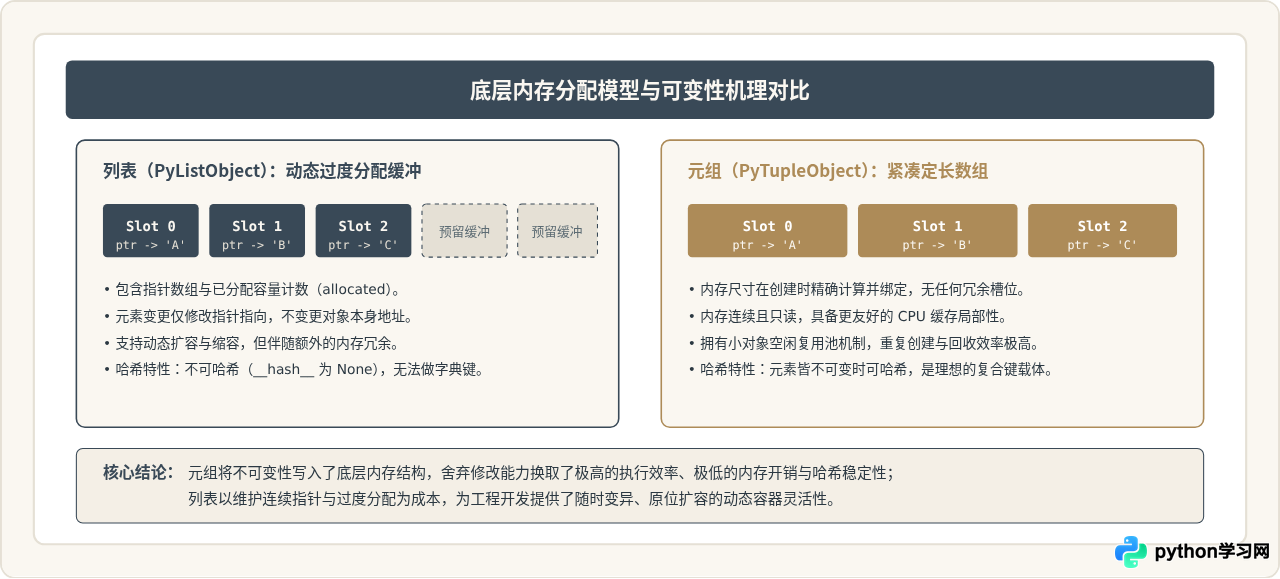
为什么列表可以执行元素增删,而元组不能?答案藏在 CPython 解释器的底层 C 结构实现中。
1. 动态扩容缓冲 vs 紧凑定长分配
在 CPython 内部,列表由 PyListObject 表示,其实质是一个动态指针数组。为了保证使用 append 向尾部追加元素时能达到均摊 $O(1)$ 的时间复杂度,列表采用了“过度分配”(Over-allocation)策略。例如,当一个大小为 4 的列表需要插入第 5 个元素时,Python 不会仅扩充 1 个槽位,而是会按特定比例申请更多内存槽位(如扩容至 8 或更多),未使用的槽位作为缓冲存储。这使得列表通常会持有比当前元素数量更多的内存空间。
相反,元组对应的是 PyTupleObject,属于定长结构体。当元组被实例化时,解释器根据确切的元素数量分配刚好够用的连续内存空间,不包含任何预留的空槽位。因此,元组的内存开销相比同容量的列表更为紧凑,创建效率也更高。
2. 小对象复用与垃圾回收
由于元组是不可变的,CPython 针对空元组和长度较短的元组实现了一套空闲对象复用池(Free List)。当代码中释放一个包含 1 到 20 个元素的元组时,系统并不会直接把内存退还给操作系统,而是将其结构体保留在缓存链表中。下次再次创建相同大小的元组时,可以直接复用该内存块,从而极大降低了内存分配和垃圾回收(GC)的开销。
3. 哈希性(Hashability)与字典键
Python 中的字典(dict)键和集合(set)元素都依赖对象的哈希值(__hash__)。由于列表的内容可变,一旦列表作为键被修改,哈希值变动将导致哈希表索引失效,因此列表被明确定义为不可哈希对象,尝试使用 {[1, 2]: "val"} 会立即抛出 TypeError: unhashable type: 'list'。
元组由于本身不可变,只要其内部包含的所有元素也都是不可变对象(如数字、字符串、其他只包含不可变对象的元组),该元组就是可哈希的,能够安全地用作字典的复合键或集合元素。
三、操作方法与 API 支持度全景对比
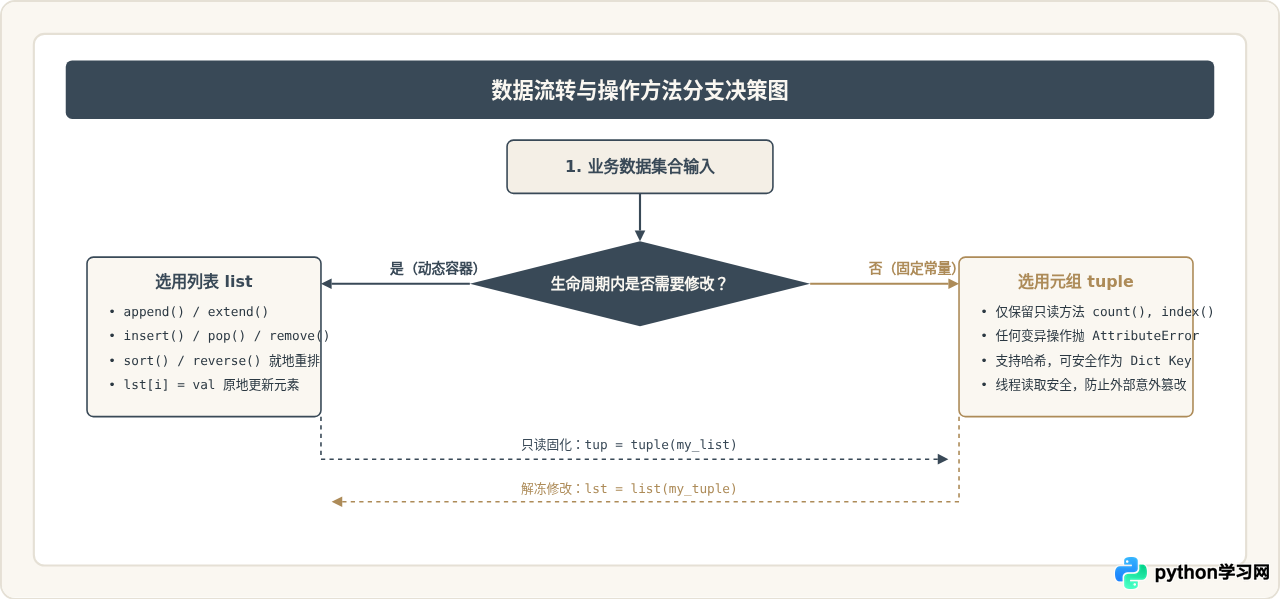
由于底层可变性不同,两者在内置方法上呈现出了巨大差异。列表拥有十余个用于就地变异(In-place Mutation)的专用方法,而元组仅保留最基础的只读查询能力。
1. 共同拥有的只读序列操作
作为 Python 序列(Sequence),列表与元组均完整支持常规的读取与切片语法:
- 正向与负向索引:
seq[0]、seq[-1] - 切片读取:
seq[1:3]、seq[::-1](两者切片均会生成同类型的新对象) - 成员判断:
item in seq、item not in seq - 拼接与重复:
seq1 + seq2、seq * 3(均返回合并后的新序列) - 公共内置函数:
len(seq)、max(seq)、min(seq)、sum(seq) - 内置只读方法:
seq.count(val)统计元素频次、seq.index(val)查找元素首现索引
2. 列表独有的就地修改方法
以下方法只存在于列表中。若在元组对象上调用这些方法,Python 解释器会直接引发 AttributeError:
| 操作类型 | 列表方法 (List) | 元组表现 (Tuple) | 操作行为说明 |
|---|---|---|---|
| 尾部追加 | list.append(x) |
报错 AttributeError | 在列表尾部追加单一元素,原地修改,返回 None |
| 批量合并 | list.extend(iterable) |
报错 AttributeError | 将可迭代对象中的元素逐一追加至尾部 |
| 指定插入 | list.insert(index, x) |
报错 AttributeError | 在指定索引位置插入元素,后续元素后移($O(n)$ 开销) |
| 弹出删除 | list.pop([index]) |
报错 AttributeError | 移除并返回指定索引处的元素(默认末尾) |
| 值删除 | list.remove(x) |
报错 AttributeError | 移除列表中首次出现的特定值,不存在则抛 ValueError |
| 整表清空 | list.clear() |
报错 AttributeError | 清空列表所有元素,重置长度为 0 |
| 就地排序 | list.sort(key=None, reverse=False) |
报错 AttributeError | 直接修改列表内部排列顺序,不生成新列表 |
| 就地反转 | list.reverse() |
报错 AttributeError | 将列表现有元素顺序直接原地倒置 |
四、开发中极易混淆的高频盲区
1. “不可变元组”内部包含可变对象的陷阱
元组的“不可变”指的是其包含的引用(指针)固定不可更改,并不代表指针所指向的具体对象内容不可改变。如果元组内部嵌套了一个列表,列表本身的内容依然能够被自由修改:
# 定义包含列表的元组
mixed_tuple = ("Alpha", [10, 20])

# 尝试替换指针:非法,抛出 TypeError
# mixed_tuple[1] = [30, 40]

# 修改指针指向的对象内容:完全合法!
mixed_tuple[1].append(30)
print(mixed_tuple)
# 输出结果: ('Alpha', [10, 20, 30])因为 mixed_tuple 内部包含了可变对象列表,此时该元组已失去哈希性,如果调用 hash(mixed_tuple),解释器将同样抛出 TypeError: unhashable type: 'list'。
2. += 运算符的底层语义断层
在语法糖 += 上,列表与元组的执行机理有着截然不同的体现:
# 1. 列表的 += :就地扩充(调用 __iadd__)
a = [1, 2]
original_id = id(a)
a += [3]
print(id(a) == original_id)  # True:内存地址完全不变,等价于 a.extend([3])

# 2. 元组的 += :重新构建新对象(退化为 __add__)
t = (1, 2)
original_id = id(t)
t += (3,)
print(id(t) == original_id)  # False:创建了一个全新的元组对象并重新绑定到变量 t
五、工程实践中的选型决策全景
在实际项目架构中,究竟何时使用元组,何时使用列表?我们可以通过以下维度进行快速决断:
- 优先选择元组(Tuple)的场景:
- 函数多返回值:如
def get_location(): return lat, lng,语义清晰且开销极小。 - 结构化异构数据记录:表示具有固定字段意义的数据集(例如数据库查询返回的单行结果
(user_id, username, email),此时亦可考虑collections.namedtuple)。 - 常量配置保护:系统初始化后不允许业务代码意外增减的枚举项或路由白名单。
- 字典键或集合成员:利用其天然哈希性构建多维组合索引(如坐标网格
graph[(x, y)] = weight)。
- 函数多返回值:如
- 优先选择列表(List)的场景:
- 动态增长与收集:如在循环、管道或消费者队列中不断
append新增产生的数据。 - 同构数据集合:存放一整组类型一致、后续需要统一迭代过滤的数据项(如包含多只股票行情的数组)。
- 需要就地排序或反转:数据需要频繁调整显示次序,使用
list.sort()能在避免额外内存申请的前提下完成计算。
- 动态增长与收集:如在循环、管道或消费者队列中不断
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















