


Python列表与字典的基础操作及常用方法
全面讲解Python列表与字典的基础操作与高频方法,包含元素增删改查、遍历技巧、底层结构对比与选型指南,并配以清晰内联图解。
在 Python 编程中,列表(list)与字典(dict)是最常用且基础的两种内置容器结构。列表专用于保存具有特定前后顺序的元素序列,通过整数索引进行存取;字典则用于保存基于“键-值”对应的映射数据,通过具备唯一性的键实现高效查询。理解两者的创建、常规修改方式、常用内置方法以及底层的运行差异,是编写清晰、健壮 Python 代码的重要基础。本文将具体展开这两种数据结构的操作细节与选用场景。
一、Python 列表(List)的基础操作与核心方法
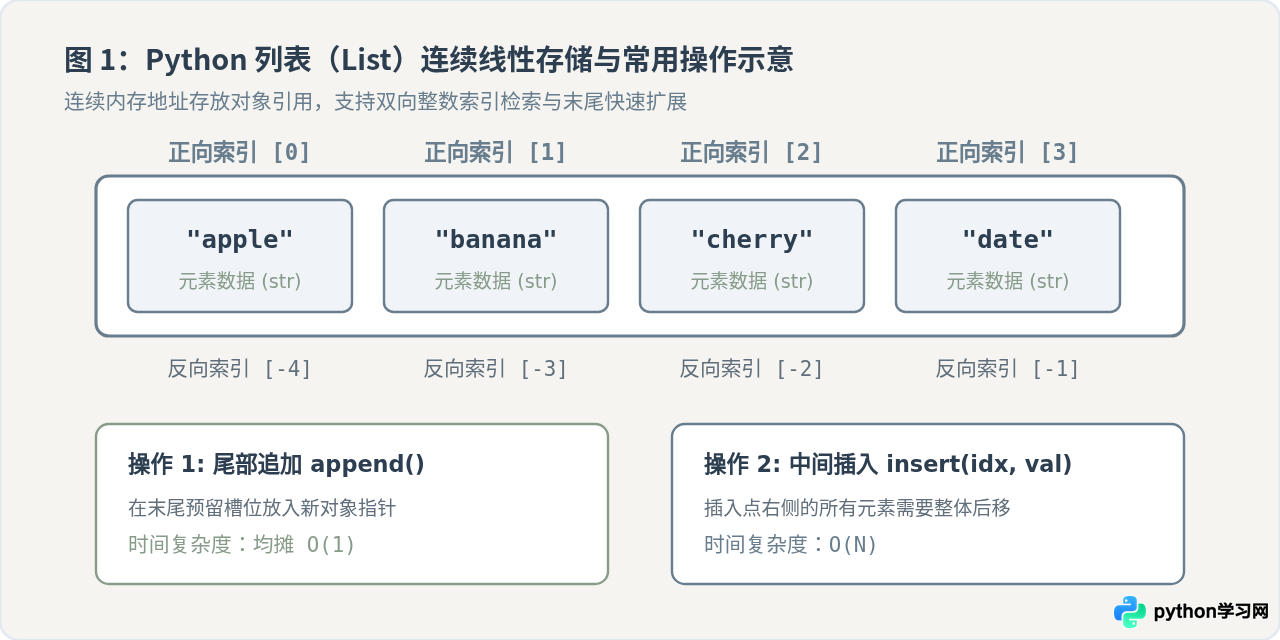
列表是一种有序、可变的集合。列表中的元素按照添加的先后次序排列,每个元素都会被自动分配一个从 0 开始递增的整数索引。列表内部允许容纳重复值,也允许放入不同类型的数据对象。
1. 列表的创建与索引访问
创建列表通常直接使用方括号 [],或者调用内置函数 list()。访问元素时支持正向索引(从 0 开始)与反向索引(从 -1 开始表示末尾元素),同时支持切片语法 [start:stop:step] 截取局部元素:
# 创建示例列表
fruits = ["apple", "banana", "cherry", "date"]

# 索引访问
first_item = fruits[0]     # 正向索引第一项
last_item = fruits[-1]     # 反向索引最后一项
sub_items = fruits[1:3]    # 切片截取:索引1到2(左闭右开)

# 修改指定位置的元素
fruits[1] = "blueberry"first_item 结果为
'apple'last_item 结果为
'date'sub_items 结果为
['banana', 'cherry']修改后 fruits 变为
['apple', 'blueberry', 'cherry', 'date']
2. 列表元素的增加与删除
向列表中添加或移除元素主要依赖以下几种常用方法:
append(item):在列表尾部追加单个新元素,执行速度快,属于最常用的写入方式。insert(index, item):在指定索引位置插入元素,其后的所有元素在内存中依次向后移动一位。extend(iterable):接收另一个可迭代对象,将其包含的所有元素逐一追加到当前列表末尾。pop([index]):移除并返回指定索引处的元素,若未传入参数则默认弹出末尾元素。remove(value):从列表中查找并移除第一个匹配该值的元素,若值不存在则抛出ValueError。clear():清空列表中的全部元素,保留空列表对象。
colors = ["red", "green"]

# 追加与插入
colors.append("blue")          # 尾部追加
colors.insert(1, "yellow")     # 索引1处插入
colors.extend(["black", "white"]) # 批量扩展

# 移除操作
popped_val = colors.pop()      # 弹出末尾的 'white'
colors.remove("yellow") # 移除指定元素 'yellow'popped_val 返回
'white'最终 colors 为
['red', 'green', 'blue', 'black']
3. 列表的排序与常用处理函数
除了增删元素外,日常开发中常需要对列表进行排序、反转与查找统计:
sort(reverse=False):就地对当前列表进行升序或降序排列,直接改变原列表对象。sorted(list):内置全局函数,不修改原列表,而是返回排好序的新列表副本。reverse():直接颠倒列表中所有元素的排列顺序。index(value):返回指定值在列表中首次出现的正整数索引。count(value):统计指定值在列表中出现的总次数。
二、Python 字典(Dict)的基础操作与核心方法
字典是一种以“键-值对”(Key-Value pair)为核心的数据结构。在现代 Python 版本中,字典会默认保持元素的插入顺序。字典的核心特征在于:每一个键(Key)必须是不可变且可哈希(hashable)的对象,且在一个字典中键不能重复;值(Value)则没有任何类型限制。
1. 字典的定义与安全访问
定义字典可以使用大括号 {} 配合冒号,也可以使用 dict() 构造器。读取键值时,直接通过下标 d[key] 读取在键不存在时会直接引发 KeyError;因此推荐结合 get() 方法提供默认值保护:
# 创建字典
user_info = {
    "name": "Alice",
    "role": "engineer",
    "department": "Infrastructure"
}

# 访问元素
user_name = user_info["name"]                 # 存在时直接获取
user_city = user_info.get("city", "Beijing") # 不存在时返回默认值 'Beijing'user_name 结果为
'Alice'user_city 结果为
'Beijing'(原字典无 'city' 键,触发默认值)
2. 键值对的增、改、删操作
字典的修改操作直接面向指定的键进行:
- 直接赋值
d[key] = value:若键已存在则更新对应的值;若键不存在则创建新的键值对。 update(other_dict):将另一个字典或键值对迭代器批量合并到当前字典中,已存在的键会被覆盖。pop(key[, default]):根据键删除对应的键值对并返回该值;若键不存在且未指定默认值,将触发KeyError。popitem():按后进先出(LIFO)规则移除并返回最后一对(key, value)元组。del d[key]:使用 Python 原生语句删除指定键值对。clear():清空字典中的所有映射关系。
config = {"debug": False, "timeout": 30}

# 增加与更新
config["debug"] = True                 # 更新已有键
config["max_retries"] = 3              # 新增键
config.update({"timeout": 60, "env": "prod"}) # 批量合并

# 删除键值对
removed_timeout = config.pop("timeout") # 删除并获取键为 'timeout' 的值removed_timeout 结果为
60最终 config 内容为
{'debug': True, 'max_retries': 3, 'env': 'prod'}
3. 视图方法与循环遍历
字典提供了三个重要的动态视图方法,它们会随着字典的改变而实时更新:
keys():返回包含所有键的视图。values():返回包含所有值的视图。items():返回包含所有(key, value)双元组的视图。在循环遍历字典时,items()是最为清晰且规范的写法。
server_status = {"web_01": "running", "db_01": "standby"}

# 同时遍历键与值
for host, status in server_status.items():
    print(f"主机: {host} -> 状态: {status}")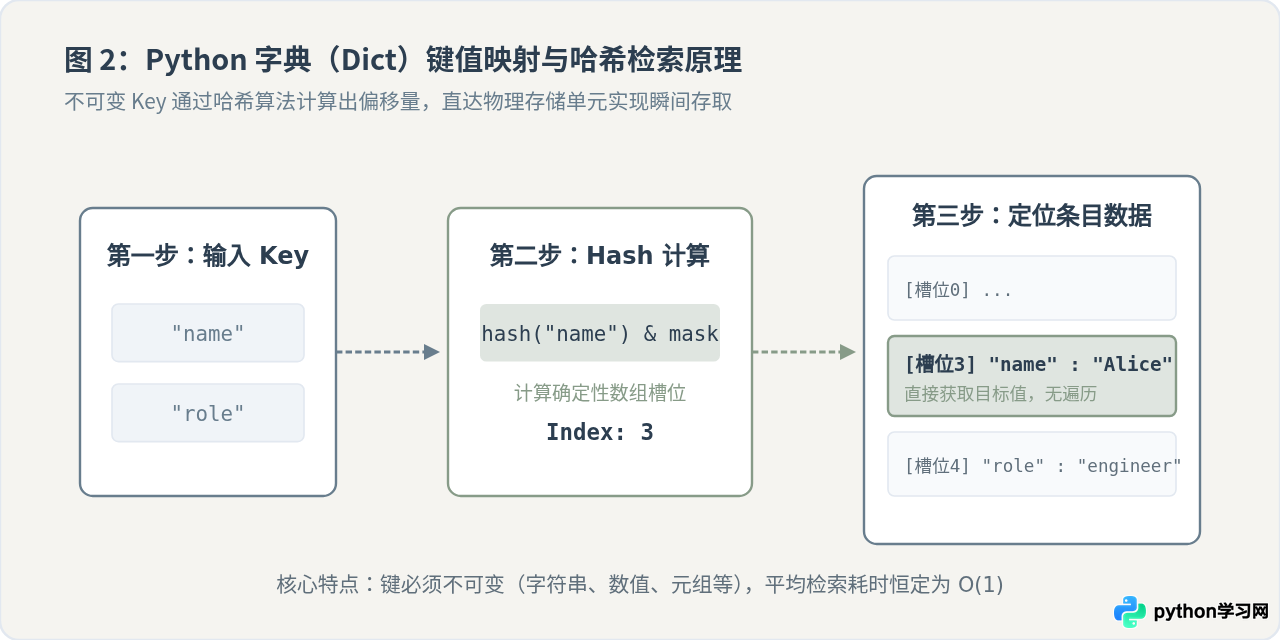
三、深度对比:列表与字典的关键差异与设计定位
很多初学者在选择容器时容易产生疑惑:为什么有了列表还需要字典?在存储包含多条属性的信息时,两者的性能和代码表达究竟有何不同?
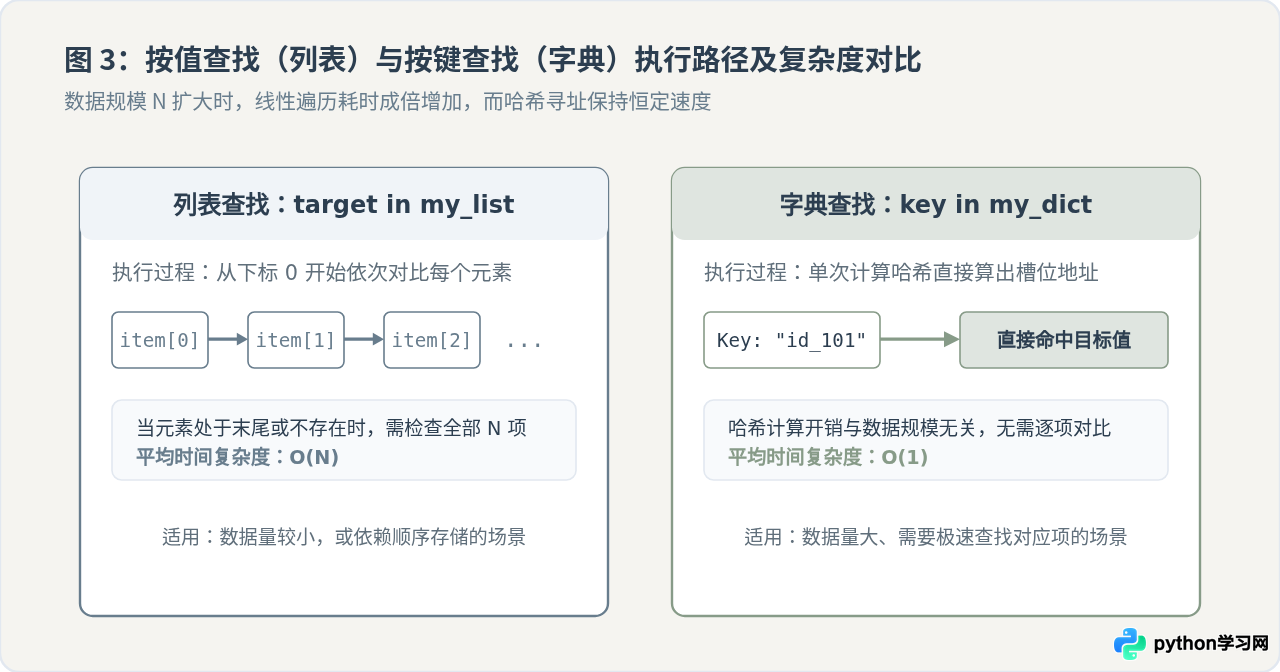
为了直观展现两者核心特性的区别,我们从存储原理、检索成本与使用限制等维度进行对照分析:
| 对比维度 | 列表(List) | 字典(Dict) |
|---|---|---|
| 核心概念 | 有序的对象序列(Sequence) | 键值关联的映射表(Mapping) |
| 寻址依据 | 0, 1, 2... 连续的正整数位置索引 | 任意不可变的可哈希对象作为键(Key) |
| 按值查找成本 | item in list 需要从头到尾线性扫描,平均 O(N) |
key in dict 通过哈希算法直接定位,平均 O(1) |
| 元素重复性 | 允许任意相同元素多次出现 | 键(Key)必须唯一,值(Value)可重复 |
| 内存空间消耗 | 相对紧凑,主要维护指针数组 | 相对较高,需额外维护哈希表与条目稀疏结构 |
| 典型场景 | 时序流水、批量数据计算、需切片分段 | 配置参数、实体属性、高频关键词定位、计数器 |
四、典型应用场景与数据结构选型指南
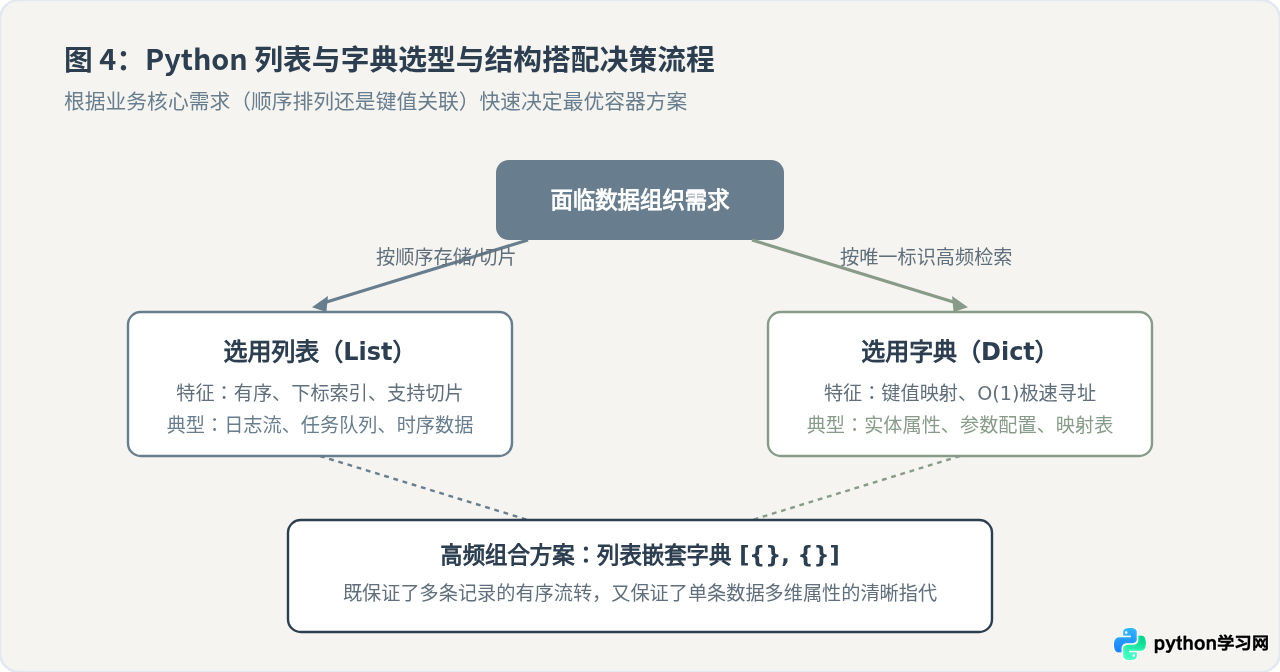
在面对具体的业务需求时,选择列表还是字典取决于数据之间的逻辑关系以及核心操作类型:
1. 适合选用列表的场景
- 需要维持严格的先后顺序:如聊天记录流水、文章章节序列、任务处理待办清单。
- 主要操作为批量处理与切片:例如读取日志文件中的全部行、取最近更新的前 10 条数据。
- 需要实现队列(Queue)或栈(Stack):利用
append()和pop()可以自然实现后进先出(LIFO)的栈结构。
2. 适合选用字典的场景
- 描述具体实体的结构化字段:例如记录一个学生的属性
{"name": "Tom", "score": 95, "grade": 3},字段含义明确且直观。 - 高频检索对应关系:例如用户 ID 与用户信息的绑定关系、HTTP 状态码与其解释文本映射。
- 计数与分类聚合:统计文章中每个词语出现的频率,以词语作为键,以出现频次作为值。
3. 列表与字典的组合运用
在实际工程中,单层容器往往难以满足需求,二者通常互相嵌套构建清晰的数据结构:
- “列表嵌套字典”(List of Dicts):最常用的数据表格或记录列表模型,每个元素代表一条独立记录,如用户列表
[{"id": 1, "name": "A"}, {"id": 2, "name": "B"}]。 - “字典嵌套列表”(Dict of Lists):用于一对多的分类聚合,例如按部门归档员工名单
{"engineering": ["Alice", "Bob"], "sales": ["Charlie"]}。
五、常见陷阱与实用注意事项
1. 边遍历边修改容器大小引发的意外
在遍历列表或字典的同时执行增加或删除操作是新手常见的错误来源:
- 在列表中:直接在
for item in my_list:内部调用remove()或pop()会导致后续元素的索引整体前移,造成部分元素被静默漏检。正确做法是使用列表切片副本for item in my_list[:]:,或者采用列表推导式生成新列表。 - 在字典中:直接在迭代
my_dict或my_dict.keys()时增加或删除键值对,Python 解释器会主动抛出RuntimeError: dictionary changed size during iteration。修改时应先使用list(my_dict.keys())锁定遍历快照。
2. 浅拷贝与深拷贝的区别
使用 list.copy() 或 dict.copy() 仅进行“浅拷贝”(Shallow Copy)。如果容器内部嵌套了其他可变对象(如列表内放列表),浅拷贝只会复制子列表的内存引用,修改新容器内的子列表仍会影响原容器。若需要彻底隔绝影响,必须使用 copy.deepcopy() 进行深拷贝。
3. 字典键必须是不可变对象
字典的键必须能够计算哈希值(满足 Hashable 协议)。Python 中的可变类型(例如列表 list、字典 dict、集合 set)无法直接作为字典的键;如果尝试使用列表做键,解释器会报 TypeError: unhashable type: 'list'。若需要将一组元素作为复合键,请改用不可变元组 tuple。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















