


vLLM 0.34.0怎样保留旧块大小与显存比例
发布时间:2026-11-17 |
9人浏览过
vLLM 0.34.0使用与兼容变化说明。
旧部署的块大小和显存比例都可以显式保留。升级还需要去除旧运行器开关,并核对当前平台的二进制包。
vLLM 0.34.0升级前先核对运行器
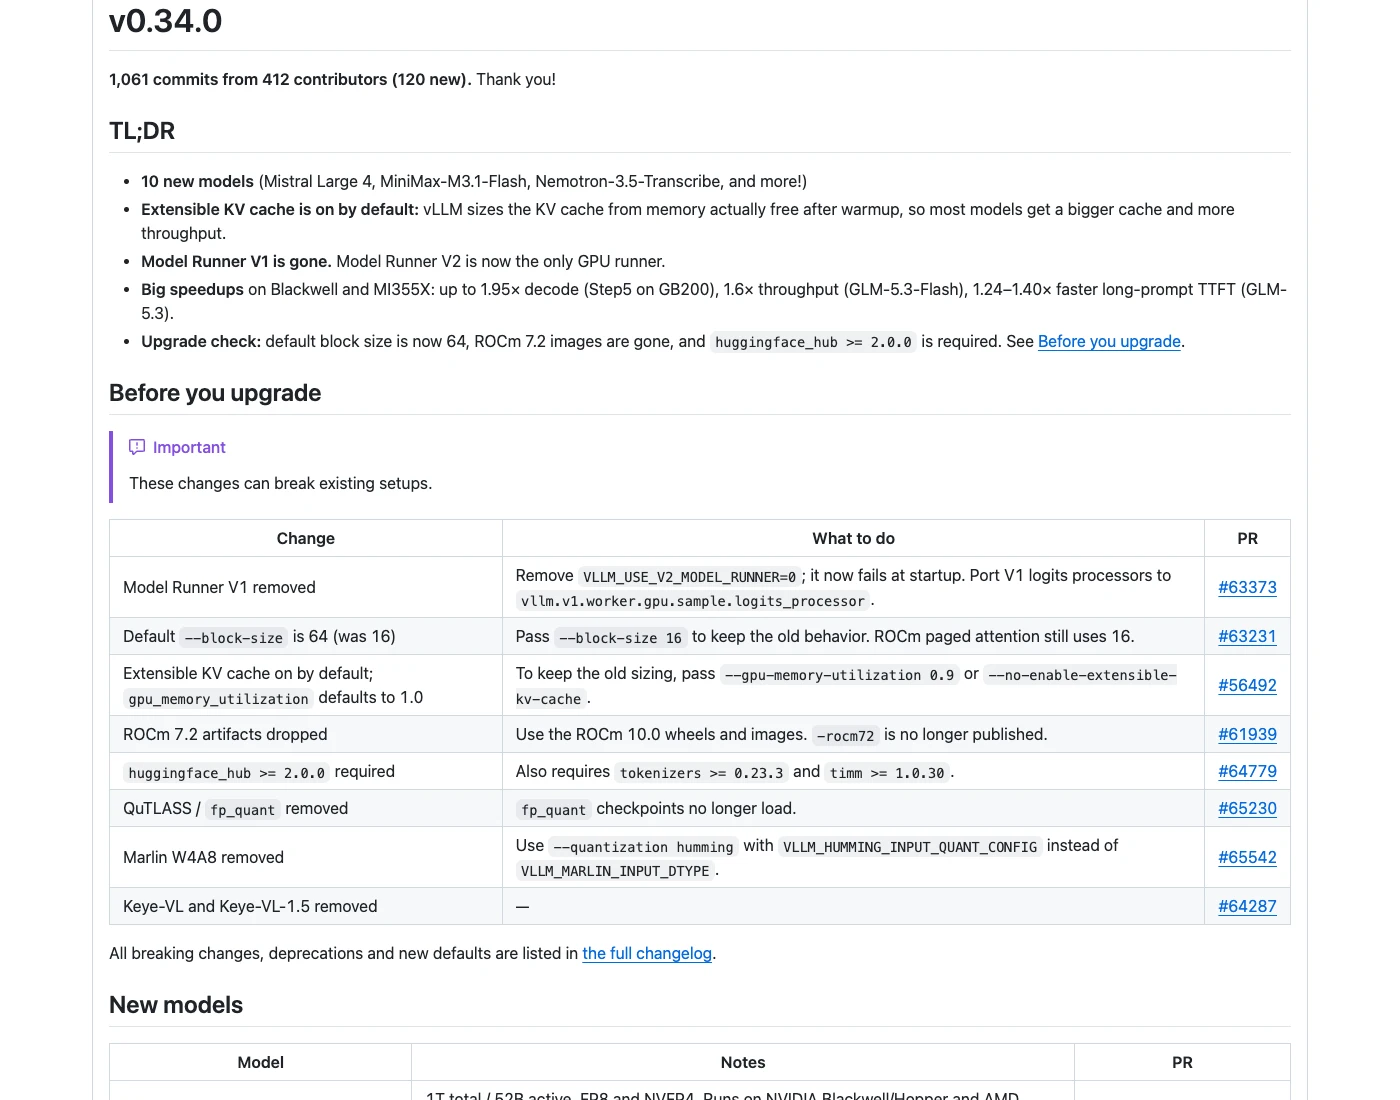
GPU Model Runner V1已经移除。若服务进程继承了强制选择旧运行器的环境变量,启动会失败。自定义V1 logits processor需要迁移到vllm.v1.worker.gpu.sample.logits_processor对应的实现接口。
保留旧块大小和显存预算
默认块大小由16变为64,ROCm paged attention仍使用16。可扩展KV缓存默认启用,显存利用率默认值为1.0。下列示例适用于已安装vLLM 0.34.0的兼容环境,使用支持的本地模型路径替换占位路径,在启动服务的同一 shell 中清除旧运行器设置,并保留旧块大小和显存比例。
unset VLLM_USE_V2_MODEL_RUNNER
vllm serve /path/to/supported-model --block-size 16 --gpu-memory-utilization 0.9
使用容器或服务管理器时,同一旧变量还可能写在实际服务配置里。该示例预期使用V2,并按显式的块大小和显存比例启动。官方也列出关闭可扩展缓存的备选参数,适用于确实需要关闭这一功能的部署:
vllm serve /path/to/supported-model --no-enable-extensible-kv-cache缓存配置会影响可留给其他工作负载的空间以及当前部署可接纳的并发。实际显存占用取决于模型、批次和平台,不能由比例参数推算固定的吞吐提升或成本节省。
检查构建渠道和模型兼容性
官方停止发布ROCm 7.2制品,升级指南指向ROCm 10.0 wheel和镜像。依赖至少为huggingface_hub 2.0.0、tokenizers 0.23.3和timm 1.0.30。原有镜像和锁文件如果仍固定旧依赖,需要按目标构建校验。fp_quant检查点也已无法加载,使用相关检查点的部署应先处理模型兼容问题。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















