


怎么使用pytest参数化测试减少重复代码
本文介绍如何使用 pytest 的 @pytest.mark.parametrize 装饰器实现数据驱动测试,通过批量运行同一测试逻辑来消除重复代码。内容涵盖基础用法、自定义用例标识(ids)、特殊标记(xfail/skip)以及结合 fixture 处理昂贵资源初始化的最佳实践,帮助用户高效维护测试套件。
编写大量结构相似的测试用例往往比被测函数本身更占篇幅:每更换一次输入就要复制一份测试,一旦业务规则变更,还需逐一修改所有副本。pytest 的参数化功能专为解决此类冗余而生。它允许同一个测试函数基于多组输入分别执行,既确保了每种场景结果的独立性,又将易变的数据集中管理,显著提升了代码的可维护性。
一组输入对应一次独立运行
首先观察以下这个简单的工具函数:
def normalize_name(name):
    return name.strip().title()
若仅测试单一名称,常规测试方法已足够。但当需要覆盖去除前后空格、全小写转换及首字母大写等多种输入场景时,逐个复制测试会导致断言逻辑完全重复,仅输入值和预期结果不同。此时可使用 @pytest.mark.parametrize 将这些变量提取为数据列表:
import pytest

@pytest.mark.parametrize(
    "raw, expected",
    [
        (" ada ", "Ada"),
        ("GRACE", "Grace"),
        ("linus torvalds", "Linus Torvalds"),
    ],
)
def test_normalize_name(raw, expected):
    assert normalize_name(raw) == expected
装饰器的第一个参数指定传入测试函数的形参名称,第二个参数则是多组测试数据。由于此处涉及两个参数,每组数据均表现为一个二元组;pytest 会将每组值依次传递给测试函数,从而生成三个独立的测试用例。测试逻辑只写一遍,失败仍能定位到具体数据。
在项目虚拟环境中,可通过 python -m pytest 执行测试,例如使用 python -m pytest -v 查看详细的逐项结果。pytest 的输出将包含测试文件、函数名及参数标识;若尚未安装 pytest,请先依据项目的依赖管理方式进行安装,随后再运行测试。请注意,无需为了适配参数化而修改被测函数的内部逻辑。
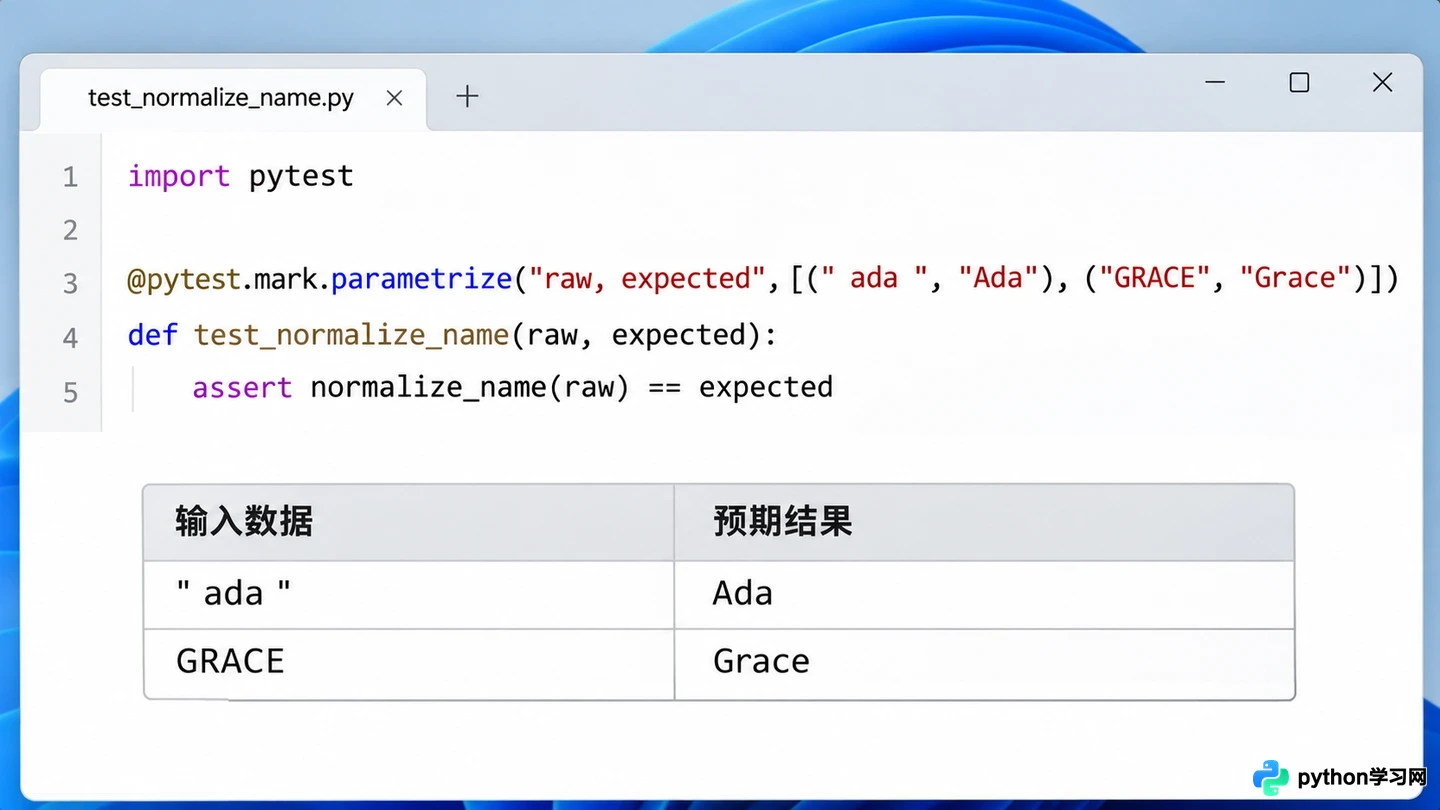
同一测试函数按参数列表生成多组输入。
给用例起名字,也能标记特殊输入
默认情况下,参数标识由参数值自动生成。当数值较长、包含复杂对象,或业务语义比原始值更具参考价值时,可以利用 ids 为各组数据赋予更具描述性的名称:
@pytest.mark.parametrize(
    "raw, expected",
    [(" ada ", "Ada"), ("GRACE", "Grace")],
    ids=["trim-spaces", "capitalize"],
)
def test_normalize_name(raw, expected):
    assert normalize_name(raw) == expected
如此一来,在详细输出和失败报错中将显示更易理解的案例名称。用例命名应准确描述测试场景,避免使用“case1”等无助于排查问题的标签。此外,还可以传入 pytest.param 为单条数据附加特定标记:
@pytest.mark.parametrize(
    "value, expected",
    [
        ("hello", "HELLO"),
        pytest.param(None, None, marks=pytest.mark.xfail(reason="None 输入尚未处理")),
    ],
    ids=["normal", "none"],
)
def test_uppercase(value, expected):
    assert value.upper() == expected
xfail 用于声明某个已知问题当前预期会失败,适合临时记录边界行为;示例中的 None 会导致字符串方法调用抛出异常,因此符合预期失败的设定。若后续实现支持了 None,该用例将变为 XPASS 状态,提示开发者重新评估并移除标记。需注意,这并非让测试强制“通过”的通用开关。也可使用 pytest.param(..., marks=pytest.mark.skip(...)) 跳过明确不适用的单个用例。所有标记均应注明理由,以免掩盖真正的回归缺陷。
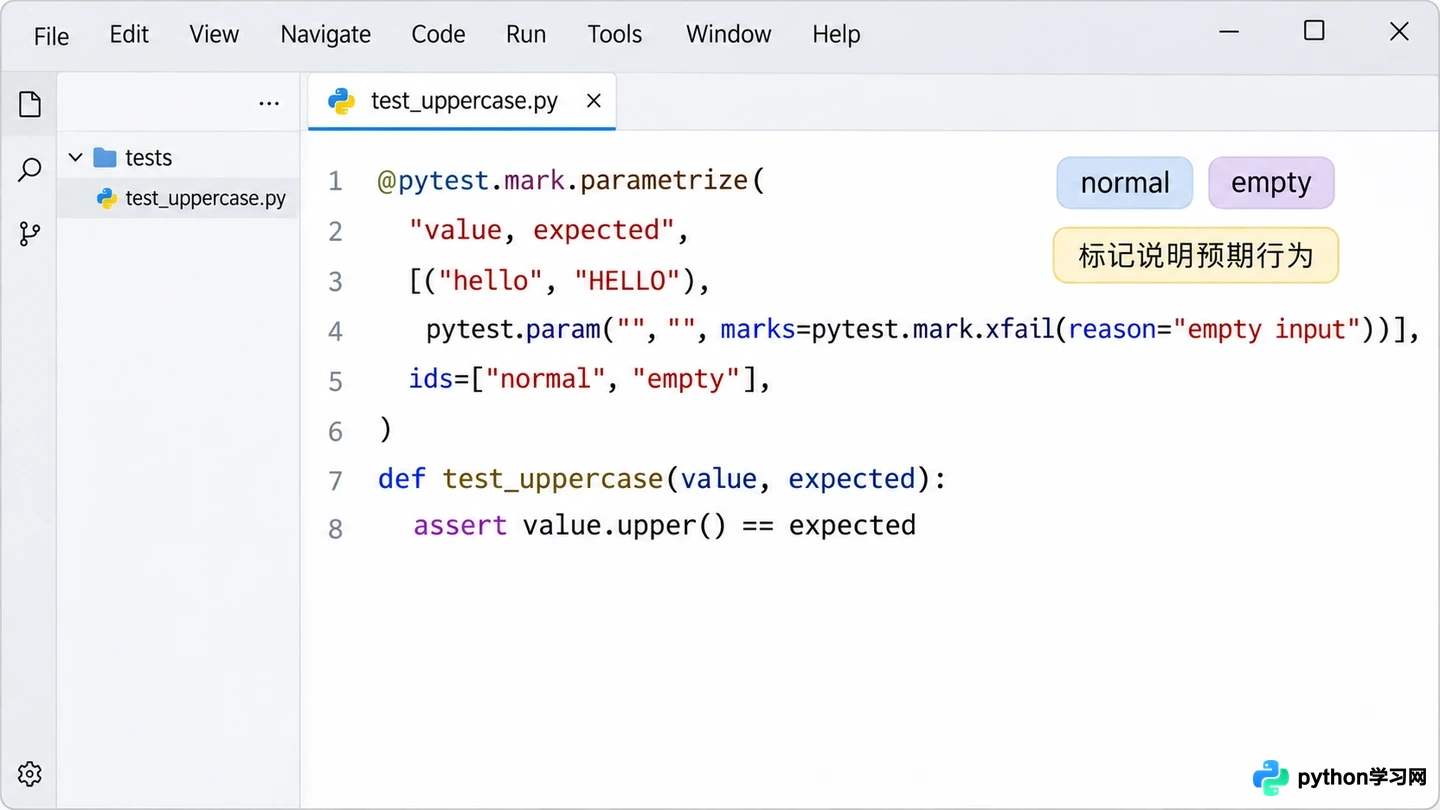
用用例标识和标记说明边界情况。
多个参数集会组合,昂贵准备留给 fixture
多个参数化装饰器可以叠加使用,但其结果将按笛卡尔积进行组合。例如,若一种存储类型有两种变体,一组输入有三种情况,叠加后将生成六个用例。虽然组合能覆盖交叉场景,但也可能导致测试数量迅速膨胀;建议仅在每种组合都具有验证价值时使用。如果只需验证特定的成对组合,将每对数据放在同一个参数列表中通常更为清晰直观。
参数化适用于轻量且明确的输入变化。如果每组测试都需要创建数据库连接或启动服务,切勿将昂贵资源的创建逻辑直接嵌入参数列表。此时可参数化 fixture,让 pytest 在相应阶段负责资源准备:
@pytest.fixture(params=["sqlite", "memory"])
def storage(request):
    return make_storage(request.param)

def test_can_save(storage):
    storage.save("key", "value")
    assert storage.load("key") == "value"
此处 request.param 代表当前 fixture 的参数;依赖 storage 的测试将对每个参数值分别运行。在实际项目中,fixture 还应根据资源生命周期执行清理操作,例如使用 yield 释放连接。测试函数只需声明所需的 fixture,从而实现资源准备与断言逻辑的职责分离。
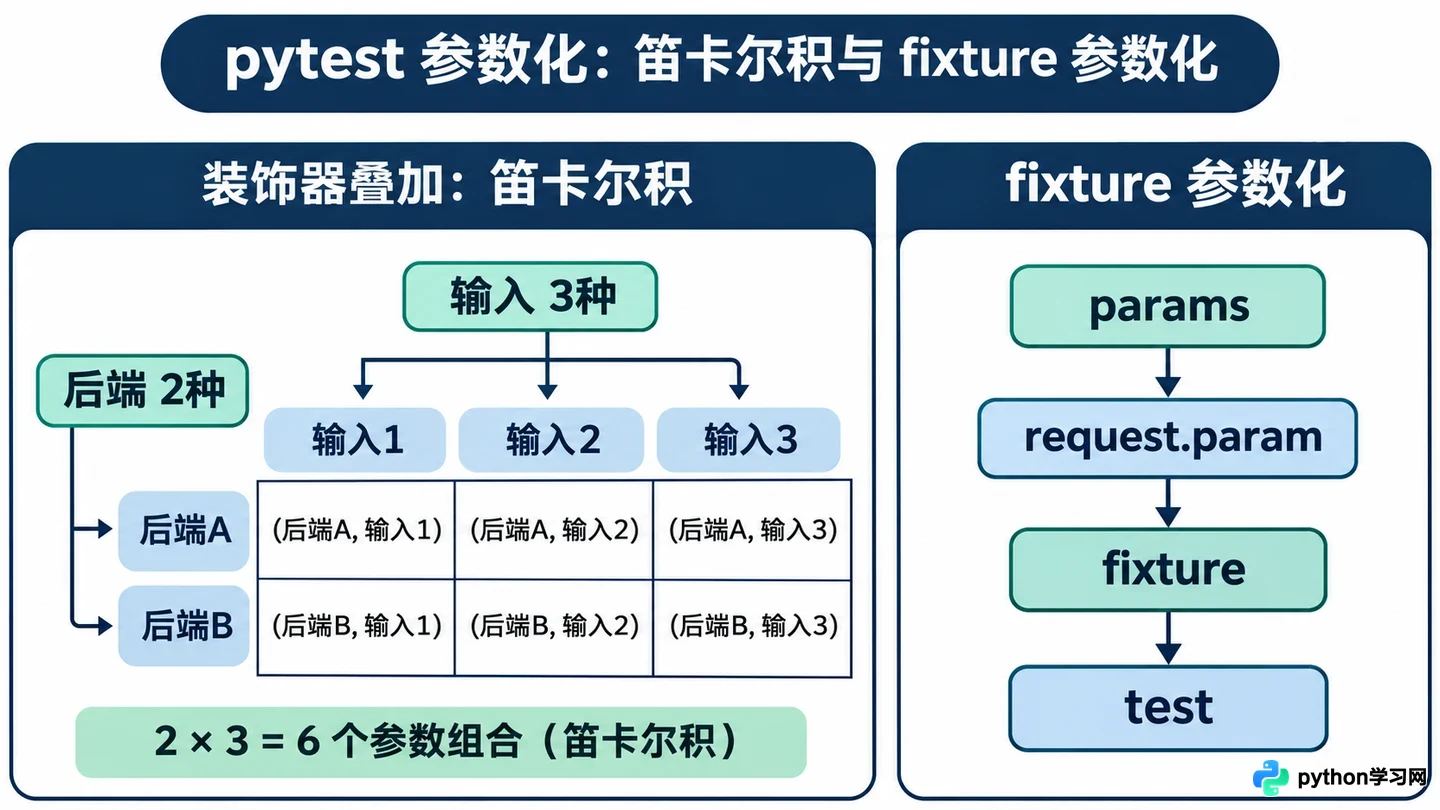
参数组合与 fixture 参数分别影响测试运行。
起步时,可选取一组重复的断言,将输入和预期结果整理为列表,随后逐步补充用例数量、标识及边界标记。参数化旨在减少重复表达,并不会自动提升覆盖质量:每一组数据仍应对应一个有意义的行为验证。若不同场景间的准备步骤和断言逻辑差异较大,将其拆分为多个独立测试通常比强行塞入一个装饰器更易于维护。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















