


Python浅拷贝修改副本为何影响原数据?可变对象引用机制解析
深入解析Python浅拷贝的工作机制,探究为什么修改浅拷贝副本中的嵌套可变对象会同步影响原数据,并提供可变对象引用的原理剖析与深拷贝解决方案。
在 Python 中,当使用 copy() 或切片语法生成一个新列表或字典后,修改这个副本有时完全不影响原数据,但有时却会把原数据一同改动。产生这种分歧的根本原因在于:浅拷贝只创建了最外层的新容器对象,而容器内部存放的所有子元素指针,仍然直接指向原数据中对应元素的内存地址。一旦容器内部嵌套了列表、字典等“可变对象”,原对象与副本引用的其实是堆内存中的同一块区域,对该区域的原地修改自然会被双方同时读取到。
一、现象重现:浅拷贝中“改副本”的两种截然不同的表现
很多开发者在初学列表拷贝时,习惯使用 list.copy() 或切片 [:]。我们来看一段对比代码,观察直接赋值与修改嵌套对象时的不同表现:
# 准备一个包含不可变对象和嵌套可变对象的原列表
original = [100, [1, 2]]

# 制作浅拷贝副本
copy_data = original.copy()

# 动作1:修改副本的最外层元素(直接索引赋值)
copy_data[0] = 999
print("动作1后的 original:", original)   # 输出: [100, [1, 2]] (原数据不受影响)
print("动作1后的 copy_data:", copy_data) # 输出: [999, [1, 2]]

# 动作2:修改副本内部嵌套列表的元素(原地修改)
copy_data[1].append(3)
print("动作2后的 original:", original)   # 输出: [100, [1, 2, 3]] (原数据竟然被改动了!)
print("动作2后的 copy_data:", copy_data) # 输出: [999, [1, 2, 3]]
从上面的示例可以清晰看到:修改 copy_data[0] 时,原列表安然无恙;但对 copy_data[1] 执行 append() 时,原列表 original 内部的数据也随之增加了一个 3。这并不是 Python 运行时出现了故障,而是完全符合 Python 内存引用模型的设计行为。
二、核心解析:Python 变量、引用与对象可变性
为了透彻理解这一机制,需要拆解 Python 底层的三个基础规则:
1. 变量名本质是指向对象的指针(引用)
在 Python 中,变量名并不直接存储具体数据,而是存储对象的内存地址。当写下 a = [1, 2] 时,系统在内存堆中开辟了一块区域容纳该列表,并将变量 a 关联到该区域的地址。通过内置函数 id() 可以查验对象的唯一内存标识;通过操作符 is 可以确认两个变量是否指向完全相同的内存实体。
2. 可变对象与不可变对象的底层差异
- 不可变对象(Immutable):包括
int、float、str、tuple、bool等。不可变对象一旦在内存中创建,其内容就不可再改变。当试图对一个变量重新赋值(例如x = x + 1或copy_data[0] = 999)时,并不是修改原本那个数字对象,而是创建了一个全新的对象并将变量重新指向新对象。 - 可变对象(Mutable):包括
list、dict、set等。可变对象支持原地更新(In-place mutation),如list.append()、list.pop()、dict[key] = value。这些操作直接在原有内存地址上修改内部数据,对象的id保持不变。
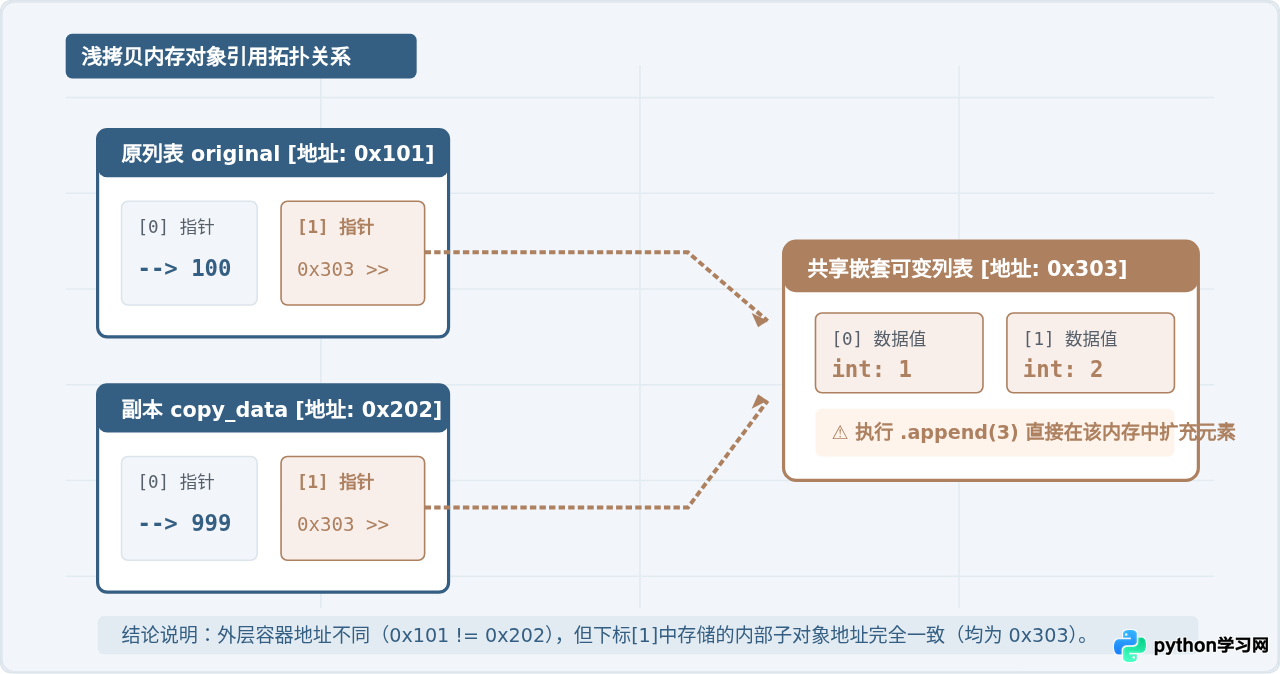
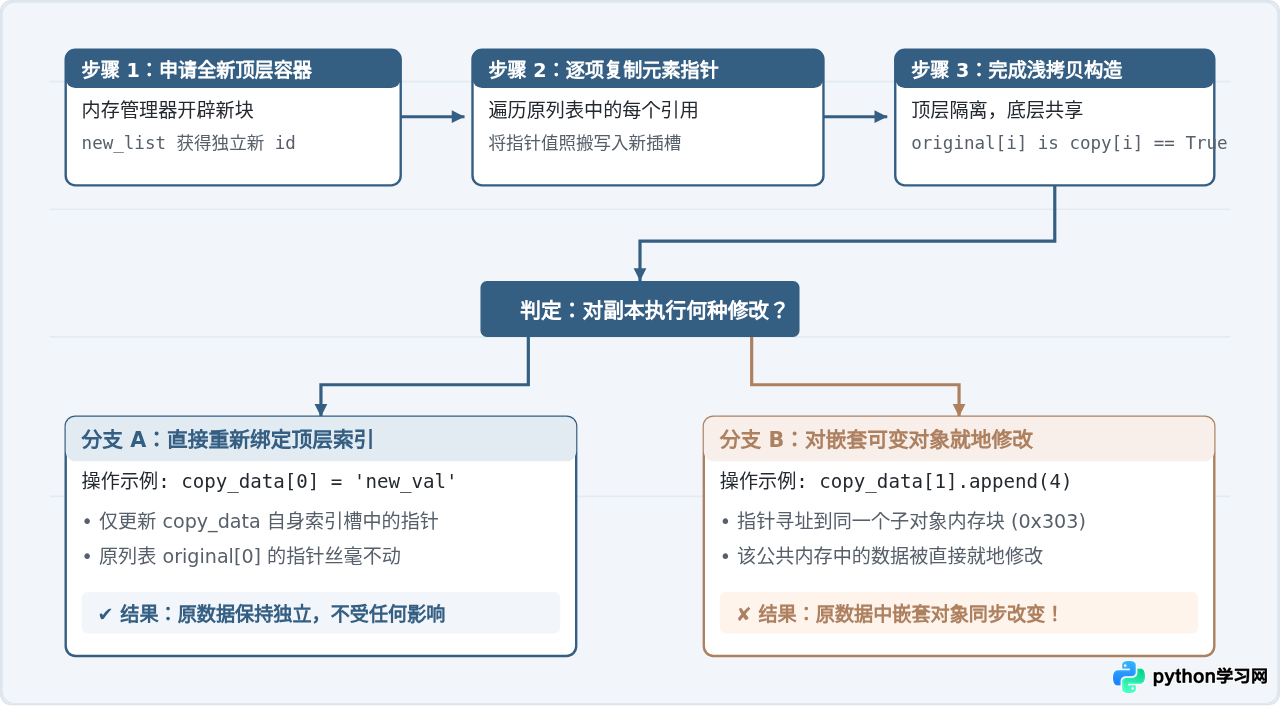
执行 copy_data[0] = 999 时,改变的是 copy_data 这个外层容器第 0 项的“指针指向”,让它指向新对象 999。这属于修改容器自身的插槽引用,因为 copy_data 与 original 是两个独立的外层容器,所以不会影响 original[0]。
执行 copy_data[1].append(3) 时,代码首先取出 copy_data[1] 指向的对象(即地址为 0x303 的子列表),然后调用其方法进行原地修改。由于 original[1] 同样指向该地址,原列表查阅其子列表时,自然呈现出修改后的内容。
三、推导过程:浅拷贝的创建与操作执行流
浅拷贝不仅发生在调用 .copy() 方法时,在 Python 的日常开发中,以下四种写法本质上全部都是浅拷贝:
- 使用容器自身的
copy()方法:new_list = old_list.copy()或new_dict = old_dict.copy(); - 使用类型构造函数转换:
new_list = list(old_list)、new_dict = dict(old_dict); - 使用切片操作符复制序列:
new_list = old_list[:]; - 使用标准库
copy模块的浅拷贝方法:import copy; new_obj = copy.copy(old_obj)。
下图详细展示了解释器在执行浅拷贝时的推导步骤,以及后续不同操作引发的数据变化路径:
四、对比分析:浅拷贝与深拷贝的本质差异
如果业务场景需要彻底隔离副本与原数据,无论层级多深都互不干扰,就必须使用 Python 标准库 copy 提供的 deepcopy()(深拷贝)。
深拷贝在拷贝对象时,会递归遍历原对象中引用的所有子对象:只要遇到可变对象,就会在内存中新建一个一模一样的实例,并将副本中的对应层级重定向到该新实例。因此,深拷贝建立的是两棵完全独立的引用树。
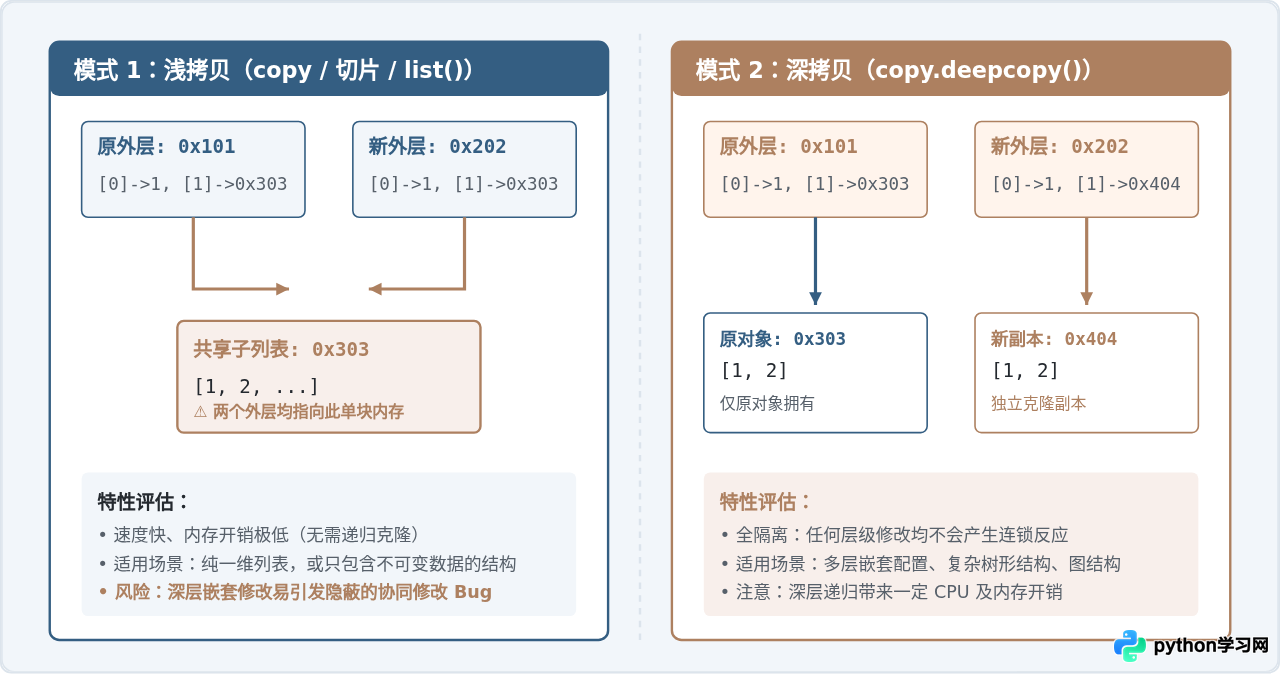
为了直观对比两者的差异,以下是两种拷贝方式的核心属性对照:
| 对比维度 | 直接赋值(b = a) |
浅拷贝(b = a.copy()) |
深拷贝(b = copy.deepcopy(a)) |
|---|---|---|---|
| 外层容器对象 | 完全相同(同一个 id) |
新建独立容器(不同 id) |
新建独立容器(不同 id) |
| 内部嵌套可变对象 | 共享同一引用 | 共享同一引用 | 递归克隆全新独立对象 |
| 修改外层元素 | 互相影响 | 互不影响 | 互不影响 |
| 修改嵌套子对象 | 互相影响 | 互相影响 | 互不影响 |
| 性能与内存开销 | 零额外开销(仅增引用计数) | 低(仅开辟一层空间) | 较高(递归遍历并分配全部节点) |
五、工程实践:如何正确排查与避坑
在编写处理复合数据结构(例如解析 JSON 数据、批量处理配置字典、图算法邻接表)的工程代码时,建议遵循以下排查流程与选择规范:
1. 使用 is 与 id() 快速验证拷贝状态
在调试怀疑出现“数据污染”的代码时,不要仅靠 print() 输出查看内容,而应使用 is 运算符打印两者的地址判定:
import copy

data = {"env": "prod", "servers": ["10.0.0.1", "10.0.0.2"]}

# 验证外层
shallow_copy = data.copy()
print(data is shallow_copy)  # 输出: False (外层字典是新的)

# 验证内层嵌套对象
print(data["servers"] is shallow_copy["servers"])  # 输出: True (内层列表完全是同一个对象!)

# 对比深拷贝
deep_copy = copy.deepcopy(data)
print(data["servers"] is deep_copy["servers"])  # 输出: False (内层也已完全独立)
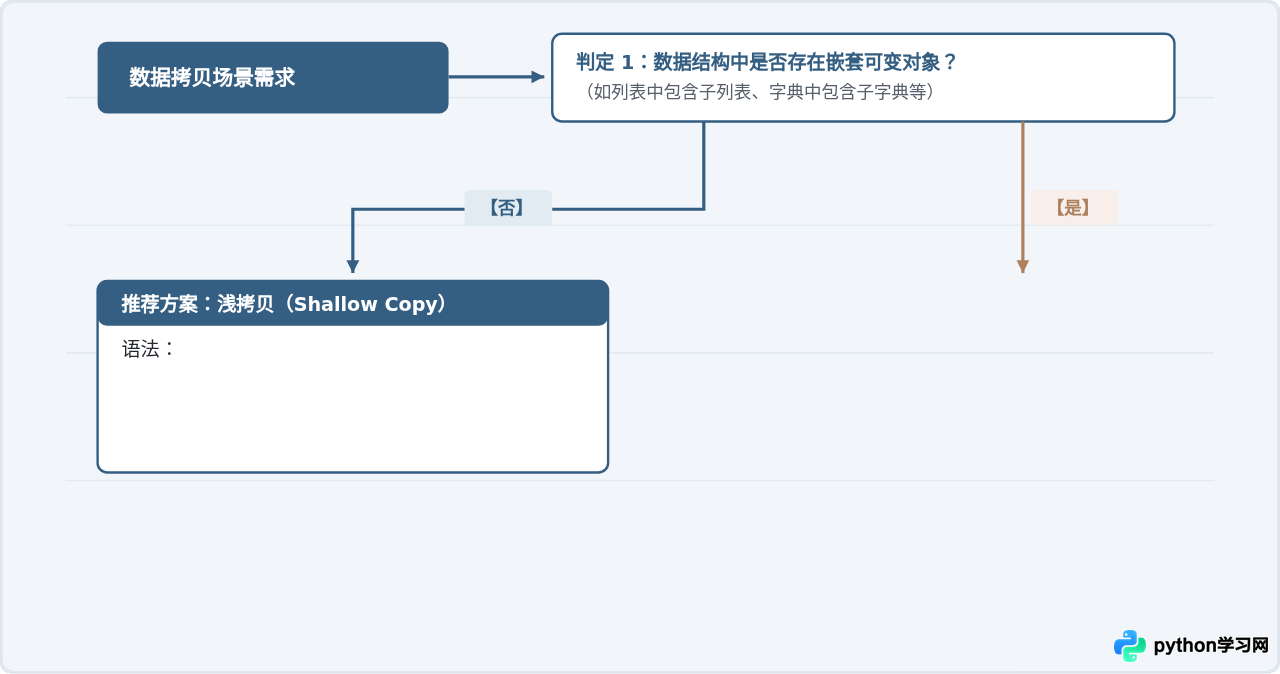
2. 对象拷贝技术选型决策树
按照数据结构的实际复杂度与修改意图,可通过以下决策路径进行合理选型:
六、总结与认知清单
回到文章标题的问题:“Python浅拷贝修改副本为何影响原数据?”——归结起来只有两句话:
- 外层新建,内层引用:浅拷贝仅新建了一层外层容器,内层元素完全是旧对象的地址指针拷贝。
- 对象可变,共享修改:当内层对象是可变对象时,通过副本对其进行的任何原地修改(如
append、pop、赋新键值),都是直接施加在共享的内存地址上,原数据读取该地址自然表现出被修改的状态。
掌握了这一内存引用机制,在面对复杂结构复制时,只需判断数据是否包含嵌套可变对象以及后续是否存在就地修改需求。对纯简单列表放心地使用浅拷贝保持高效,对多层复合数据则坚决使用 copy.deepcopy() 确保安全隔离。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















