


Python类变量和实例变量的区别:修改影响与常见误区
深入解析Python类变量与实例变量的本质区别、内存命名空间机制、属性查找链、修改时的影响差异及常见踩坑场景。
一、核心概念与内存存储机制
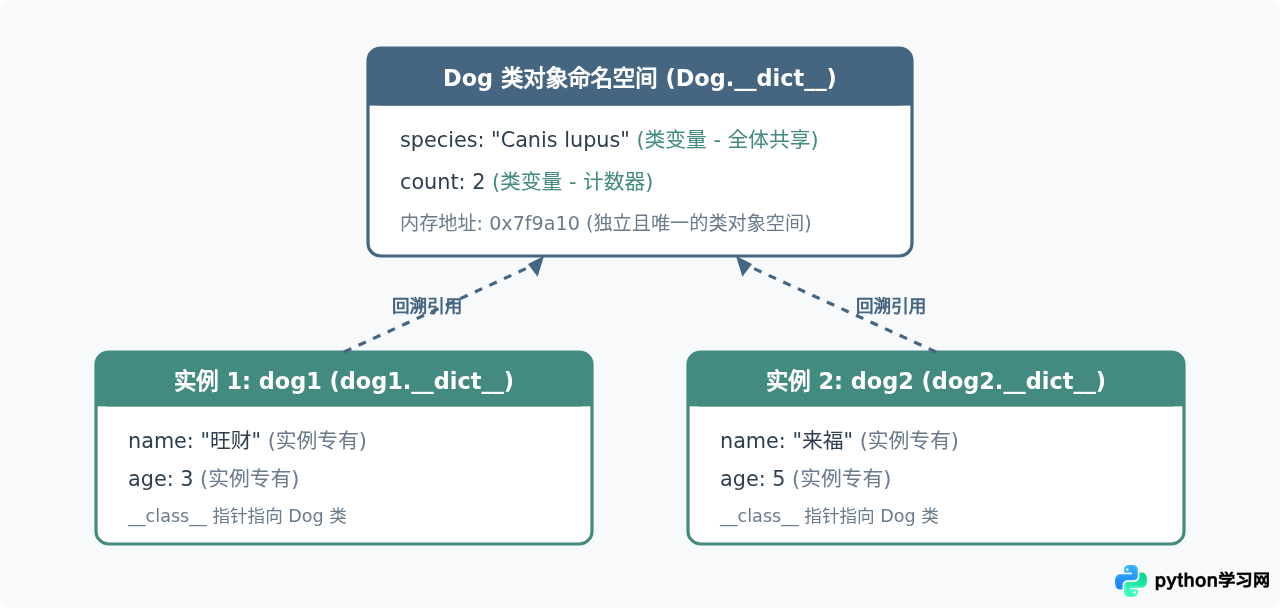
要透彻理解类变量与实例变量,首先要观察它们在代码中的声明位置以及在底层内存中的归属关系。
- 类变量:直接定义在类体内部、所有方法之外。它属于类对象(Class Object),在类被加载解释时创建并初始化,保存在类对象的
__dict__属性字典中。无论该类被实例化了多少次,类变量在内存中自始至终只有一份。 - 实例变量:通常在类的
__init__构造方法或其他实例方法中,通过self.变量名 = 值的形式进行绑定。它直接保存在每个具体实例对象的__dict__属性字典中,生命周期随实例创建而产生、随实例销毁而回收。
我们可以通过下面的代码直接查看类与实例的 __dict__ 结构:
class Dog:
    species = "Canis lupus"  # 类变量
    count = 0               # 类变量

    def __init__(self, name, age):
        self.name = name     # 实例变量
        self.age = age       # 实例变量
        Dog.count += 1

dog1 = Dog("旺财", 3)
dog2 = Dog("来福", 5)

# 打印实例字典与类字典
print(dog1.__dict__)  # 输出: {'name': '旺财', 'age': 3}
print(dog2.__dict__)  # 输出: {'name': '来福', 'age': 5}
print(Dog.species) # 输出: Canis lupus运行结果清楚表明:dog1 和 dog2 的字典中只有 name 和 age,根本不存在 species 和 count。实例本身并不存储类变量,类变量严格归属于类命名空间。
二、属性查找链(Attribute Lookup Order)
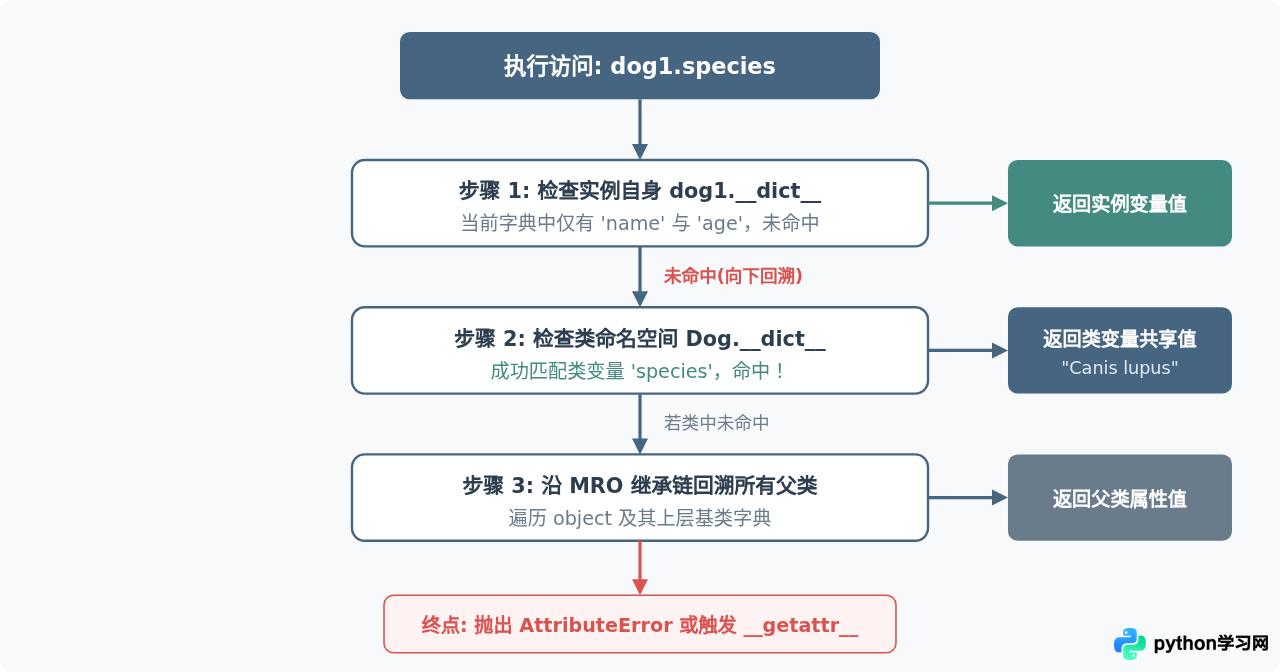
既然 dog1.__dict__ 中没有 species,为什么执行 print(dog1.species) 却能正常输出 "Canis lupus"?这依赖于 Python 的属性查找链机制。
当开发者通过点号访问一个对象的属性(如 instance.attr)时,若该属性不是数据描述符(Data Descriptor),解释器会严格遵循如下顺序逐级回溯:
- 查询当前实例字典:首先在
instance.__dict__中查找是否有名为attr的键。若存在,直接返回其对应的值,查找流程终止。 - 查询所属类的字典:若实例自身不存在该键,解释器会通过实例内部的
__class__指针跳转到所属类,在instance.__class__.__dict__中查找。若命中类变量,则返回该值。 - 沿继承链向基类查找(MRO):若当前类中仍未声明,解释器会按照方法解析顺序(Method Resolution Order, MRO)依序向上排查所有父类字典。
- 异常处理与兜底:若所有命名空间均未找到该属性,且类未定义
__getattr__方法,Python 将直接抛出AttributeError。
三、修改变量时的行为差异与遮蔽效应
很多新手在此处产生误解:“既然我能通过 dog1.species 读取类变量,那么我写 dog1.species = '狼' 是不是就能修改类变量?”答案是否定的。
1. 赋值触发的“遮蔽效应”(Attribute Shadowing)
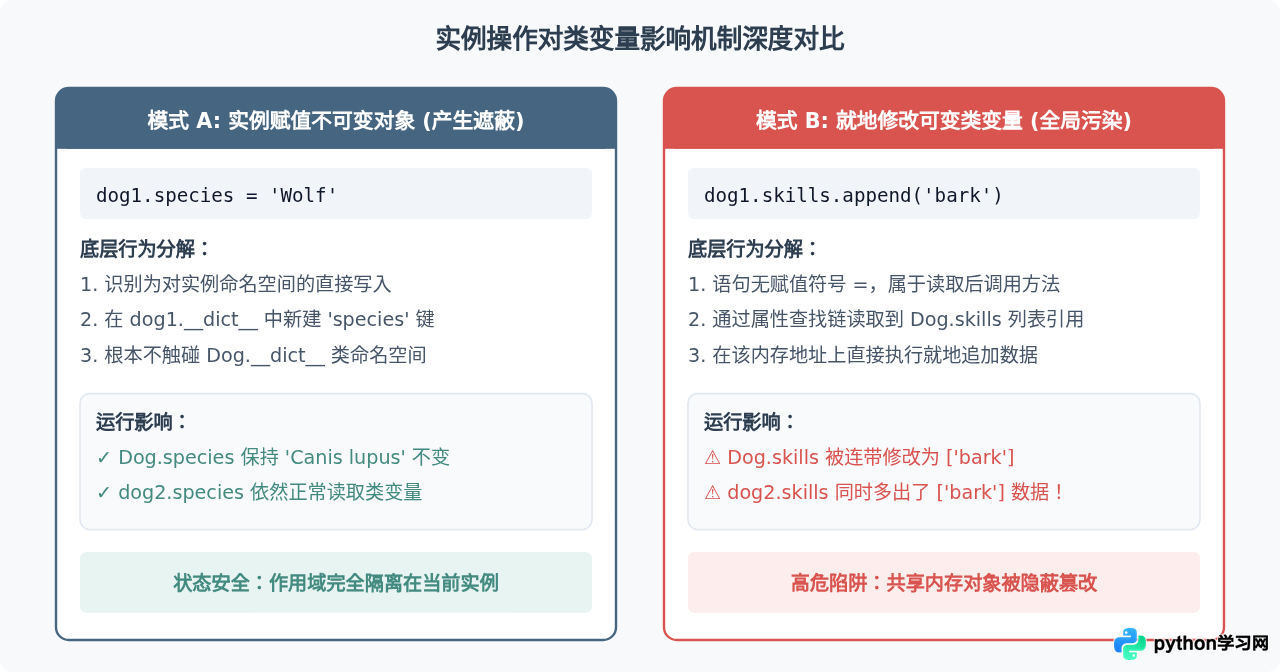
在 Python 中,通过实例进行的赋值表达式永远只作用于该实例自身。当执行 dog1.species = "狼" 时,Python 解释器根本不会去寻找或修改 Dog.species,而是在 dog1.__dict__ 中直接创建一个新的键值对 'species': '狼'。
# 初始状态
print(Dog.species)   # Canis lupus
print(dog1.species)  # Canis lupus (通过查找链命中类变量)
print(dog2.species)  # Canis lupus (通过查找链命中类变量)

# 通过实例 dog1 赋值
dog1.species = "狼"

# 再次检查
print(dog1.__dict__) # {'name': '旺财', 'age': 3, 'species': '狼'} -> 新增实例变量!
print(dog1.species)  # 狼 (在步骤1即从自身字典返回,类变量被“遮蔽”)
print(dog2.species)  # Canis lupus (不受任何影响!)
print(Dog.species) # Canis lupus (类变量毫无变动!)此时,dog1.species 遮蔽(Shadow)了 Dog.species。如果执行 del dog1.species 删除了这个实例变量,再次读取 dog1.species 时,由于实例字典中不再有该键,查找链又会重新回退到 Dog.species,恢复输出 "Canis lupus"。
2. 修改类变量的唯二正规途径
要真正修改类变量并让所有实例同步生效,必须显式通过类名进行赋值,或者在类方法内部通过 cls 对象赋值:
# 正确修改方式 1:通过类名显式赋值
Dog.species = "家犬"

print(dog2.species)  # 输出: 家犬 (同步感知类变量更新)
print(dog1.species)  # 输出: 狼 (因自身存在遮蔽属性,依然输出实例专有值)

# 正确修改方式 2:在类方法中通过 cls 赋值
class Dog:
    species = "Canis lupus"

    @classmethod
    def set_species(cls, new_species):
        cls.species = new_species
3. 不可变类型 vs 可变类型的修改深坑
如果类变量是字符串、整型、元组等不可变对象,误用实例赋值只是产生了局部遮蔽,危害尚可控制。但若类变量是列表、字典、集合等可变容器,通过实例调用其就地修改方法(如 .append()、.extend()、[key] = val),将引发严重的全局数据污染!
四、4 个经典误区与排查修复
误区 1:在类变量中使用可变类型充当“默认容器”
这是 Python 开发者最容易写出的严重 Bug 之一。开发者本意是希望每个对象都有一个初始为空的列表用于存放数据,却把列表直接写在了类体中:
# 错误写法:所有实例共享同一个列表对象
class User:
    roles = []  # 危险:类变量定义了可变列表

    def add_role(self, role):
        self.roles.append(role)

u1 = User()
u2 = User()
u1.add_role("admin")

print(u2.roles) # 输出: ['admin']!普通用户莫名被赋予了管理员角色!正确做法:凡是每个实例专有的数据容器,必须在 __init__ 中进行初始化,确保每个对象持有独立的实例变量副本。
# 正确写法:在 __init__ 中创建独立实例变量
class User:
    def __init__(self, roles=None):
        # 避免可变默认参数陷阱,为每个实例独立创建新列表
        self.roles = list(roles) if roles is not None else []

    def add_role(self, role):
        self.roles.append(role)
误区 2:使用 self.var += 1 以为能够自增类变量计数器
很多开发者希望在实例方法内部累计全局调用次数,误写成 self.count += 1:
class Tracker:
    total_calls = 0

    def track(self):
        self.total_calls += 1  # 错误!
self.total_calls += 1 语法本质上等价于:
self.total_calls = self.total_calls + 1这一行代码包含了两个阶段:
- 等号右侧读取:由于
self.__dict__还没有total_calls,通过查找链读取到Tracker.total_calls(值为 0),计算得到0 + 1 = 1。 - 等号左侧赋值:通过实例进行赋值,直接在
self.__dict__中创建了一个值为1的新实例变量!
结果是:Tracker.total_calls 永远保持为 0,而每个实例调用 track() 后各自拥有了一个值为 1 的实例变量,无法实现全局累计。
正确做法:对全局类变量计数器的累加,必须显式使用类名或类方法:Tracker.total_calls += 1。
误区 3:在子类继承时误判类变量的继承关系
类变量同样遵循继承查找规则。如果子类没有显式重写类变量,修改父类的类变量会影响子类;而一旦通过子类赋值,就会在子类自身生成独立的类变量:
class Base:
    version = "1.0"

class SubA(Base):
    pass

class SubB(Base):
    pass

# 1. 修改父类变量,所有未重写的子类同步变更
Base.version = "2.0"
print(SubA.version)  # 2.0
print(SubB.version)  # 2.0

# 2. 通过子类 SubA 赋值,将在 SubA 命名空间生成独立的类变量
SubA.version = "3.0"
Base.version = "4.0"
print(SubA.version)  # 3.0 (SubA 已经解耦独立)
print(SubB.version)  # 4.0 (依然跟随父类)
误区 4:混淆多线程并发对类变量的修改
由于类变量在进程内唯一且被所有实例共享,若多个线程并发通过多个实例同时读取和修改类变量(例如共享资源池、统计计数),在没有加锁保护的情况下会产生典型的竞态条件(Race Condition),导致计数丢失或数据覆盖。
五、选型决策指南与最佳实践
为了在日常开发中准确选择变量类型并避免潜在隐患,可以参考以下决策依据与对比特征:
| 对比维度 | 类变量 (Class Variable) | 实例变量 (Instance Variable) |
|---|---|---|
| 定义位置 | 类体内部,所有方法外部 | 方法内部,通过 self.var = ... |
| 底层存储 | Class.__dict__(全局唯一份) |
instance.__dict__(每个实例各一份) |
| 生命周期 | 随模块加载/类创建而存在,进程退出时销毁 | 随实例对象创建而产生,随实例垃圾回收而销毁 |
| 通过实例赋值 | 无法修改类变量,在实例自身产生同名遮蔽属性 | 正常修改当前实例自身的属性值 |
| 典型适用场景 | 全局配置常量、跨实例计数器、类型标识符、默认不可变属性 | 对象独有状态(如名字、年龄、订单ID、私有缓存列表) |
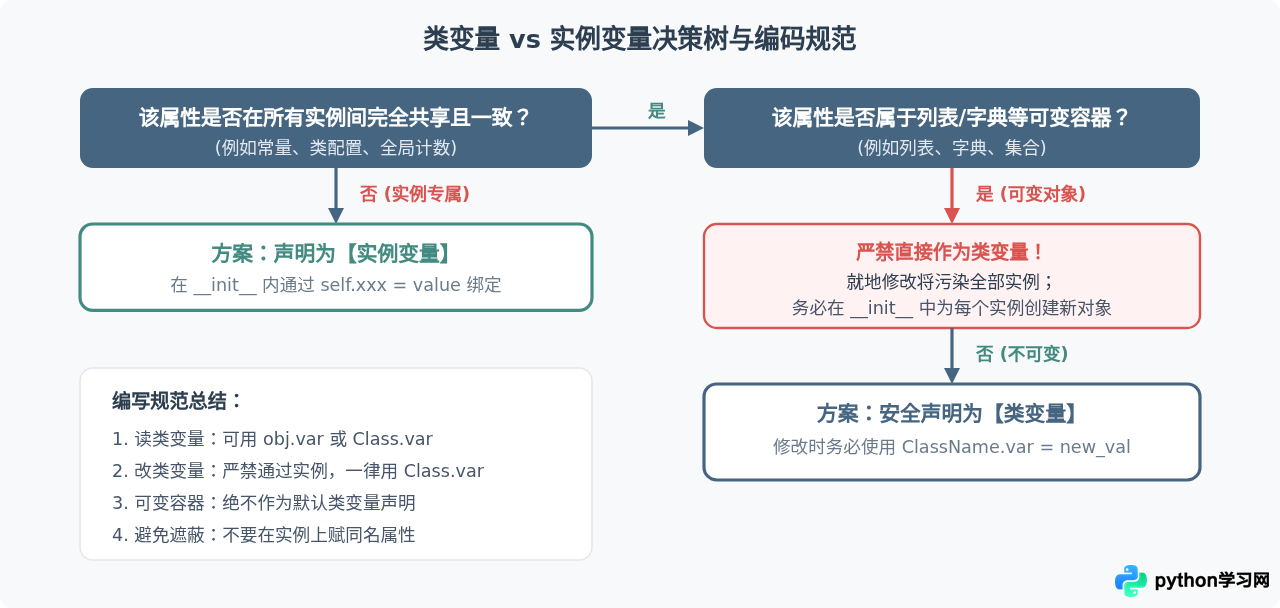
总结实践准则
记住三句核心口诀:“读取走链条,赋值落自己;可变勿共享,改类显式提。”只要在编码中始终关注变量的内存归属,并在修改类变量时坚守通过类名或 cls 显式操作的规范,就能彻底杜绝属性遮蔽与可变对象暗中污染的生产隐患。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















