


Python统计字符串中字母出现次数的三种实现方式

本文介绍在Python中统计字符串内字母出现次数的三种方法。通过字典手动累加、利用get方法简化逻辑,以及使用count函数直接统计,展示了不同场景下的实现思路。所有方法均返回字典格式结果,后两种内置函数方式更为简洁高效。
基础实现:手动遍历与字典累加
最直观的方法是遍历字符串中的每个字符,利用字典记录出现次数。若字符不在字典中,则初始化为1;若已存在,则值加1。这种方法逻辑清晰,适合理解底层计数原理。
s = 'helloworld'
d = dict()
for x in s:
    if x not in d.keys():
        d[x] = 1
    else:
        d[x] = d[x] + 1
print(d)
进阶技巧:利用字典get方法
Python字典的get方法可以指定默认值,从而简化代码结构。通过d2.get(x, 0)获取当前计数,若不存在则返回0,随后加1并赋值。这种方式减少了条件判断语句,使代码更加紧凑。
s = 'helloworld'
d2 = dict()
for x in s:
    d2[x] = d2.get(x, 0) + 1
print(d2)
直接统计:使用count函数
对于简单的统计需求,可以直接利用字符串的count方法。遍历字符串中的每个字符,调用s.count(x)获取其在整个字符串中的出现次数。虽然这种方法在长字符串中效率较低(时间复杂度较高),但代码最为简短直观。
s = 'helloworld'
d3 = dict()
for x in s:
    d3[x] = s.count(x)
print(d3)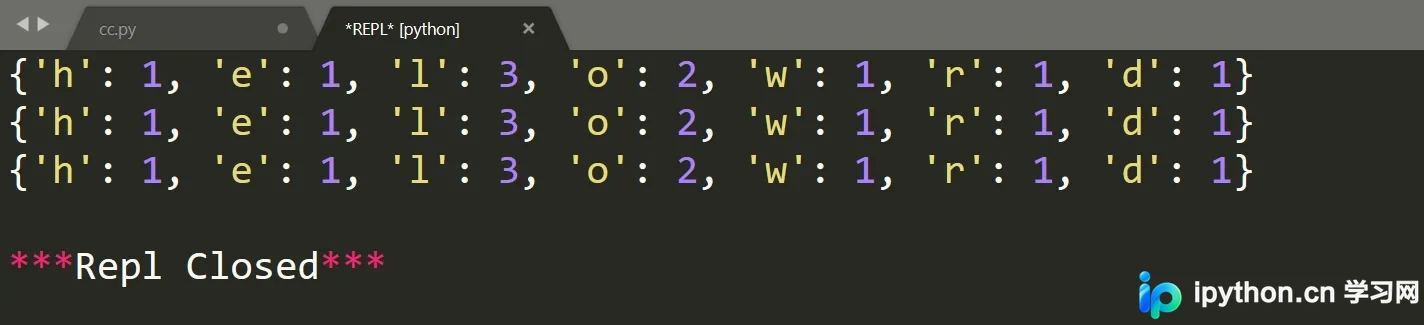
特定场景:仅统计英文字母
当需要忽略标点符号、数字或其他非字母字符,且要求结果按字母表顺序排列时,可以采用更复杂的处理逻辑。以下代码展示了如何仅统计26个英文字母的出现次数,并返回有序列表。
方法一:基于ASCII码值统计
通过判断字符的ASCII码值是否在'a'到'z'之间,利用索引偏移量将字母映射到0-25的列表中。这种方法不依赖字典,直接通过数学计算定位位置。
def countchar(str):
    str = str.lower()  # 统一转为小写
    ans = []
    for i in range(26):  # 初始化26个0
        ans.append(0)
    for i in str:
        if (ord(i) >= ord('a') and ord(i) <= ord('z')):
            ans[ord(i) - ord('a')] = ans[ord(i) - ord('a')] + 1
    return ans

if __name__ == "__main__":
    str_input = input()
    print(countchar(str_input))
方法二:基于字典与键列表
先生成包含26个字母的键列表,利用dict.fromkeys初始化字典。遍历字符串时,使用count方法统计每个字母在字符串中的出现次数并存入字典。最后遍历键列表,从字典中按顺序取值,确保结果有序。
def countchar(st):
    keys = [chr(i + 97) for i in range(26)]  # 生成26个字母的key列表
    di = dict().fromkeys(keys, 0)  # 赋给每个key初始值0
    new = []  # 建立一个新列表用于存放有序的key
    st = st.lower()  # 将所有输入的字符改为小写
    for s in st:  # 遍历字符串
        di[s] = st.count(s)  # 输出每个字符的个数,存放到字典里
    for k in keys:  # 遍历keys, 将其在di中的值添加到新列表,获得有序的26个字母的个数
        new.append(di[k])
    return new  # 返回存有26个字母个数的列表

if __name__ == "__main__":
    st = input()  # 输入字符串
    str1 = ""  # 定义一个空字符串
    for s in st:  # 遍历输入的字符串
        if s.isalpha() != 0:  # 只有字母才添加到新字符串,标点忽略不计
            str1 += s
    print(countchar(str1))  # 输出列表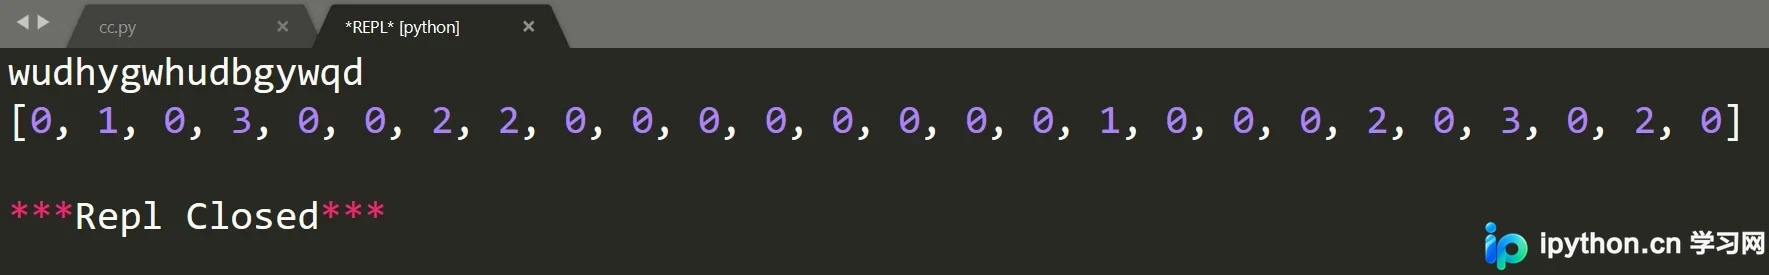
以上就是Python统计字符串中字母出现次数代码实例的详细内容,更多关于Python字符串处理与字典应用技巧的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















