


Python网络爬虫架构与运行流程详解

发布时间:2026-10-12 |
4人浏览过
本文详细解析Python网络爬虫的基本工作原理及系统架构。从发起请求、获取响应、解析内容到保存数据四个步骤阐述抓取流程,并深入剖析调度器、URL管理器、下载器、解析器及存储器五大核心模块的功能与协作机制,旨在帮助开发者构建高效、模块化的爬虫系统。
1 前言
在Python中开发网络爬虫以获取网页数据,通常遵循以下基本流程:
发起请求
利用目标URL向服务器发送Request请求,该请求可携带额外的Header信息以模拟浏览器行为或传递必要参数。
获取响应内容
当服务器正常处理请求后,会返回Response对象,其中包含所请求的网页内容。这些内容可能表现为HTML代码、JSON字符串或二进制数据(如视频、图片文件等)。
解析内容
针对不同类型的响应内容进行相应处理:若为HTML代码,使用网页解析器提取所需信息;若为JSON数据,将其转换为JSON对象进行解析;若为二进制数据,则将其保存至本地文件以便后续处理。
保存数据
解析后的数据可存储至本地文件,或存入数据库系统(如MySQL、Redis、MongoDB等)中。

2 爬虫程序架构及运行流程
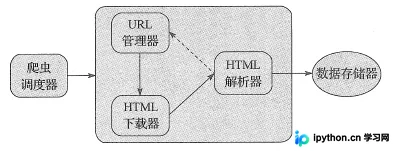
一个完整的网络爬虫程序框架通常由以下五大核心模块构成:
- 爬虫调度器
- URL管理器
- HTML下载器
- HTML解析器
- 数据存储器
这五大模块的具体功能分工如下:
- 爬虫调度器:作为中枢,负责统筹并协调其他四个模块的工作,确保整个爬虫流程有序运行。
- URL管理器:负责管理待抓取和已抓取的URL链接,维护已爬取URL集合与未爬取URL集合,并提供获取新URL链接的接口。
- HTML下载器:从URL管理器中获取未爬取的URL链接,负责将对应的HTML网页内容下载下来。
- HTML解析器:接收HTML下载器传来的已下载网页,从中解析出新的URL链接并交由URL管理器处理,同时提取有效数据并提交给数据存储器。
- 数据存储器:负责将HTML解析器提取出的有效数据,通过文件写入或数据库存储的方式持久化保存。
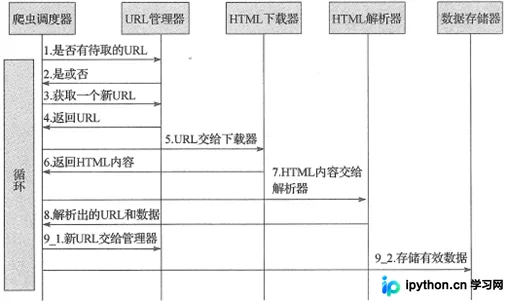
网络爬虫程序框架的动态运行流程如下图所示:
3 小结
本文简要介绍了Python网络爬虫的程序框架,将运行流程按功能划分为不同模块,实现各司其职、协同运作。搭建完善的网络爬虫框架能有效提升开发效率,避免重复造轮子。
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















