


Python实现最大似然估计与scipy.stats库详解

发布时间:2026-10-11 |
4人浏览过
本文详解如何在Python中利用scipy.stats库实现最大似然估计(MLE)。通过norm模块演示正态分布参数的MLE计算与可视化,并解析hypergeom模块中超几何分布累计概率函数的参数含义,涵盖从环境配置到代码验证的完整流程。
环境准备与库导入
在开始之前,需确保环境中已安装 scipy 库。若未安装,可通过以下命令进行配置:
pip install scipy安装完成后,在Python脚本中导入所需的模块。我们需要从 scipy.stats 中导入 norm(正态分布)和 hypergeom(超几何分布),同时引入 matplotlib.pyplot 用于绘图,以及 numpy 处理数值计算:
from scipy.stats import norm, hypergeom
import matplotlib.pyplot as plt
import numpy as np
正态分布的最大似然估计实现
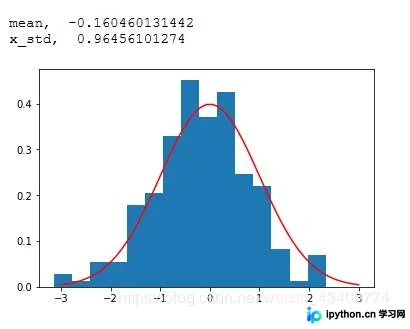
scipy.stats.norm 提供了处理正态分布的核心方法。其中 norm.fit() 函数可直接返回给定数据下各参数的最大似然估计(MLE)值。具体实现步骤如下:
- 生成测试数据:使用
norm.rvs(size=200)生成包含200个样本的随机变量数据。 - 计算MLE:调用
norm.fit(x_norm),该函数返回均值(mean)和标准差(std)的最大似然估计值。 - 可视化验证:绘制归一化直方图,并在其上叠加概率密度函数(PDF)曲线,以直观展示估计结果与理论分布的吻合度。
完整代码如下:
x_norm = norm.rvs(size=200)
# 在这组数据下,计算正态分布参数的最大似然估计值
x_mean, x_std = norm.fit(x_norm)
print('mean, ', x_mean)
print('x_std, ', x_std)

# 绘制归一化直方图(用频率代替次数),区间数设为15
plt.hist(x_norm, normed=True, bins=15)

# 在(-3, 3)之间生成50个均匀间隔的数字
x = np.linspace(-3, 3, 50)
# 绘制概率密度函数曲线
plt.plot(x, norm.pdf(x), 'r-')
plt.show()
代码中关键函数的作用说明如下:
norm.cdf:返回对应的累计分布函数值。norm.pdf:返回对应的概率密度函数值。norm.rvs:产生指定参数的随机变量。norm.fit:返回给定数据下,各参数的最大似然估计(MLE)值。
超几何分布累计概率计算
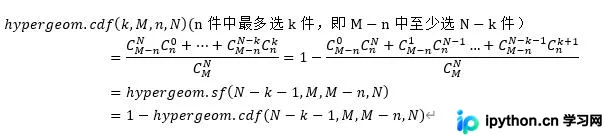
除了正态分布,scipy.stats 还提供了 hypergeom 模块用于处理超几何分布。其中 hypergeom.cdf() 用于计算超几何分布的累计概率。其函数签名为 hypergeom.cdf(k, M, n, N),各参数的具体含义如下:
M:产品总数。n:次品数量。N:随机抽取的数量。k:次品最大包含数(即计算抽取的样本中次品数小于等于k的概率)。
通过合理设置这些参数,可以精确计算特定抽样场景下的概率分布情况。
总结
本文通过Python代码演示了如何利用scipy库进行最大似然估计,并详细解析了正态分布与超几何分布相关函数的用法。掌握这些工具,有助于在数据分析与统计建模中更高效地处理概率分布问题。以上就是Python实现最大似然估计与scipy.stats库使用的详细内容,更多关于Python统计库的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















