


Python pandas groupby函数详解:从基础分组到高级聚合应用

本文详解Python中pandas库的groupby函数,涵盖单类分组、多类分组及时间序列分组场景。通过describe、unstack、agg、first、filter等方法的组合使用,演示如何高效进行数据分组统计、多函数聚合运算及特定条件过滤,帮助开发者掌握数据清洗与分析的核心技巧。
一、groupby 能做什么?
在Python数据处理中,groupby函数的核心作用是实现数据的分组操作以及基于分组的内部运算。
所谓数据的分组与分组运算,主要依托于groupby函数的应用,其基本语法结构如下:
df[输出结果列名].groupby([分类属性1, 分类属性2...])(指定用于分组的列,可指定多个).mean()(指定对分组数据进行的具体计算函数,如均值等)
具体示例如下:
print(df["评分"].groupby([df["地区"],df["类型"]]).mean())
#上面语句的功能是输出表格所有数据中不同地区不同类型的评分数据平均值
二、单类分组
A.groupby("性别")
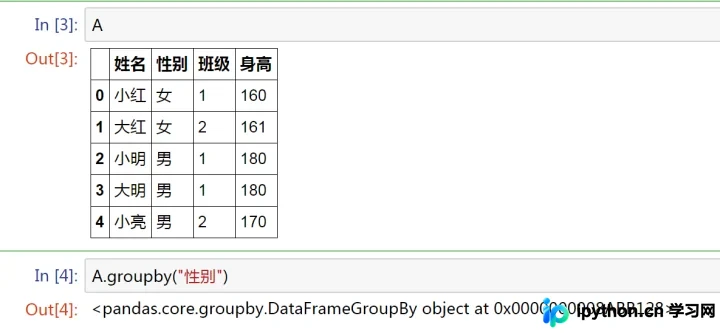
首先,假设我们有一个名为A的DataFrame类型变量。
我们的目标是根据【性别】这一列进行数据分组。
执行分组后,返回的结果是一个Groupby对象,此时尚未进行任何实际的数值计算。
describe()
用于获取组内数据的基本统计描述信息。
A.groupby("性别").describe().unstack()
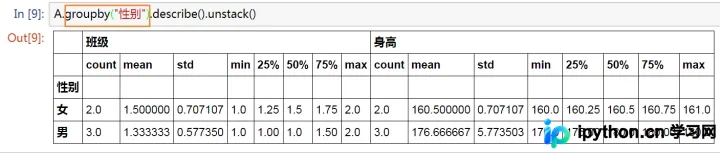
* 注意:只有数值类型的列才会被计算统计量。
* 在示例数据中,数值类型的列包括【班级】和【身高】。
然而,我们通常不需要统计班级的均值等指标,而只关注【身高】,因此需要对上述操作进行微调:
A.groupby("性别")["身高"].describe().unstack()
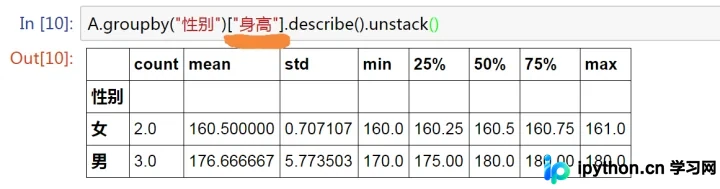
unstack()
用于索引的重排与转换。
在上述示例中,使用了一个小技巧,即通过unstack()使运算结果更便于对比查看。感兴趣的读者可以尝试去除unstack(),对比显示效果的差异。
三、多类分组
A.groupby( ["班级","性别"])
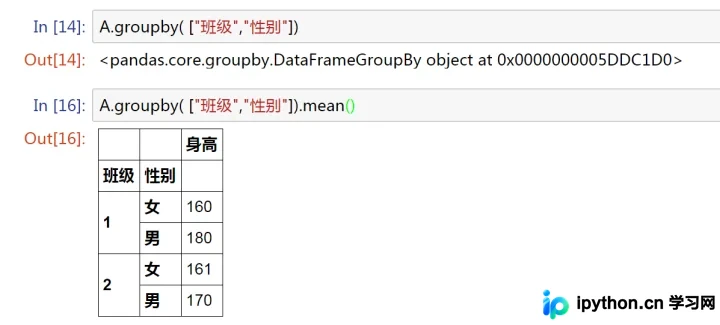
如果仅使用groupby,得到的仍然是一个Groupby对象。
mean()
用于计算组内的均值。
DataFrame中的许多函数可以直接应用于Groupby对象上。
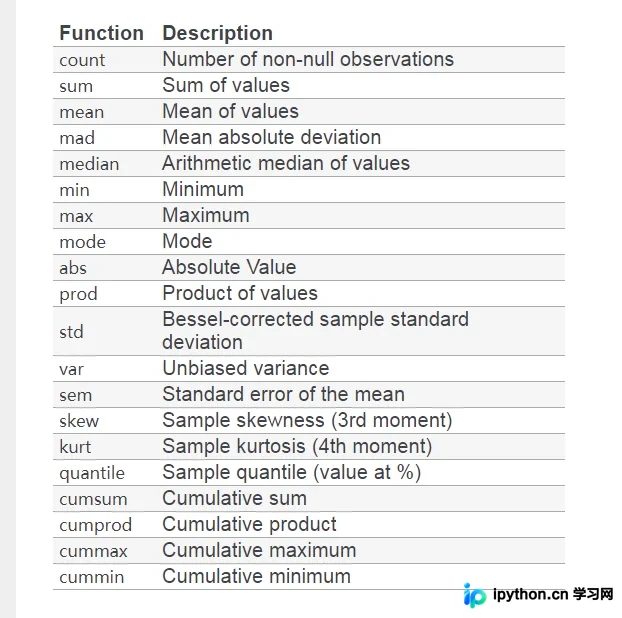
上图截取自pandas官方文档,此处不再逐一列举所有可用函数。
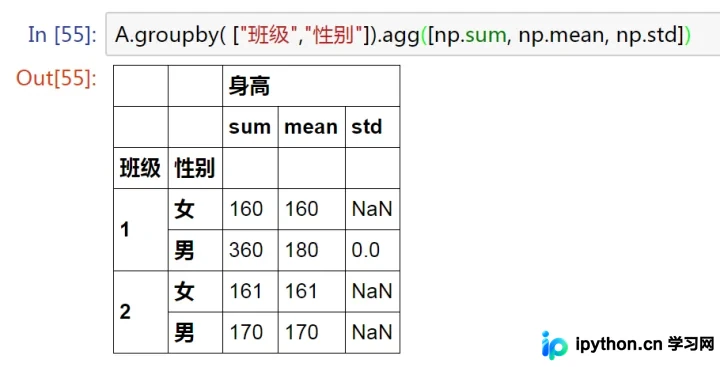
我们还可以在一次操作中应用多个计算函数。
A.groupby( ["班级","性别"]).agg([np.sum, np.mean, np.std]) # 一次计算了三个
agg()
用于执行分组后的多重运算。
四、时间分组
时间序列数据可以直接作为DataFrame的索引,或者单独存在于一列中,这两种情况的处理差异不大。
此处仅演示将某一列作为时间序列的情况。
为变量A新增一列【生日】。由于原始数据中的分隔符为“/”,直接查看列属性会发现【生日】列的数据类型并非日期类型。
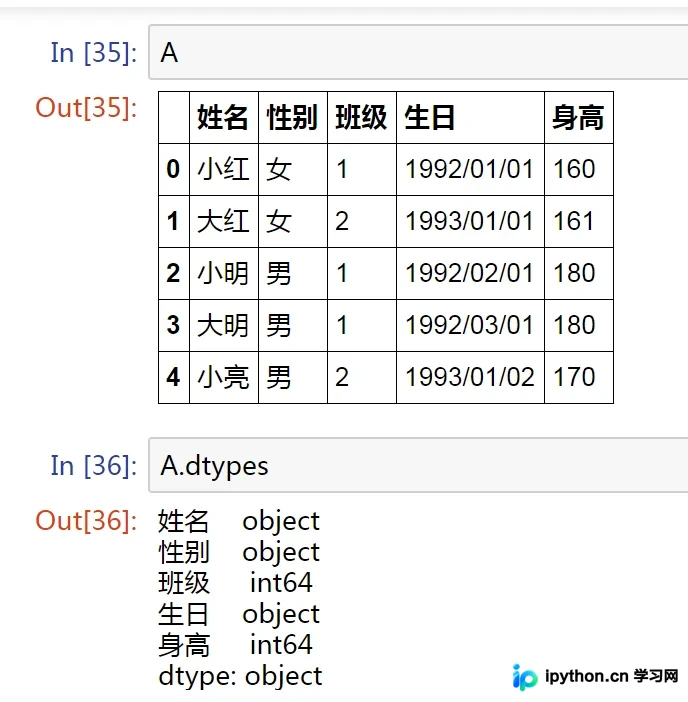
我们的目标是:
1、按照【生日】的【年份】进行分组,统计同龄人的数量。
A["生日"] = pd.to_datetime(A["生日"],format ="%Y/%m/%d") # 转化为时间格式
A.groupby(A["生日"].apply(lambda x:x.year)).count() # 按照【生日】的【年份】分组
在此基础上,进一步的需求是:
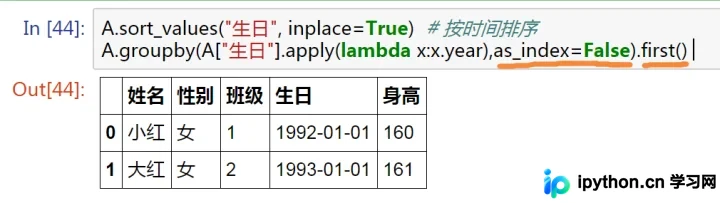
2、将同一年出生的人视为一个小组,并选出小组内生日最早的那位作为“小队长”。
A.sort_values("生日", inplace=True) # 按时间排序
A.groupby(A["生日"].apply(lambda x:x.year),as_index=False).first()
as_index=False
用于保持原始数据索引结构不变,避免索引被转换为分组键。
first()
用于保留每组中的第一个数据记录。
Tail(n=1)
用于保留每组中的最后n个数据记录。
再进一步的需求:
3、找出哪个月份只有一个人过生日。
A.groupby(A["生日"].apply(lambda x:x.month),as_index=False) # 到这里是按月分组
A.groupby(A["生日"].apply(lambda x:x.month),as_index=False).filter(lambda x: len(x)==1)
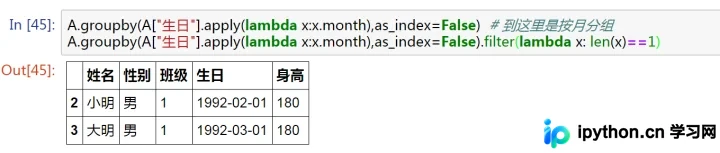
filter()
用于对分组结果进行过滤,仅保留满足括号内条件的分组。
以上就是groupby函数最常用的功能总结。
利用first()和tail()可以截取每组的前后几个数据。
利用apply()可以对每组执行自定义函数运算。
利用filter()可以选取满足特定条件的分组。
到此这篇关于详解python中groupby函数通俗易懂的文章就介绍到这了,更多相关python groupby函数内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















