


详解Python遍历列表时删除元素的正确做法

发布时间:2026-10-12 |
2人浏览过
本文深入解析在Python中遍历列表并删除元素时的常见错误及四种正确解决方案。通过对比直接删除、新建列表操作、filter函数及列表解析和倒序遍历等方法,详细阐述其原理与适用场景,帮助开发者避免索引偏移导致的漏删问题,提升代码健壮性。
一、问题描述
在实际开发中,我们常遇到此类场景:遍历列表,筛选出符合特定条件的元素,并移除不符合条件的元素,最终保留符合条件的列表。其核心逻辑大致如下所示:
a = [1,2,3,4,5,6,7,8]
for i in a:
  if i>5:
    pass
  else:
    a.remove(i)
  print(a)
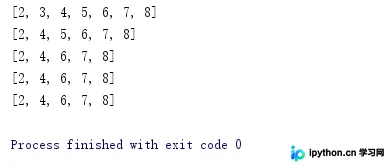
执行上述代码后的输出结果如下:
二、问题原因分析
出现该问题的根本原因在于,当从列表中删除元素时,后续所有元素的索引会向前移动一位。然而,遍历过程中的索引变量 i 是随着循环递增的,这导致原本应该被检查的元素被跳过,从而无法得到预期的过滤结果。
三、解决方案
方法一:遍历副本,操作原列表
a = [1,2,3,4,5,6,7,8]
print(id(a))
print(id(a[:]))
for i in a[:]:
  if i>5:
    pass
  else:
    a.remove(i)
  print(a)
print('-------------------------')
print(id(a))
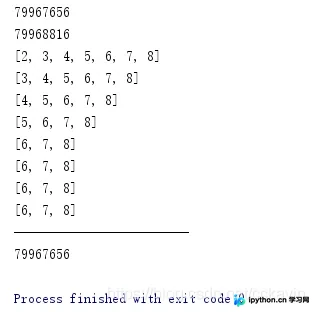
该方法的执行结果如下:
方法二:使用 filter 函数
关于内建函数 filter() 的官方文档参考链接为:https://docs.python.org/3/library/functions.html#filter
a = [1,2,3,4,5,6,7,8]
b = filter(lambda x: x>5,a)
print(list(b))
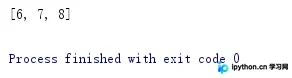
使用 filter 函数的运行结果如下:
方法三:使用列表解析(List Comprehension)
a = [1,2,3,4,5,6,7,8]
b = [i for i in a if i >5]
print(b)
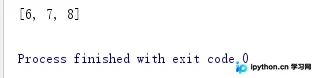
列表解析方式的运行结果如下:
方法四:倒序遍历并删除
由于列表元素在删除后总是“向前移动”,如果我们采用倒序遍历的方式,即使后续元素被修改或删除,尚未被遍历到的元素及其索引位置依然保持不变,从而避免了索引错乱的问题。
a = [1,2,3,4,5,6,7,8]
print(id(a))
for i in range(len(a)-1,-1,-1):
  if a[i] > 5:
    pass
  else:
    a.remove(a[i])
print(id(a))
print('--------------------')
print(a)
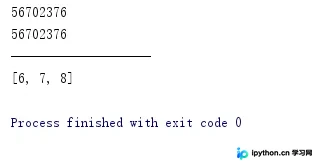
倒序删除方法的运行结果如下:
至此,关于详解Python遍历列表时删除元素的正确做法的文章介绍完毕。如需了解更多关于Python遍历列表删除元素的相关内容,欢迎搜索本站历史文章或继续浏览后续文章。感谢大家的支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















