



很多 Python 项目真正卡住的,不是怎么写一条 SQL,而是远程连不上 MySQL、驱动认证不兼容,或者代码能跑通却不清楚什么时候该提交事务、什么时候该上连接池。下面这篇按“先打通连接,再覆盖常见操作,最后补齐事务与性能”的顺序整理一遍,并继续沿用文中的两台服务器示例:MySQL 服务器 192.168.10.101、Python 服务器 192.168.10.102,方便你直接对照环境排查。
安装 Python MySQL 驱动
先装上连接库
文中给出了两条安装命令,适合先把常用驱动准备好:
pip install mysql-connector-python
pip install pymysql
如果后面还要演示连接池,还需要额外安装:
pip install dbutils
这几个库分别适合什么场景
- pymysql:纯 Python 实现,跨平台,支持 TCP/IP 远程连接,部署简单,教程里大部分示例也都基于它。
- mysql-connector-python:MySQL 官方驱动,适合作为
pymysql的备选方案。 - dbutils:不是驱动,而是数据库连接池组件,用来复用连接,减少频繁创建和销毁连接的开销。
- 生产环境建议固定依赖版本,避免驱动升级后出现兼容性问题。
MySQL 服务端怎么放开远程访问
这一部分全部在 MySQL 命令行中执行,入口命令是 mysql -u root -p。如果 Python 代码写得没问题却始终连不上,通常要先回到这里检查账号、授权和认证方式。
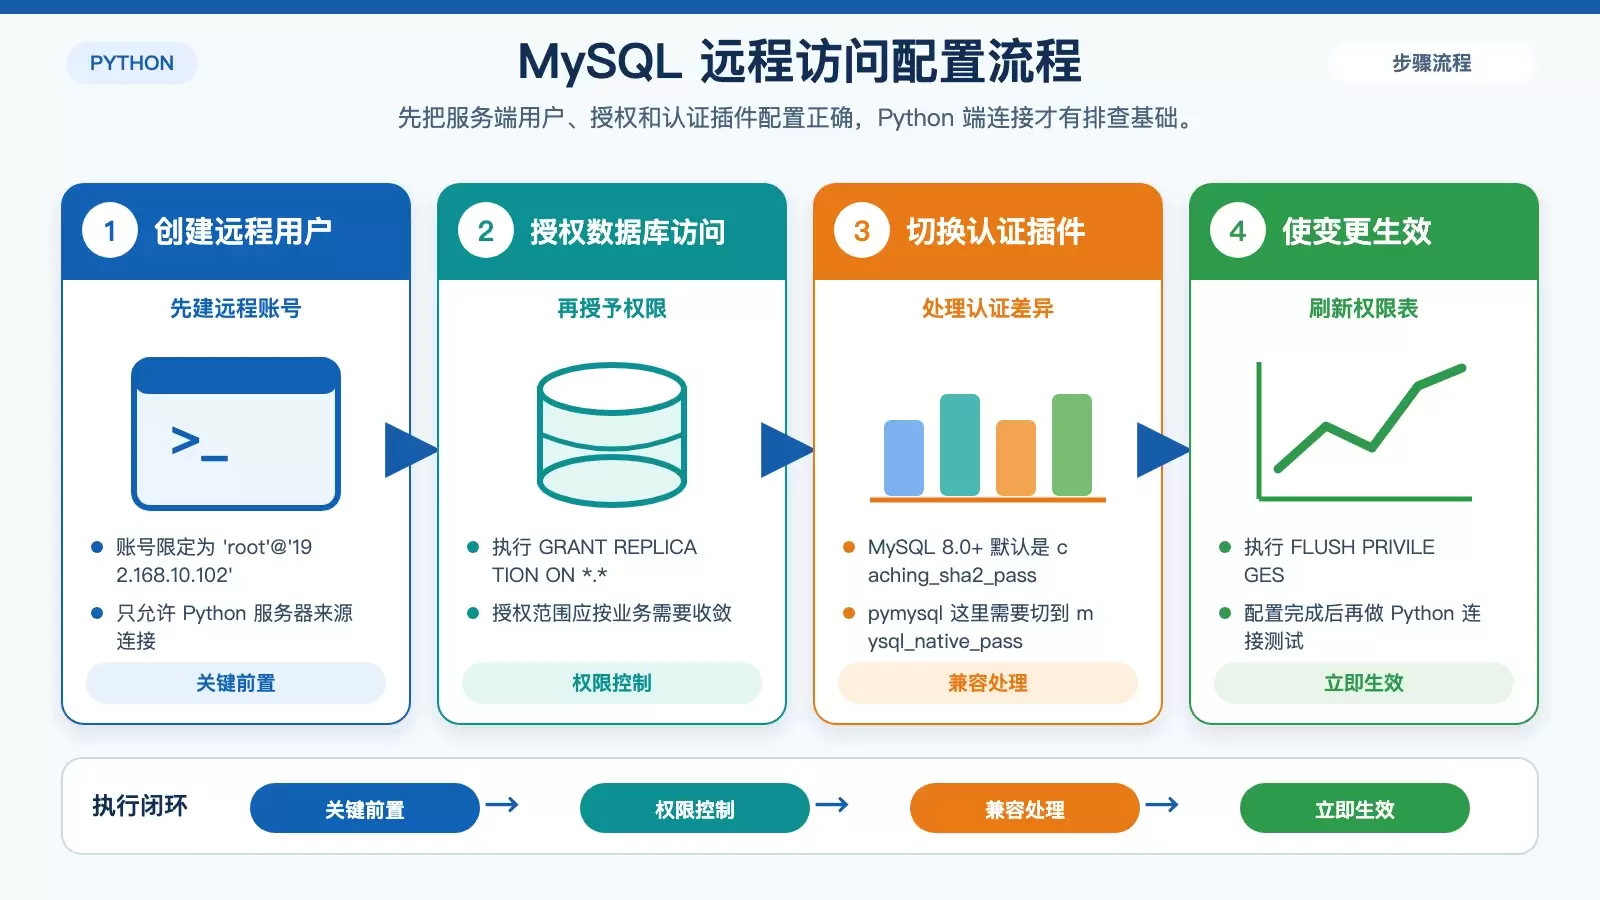
创建只允许指定主机访问的用户
CREATE USER 'root'@'192.168.10.102' IDENTIFIED BY 'pwd123';
这里的 @'192.168.10.102' 很关键,它表示只有这台 Python 服务器可以用这个账号连接 MySQL,相比直接放开任意来源更安全。
授予数据库权限
GRANT REPLICATION ON *.* TO 'root'@'192.168.10.102';
原文保留的是这条授权语句,实际使用时应根据业务需要最小化授权范围,避免直接给过大的权限集合。
为什么 MySQL 8.0+ 还要改认证插件
文中专门点出了一个常见坑:MySQL 8.0+ 默认认证插件是 caching_sha2_password,而这里使用的 pymysql 不支持它,因此需要切换为旧插件 mysql_native_password:
ALTER USER 'root'@'192.168.10.102' IDENTIFIED WITH mysql_native_password BY 'pwd123';
如果你的报错集中在认证失败、握手失败,这一步通常比反复修改 Python 代码更值得先查。
刷新权限让配置生效
FLUSH PRIVILEGES;
授权和用户变更之后,别漏掉这一步。
准备测试库、表和演示数据
为了验证连接、查询、更新和关联查询,先在 MySQL 侧准备一套可直接复用的数据:
-- 创建数据库
CREATE DATABASE IF NOT EXISTS testdb;

-- 切换到 testdb 数据库
USE testdb;

-- 创建 users 表
CREATE TABLE IF NOT EXISTS users (
    id INT AUTO_INCREMENT PRIMARY KEY,
    name VARCHAR(100) NOT NULL,
    age INT NOT NULL
);

-- 创建 orders 表
CREATE TABLE IF NOT EXISTS orders (
    id INT AUTO_INCREMENT PRIMARY KEY,
    user_id INT,
    amount DECIMAL(10, 2) NOT NULL,
    order_date TIMESTAMP DEFAULT CURRENT_TIMESTAMP,
    FOREIGN KEY (user_id) REFERENCES users(id) ON DELETE CASCADE
);

-- 插入数据到 users 表
INSERT INTO users (name, age) VALUES
('Alice', 25),
('Bob', 30),
('Charlie', 35),
('Da vid', 28);

-- 插入数据到 orders 表
INSERT INTO orders (user_id, amount) VALUES
(1, 100.50),
(2, 150.75),
(3, 200.00),
(1, 50.25);

-- -- 查询所有用户信息
-- SELECT * FROM users;

-- -- 查询所有订单信息
-- SELECT * FROM orders;

-- -- 查询用户及其对应的订单信息(JOIN查询)
-- SELECT users.name, users.age, orders.amount
-- FROM users
-- JOIN orders ON users.id = orders.user_id;

-- -- 更新某个用户的数据,修改 Bob 的年龄
-- UPDATE users SET age = 31 WHERE name = 'Bob';

-- -- 删除 Charlie 用户及其对应的订单数据
-- DELETE FROM orders WHERE user_id = (SELECT id FROM users WHERE name = 'Charlie');
-- DELETE FROM users WHERE name = 'Charlie';

-- -- 设置事务隔离级别为 REPEATABLE READ
-- SET TRANSACTION ISOLATION LEVEL REPEATABLE READ;
这组数据里已经包含了两张表和外键关系,后面做 JOIN、删除和事务演示时都能直接用上。
Python 如何连上远程 MySQL
基础连接示例
先用最小脚本确认网络、账号和数据库名都没问题。原文示例文件为 01_connect.py:
import pymysql

db = pymysql.connect(
    host="192.168.10.101",  #MySQL数据库的地址
    user="root",           #数据库的用户名
    password="pwd123",     #密码
    database="testdb",     #要连接的数据库的名称
    charset="utf8mb4"
)         #创建数据库的连接

cursor = db.cursor()   #创建游标对象

cursor.execute("select * from users")   #执行SQL语句

results=cursor.fetchall()
for row in results:
    print(row)       #获取查询结果

data = cursor.fetchone()
print("MySQL 版本:", data)

cursor.close()   #关闭游标连接
db.close()     #关闭数据库连接
执行命令:
python3 01_connect.py
连接参数里最容易忽略的几个点
- host 必须写远程 MySQL 的 IP,也就是
192.168.10.101,不能写localhost。 charset="utf8mb4"是更稳妥的默认选择,支持中文和表情字符。cursor负责执行 SQL 和读取结果。- 游标和连接用完后要关闭,否则长时间运行的程序容易积累资源占用。
另外,这段示例里先调用了 fetchall(),后面又调用 fetchone(),实际运行时第二次读取往往拿不到前面已经取走的结果集。把它视为“连接与查询演示”更合适,正式代码中应根据读取方式二选一设计结果处理逻辑。
常见 CRUD、模糊查询和 JOIN 怎么写
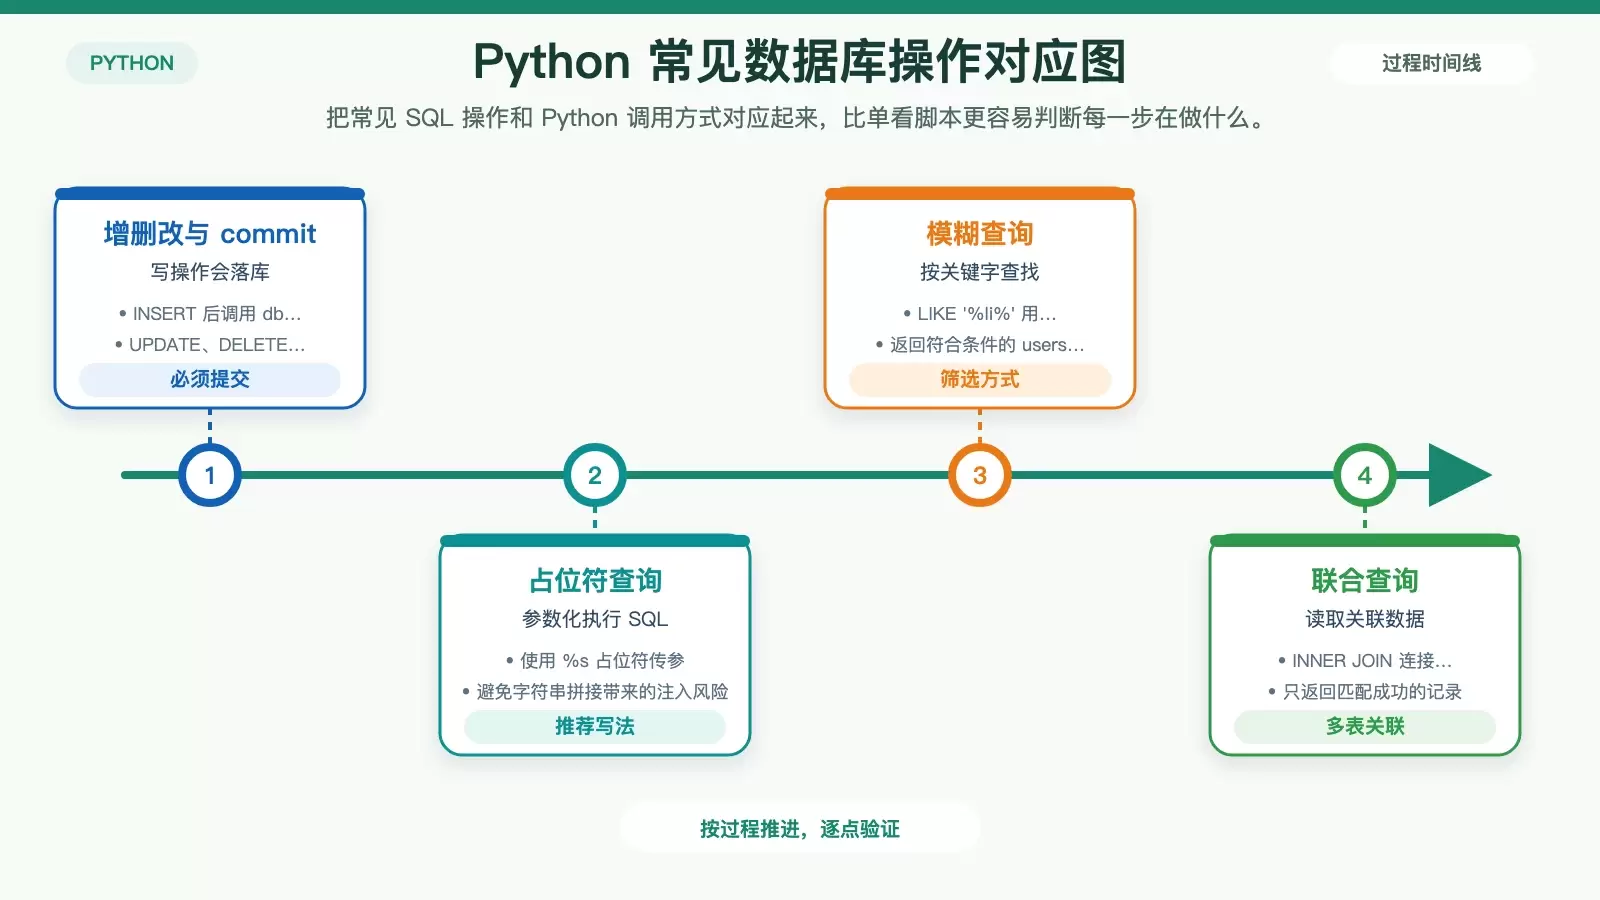
当基础连接确认无误后,就可以把增删改查、模糊匹配和联合查询串起来测试。原文示例文件为 02_operate.py:
import pymysql

db = pymysql.connect(
    host="192.168.10.101",
    user="root",
    password="pwd123",
    database="testdb",
    charset="utf8mb4"
)
cursor = db.cursor()

# 创建表
cursor.execute("""
CREATE TABLE IF NOT EXISTS users (
    id INT AUTO_INCREMENT PRIMARY KEY,
    name VARCHAR(50),
    age INT
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;
""")

# 插入
cursor.execute("INSERT INTO users(name, age) VALUES(%s, %s)", ("Alice", 25))
db.commit()

# 查询
cursor.execute("SELECT * FROM users")
results = cursor.fetchall()
for row in results:
    print(row)

# 更新
cursor.execute("UPDATE users SET age=%s WHERE name=%s", (26, "Alice"))
db.commit()

# 删除
cursor.execute("DELETE FROM users WHERE name=%s", ("Alice",))
db.commit()

# 模糊查询
cursor.execute("SELECT * FROM users WHERE name LIKE %s", ("%li%",))
print("模糊查询:", cursor.fetchall())

# 联合查询
cursor.execute("""
SELECT users.name, orders.amount
FROM users
INNER JOIN orders ON users.id = orders.user_id
""")
print("联合查询:", cursor.fetchall())

cursor.close()
db.close()
执行命令:
python3 02_operate.py
这段代码值得记住的细节
- 增删改之后必须调用
commit(),否则修改不会真正写入数据库。 - 使用
%s占位符传参,而不是自己拼接字符串,有助于防止 SQL 注入。 fetchall()用于读取全部结果,fetchone()只读取一条。LIKE "%li%"对应全模糊匹配。INNER JOIN只返回两表中匹配成功的记录。
事务该怎么控制,回滚在什么情况下有用
如果一组操作必须“要么都成功,要么都失败”,就不能只靠逐条执行 SQL,而是要显式使用事务。原文示例文件为 03_transaction.py:
import pymysql

db = pymysql.connect(
    host="192.168.10.101",
    user="root",
    password="pwd123",
    database="testdb"
)
cursor = db.cursor()

db.autocommit = False

try:
    cursor.execute("INSERT INTO users(name, age) VALUES('Tom', 20)")
    cursor.execute("UPDATE users SET age=21 WHERE name='Tom'")
    db.commit()
    print("事务执行成功")
except:
    db.rollback()
    print("事务已回滚")
finally:
    cursor.close()
    db.close()
执行命令:
python3 03_transaction.py
用这个例子理解 ACID
- 原子性(Atomicity):插入和更新要么都成功,要么一起回滚。
- 一致性(Consistency):事务执行前后,主键、外键、非空等约束不能被破坏。
- 隔离性(Isolation):并发事务之间彼此隔离,避免脏读、不可重复读和幻读等问题。
- 持久性(Durability):一旦
commit()成功,数据修改就会持久保存。
这也是为什么转账、库存扣减、订单落库这类场景通常都离不开事务控制。
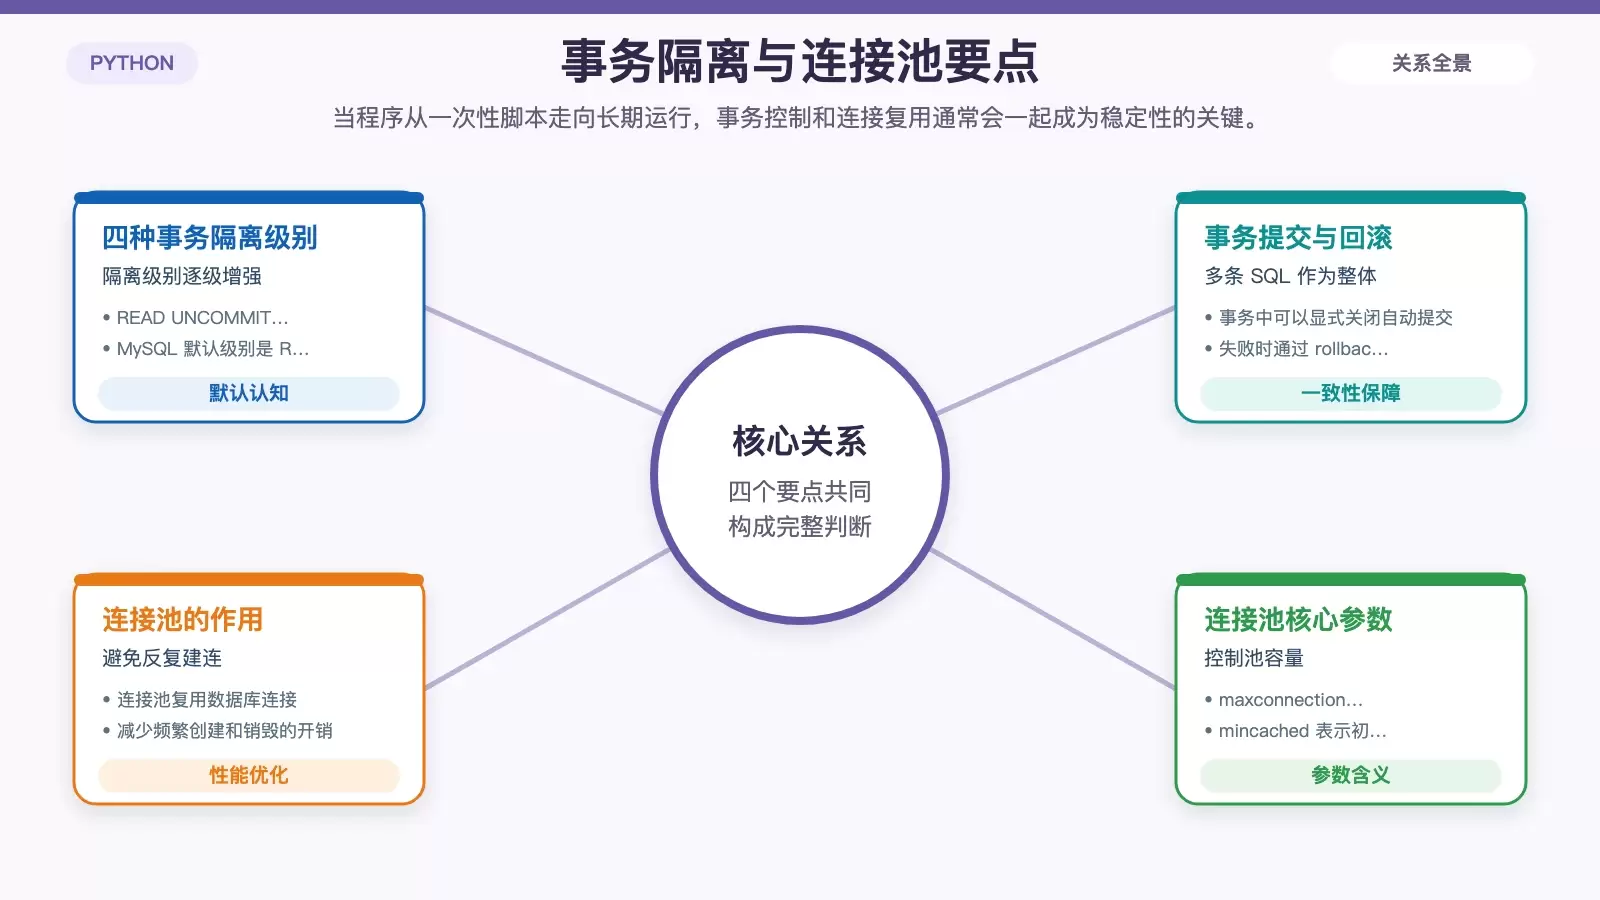
MySQL 四种事务隔离级别怎么选
隔离级别可以直接在 MySQL 命令行中设置:
SET TRANSACTION ISOLATION LEVEL READ UNCOMMITTED;
SET TRANSACTION ISOLATION LEVEL READ COMMITTED;
SET TRANSACTION ISOLATION LEVEL REPEATABLE READ;
SET TRANSACTION ISOLATION LEVEL SERIALIZABLE;
四种级别的差异
- READ UNCOMMITTED:可以读取未提交数据,容易产生脏读。
- READ COMMITTED:只能读取已提交数据,解决了脏读问题。
- REPEATABLE READ:MySQL 默认级别,解决脏读和不可重复读。
- SERIALIZABLE:隔离性最高,事务近似串行执行,并发性能最低。
如果你只记一个默认判断,可以先记住:MySQL 常见业务系统里最常碰到的是 REPEATABLE READ,而不是一上来就追求最高级别的 SERIALIZABLE。
什么时候该上连接池
脚本式任务用一次性连接问题不大,但只要程序会反复访问数据库,就要考虑连接池。原文示例文件为 04_pool.py:
from dbutils.pooled_db import PooledDB
import pymysql

#数据库的连接配置
pool = PooledDB(
    creator=pymysql,
    host="192.168.10.101",
    user="root",
    password="pwd123",
    database="testdb",
    charset="utf8mb4",
    maxconnections=10,
    mincached=2
)

#创建连接池
connection_pool=PooledDb(
    creator=pymysql,    #使用pymysql作为数据库连接库
    maxconnection=5,    #连接池中最大连接数
    **dbconfig
)

#获取连接
db_connection=connection_pool.connection()
cursor=db_connecction.cursor()

cursor.execute("select * from users")
results=cursor.fetchall()

for row in results:
    print(row)

cursor.close()
db_connection.close()   #连接会自动归还给连接池
执行命令:
python3 04_pool.py
连接池的核心价值
- 连接池会预先创建并复用数据库连接,减少频繁建立 TCP 和认证握手带来的开销。
close()在连接池场景下通常表示把连接归还给池,而不是直接关闭底层物理连接。maxconnections用来限制最大连接数,避免把数据库压满。mincached表示初始化时保留的空闲连接数量,可以改善启动后的首批请求延迟。
需要注意的是,原文这段连接池代码里存在一些明显的拼写和变量名问题,比如 PooledDB / PooledDb 大小写不一致、maxconnections / maxconnection 混用、dbconfig 未定义、db_connecction 拼写错误。它更适合用来理解连接池思路,真正落地时应先把这些细节校正后再运行。
从能连通到能稳定运行,该掌握哪些重点
把整套流程串起来看,Python 操作 MySQL 大致分成三层:先在服务端完成远程用户、授权和认证插件兼容,确保 pymysql 能顺利连接;再用参数化 SQL 覆盖 CRUD、模糊查询和 JOIN;最后根据业务一致性和并发压力,引入事务、隔离级别和连接池。对大多数日常开发来说,这几部分已经覆盖了远程数据库操作的核心面。















