


Python实现微博模拟登录与表情包批量抓取实战

本文介绍使用Python 3.6.4通过DecryptLogin模块模拟登录微博,并抓取指定用户发布的表情包图片。文章详细讲解了环境搭建、异步爬取被封禁的教训、以及采用随机延迟和独立UA请求等反封禁策略。通过XPath提取用户信息及图片链接,并对HTTP链接错误进行后处理,最终实现稳定下载。
一、开发工具
**Python****版本:**3.6.4
相关模块:
DecryptLogin模块;
argparse模块;
requests模块;
prettytable模块;
tqdm模块;
lxml模块;
fake_useragent模块;
以及一些Python自带的模块。
二、环境搭建
安装Python并添加到环境变量,pip安装需要的相关模块即可。
三、原理简介
原本计划将此爬虫作为Python异步爬虫的教学案例,但在昨日代码完成后进行测试时,由于并发数设置为500,导致微博账号和IP地址均被直接封禁。
随后我在谷歌上搜索了其他人编写的异步爬虫教程,发现其测试对象多为缺乏反爬机制的小型网站。
因此,今天对代码进行了调整,改为实现一个常规的微博小型爬虫。
言归正传,与之前的微博爬虫类似,我们首先利用DecryptLogin模块进行微博账户的模拟登录:
'''模拟登录'''
@staticmethod
def login(username, password):
  lg = login.Login()
  _, session = lg.weibo(username, password, 'mobile')
  return session
然后让使用者输入目标微博用户的id:
user_id = input('请输入目标用户ID(例如: 2168613091) ——> ')
微博用户id在这可以看到:
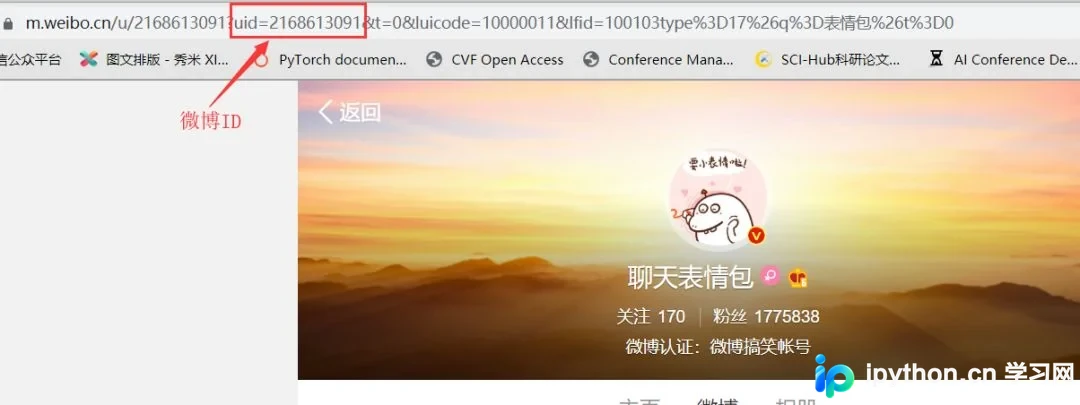
根据用户输入的微博用户id,我们访问如下两个链接:
url = f'https://weibo.cn/{user_id}'
url = f'https://weibo.cn/{user_id}/info'
然后利用xpath提取用户的基本信息:
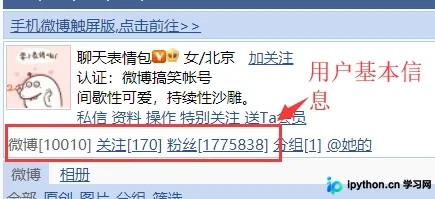
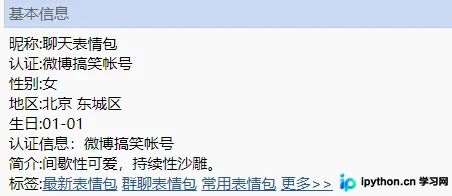
打印这些信息,让使用者确认自己输入的微博用户id是否无误:
tb = prettytable.PrettyTable()
tb.field_names = ['用户名', '关注数量', '被关注数量', '微博数量', '微博页数']
tb.add_row([nickname, num_followings, num_followers, num_wbs, num_wb_pages])
print('获取的用户信息如下:')
print(tb)
is_download = input('是否爬取该微博用户发的所有图片?(y/n, 默认: y) ——> ')
如果无误,就开始爬取该用户发的所有微博里的图片:
'''下载所有图片'''
def __downloadImages(self, userinfos, savedir):
  # 一些必要的信息
  num_wbs = userinfos.get('num_wbs')
  user_id = userinfos.get('user_id')
  num_wb_pages = userinfos.get('num_wb_pages')
  # 提取图片链接并下载图片
  page_block_size = random.randint(1, 5)
  page_block_count = 0
  for page in tqdm(range(1, num_wb_pages+1)):
    # --提取图片链接
    response = self.session.get(f'https://weibo.cn/{user_id}?page={page}', headers=self.headers)
    image_urls = self.__extractImageUrls(response)
    # --下载图片
    for url in image_urls:
      try:
        res = requests.get(url, headers={'user-agent': self.ua.random}, stream=True)
        with open(os.path.join(savedir, url.split('/')[-1]), 'wb') as fp:
          for chunk in res.iter_content(chunk_size=32):
            fp.write(chunk)
        print('[INFO]: Download an image from: ', url)
      except:
        pass
    # --避免给服务器带来过大压力and避免被封, 每爬几页程序就休息一下
    page_block_count += 1
    if page_block_count % page_block_size == 0:
      time.sleep(random.randint(6, 12))
      page_block_size = random.randint(1, 5)
      page_block_count = 0
这里避免爬虫被BAN的措施主要有以下几点:
- 每爬n页数据就暂停x秒,其中n是随机生成的,且n一直在变化,x也是随机生成的,且x也一直在变化;
- 下载图片时,使用随机的ua,并且不使用登录后的session来请求图片链接来下载该图片。
从返回的微博页内容里提取图片链接时,需要注意:
- 对转发微博的微博id和原创微博的微博id提取方式不同;
- 只有单张图片的微博和有多张图片的微博提取图片链接的方式是不同的;
- 有时候图片链接提取会出错,http变成了ttp,所以需要对提取的图片链接进行后处理,然后再去请求这些链接来下载图片。
大体的思路就是这样,因为其实没啥难点,就是用xpath来提取我们需要的信息就行了,所以就这么粗略地介绍一下吧。T_T
运行方式:
python weiboEmoji.py --username 用户名 --password 密码
到此这篇关于Python模拟登录微博并爬取表情包的文章就介绍到这了,更多相关Python爬取微博表情包内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















