


Python文件读取方法详解:read、readline与readlines的区别及适用场景

本文详细解析Python中read、readline和readlines三种文件读取方法的区别。read一次性读取全部内容,适合小文件;readline逐行读取,节省内存;readlines将内容转为列表,便于遍历。通过具体代码案例对比三者的性能与适用场景,帮助开发者根据文件大小和内存限制选择最优方案。
在Python编程中,处理文件内容时主要涉及三种读取操作:read、readline和readlines。
- read()方法用于一次性读取整个文件的内容。在实际使用中,建议采用read(size)的形式指定读取大小,需要注意的是,size参数设置得越大,程序的运行时间通常越长。
- readline()方法每次仅读取文件中的一行内容。由于这种方式对内存占用较小,因此在内存资源受限的场景下较为适用,但在常规开发中使用频率相对较低。
- readlines()方法同样一次性读取整个文件内容,但其返回值是一个列表(list),列表中的每个元素对应文件中的一行,这种结构使得后续遍历文件内容变得十分便捷。
对于小型文件,通常推荐使用read()方法;如果文件大小不确定,可以指定size参数进行控制;而对于大型文件,为了避免内存溢出,建议使用readlines()方法进行处理。
首先,我们演示如何使用read方法完整读取一个小文件,具体代码如下:
f = open('test.py', 'r')
print(f.read())
f.close()                # 用完记得关闭
以下是该代码的运行结果:
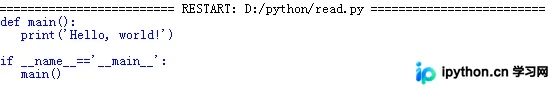
从结果可以看出,这是一个输出“Helllo World!”的简单程序示例。
由此可见,对于打印小文件这类轻量级任务,使用read方法确实效率较高。
接下来,我们查看readline方法的代码实现:
f = open('test.py', 'r')
print(f.readline())
f.close()
其运行结果如下:

正如方法名所示,它只输出了一行内容,显得较为“吝啬”。
假设原文件test.py包含五行文字,若要通过readline打印完整文件,需要执行五次print操作,略显繁琐。不过,可以通过while循环来简化这一过程:
f = open('test.py', 'r')
line = f.readline()
while line:
    print(line, end="")
    line = f.readline()
f.close()
最后,我们来看readlines方法的代码示例:
f = open('test.py', 'r')
print(f.readlines())
f.close()
运行结果如下:

结果显示,readlines将文件内容全部放入一个列表(list)中,并且保留了原有的空格和换行符(\n)。
随后,我们可以编写一个循环来遍历该列表:
f = open('test.py', 'r')
for line in f.readlines():
    print(line, end="")
f.close()
由于print函数默认会自动换行,我们可以通过设置end=""参数来取消自动换行,从而保持原始格式。
运行效果如图所示:
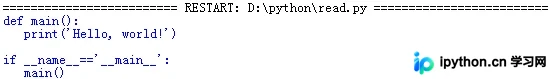
这样,我们就得到了与使用read方法相似的输出内容。
然而,在处理配置文件时,readlines方法具有一定的优势,因为它可以直接将每一行作为列表元素进行处理。
至此,关于Python中read、readline和readlines区别的详细案例介绍完毕。如需了解更多相关内容,欢迎搜索本站往期文章或继续浏览后续文章,感谢大家的支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















