


Python lxml中XPath复用时的相对路径陷阱与解决方案

本文详解Python中使用lxml进行XPath定位时,在循环内复用XPath表达式常遇到的陷阱。当使用绝对路径(如//td)时,解析器会重新搜索整个文档而非当前节点,导致返回错误数量的元素。核心解决方案是在XPath前添加点号(.//td)以指定相对路径,确保搜索范围限制在当前节点及其子节点内,从而准确获取预期数据。
在使用Python进行网页数据抓取时,利用XPath定位元素是常见操作。然而,开发者经常遇到一种情况:先通过XPath定位到某个父级元素,进入for循环后,试图在该父级元素下继续使用XPath查找子元素,此时却出现了定位错误或结果不符合预期的问题。以下是一个典型示例:
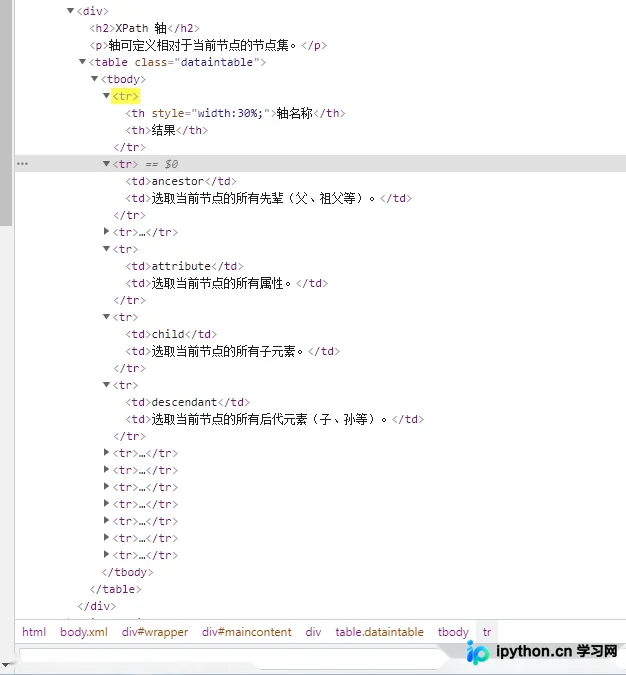
假设我们通过XPath定位到了<tr>标签。需要注意的是,浏览器在渲染HTML时会自动补全缺失的<tbody>层级,但在Python的lxml解析树中,这个自动生成的tbody节点可能并不存在或结构不同。因此,在编写XPath时,需要忽略浏览器自动生成的tbody层级,直接针对实际的DOM结构进行定位。
接下来,我们的目标是获取每个<tr>标签下的<td>元素。具体的代码实现如下所示:
import requests
from lxml import etree

url = "https://www.w3school.com.cn/xpath/xpath_axes.asp"
res = requests.get(url).text
html = etree.HTML(res)
a = html.xpath("(//table[@class='dataintable'])[1]/tr")
print(a)

for i in a:
    s = i.xpath("//td")
    print(s)
    print(len(s))
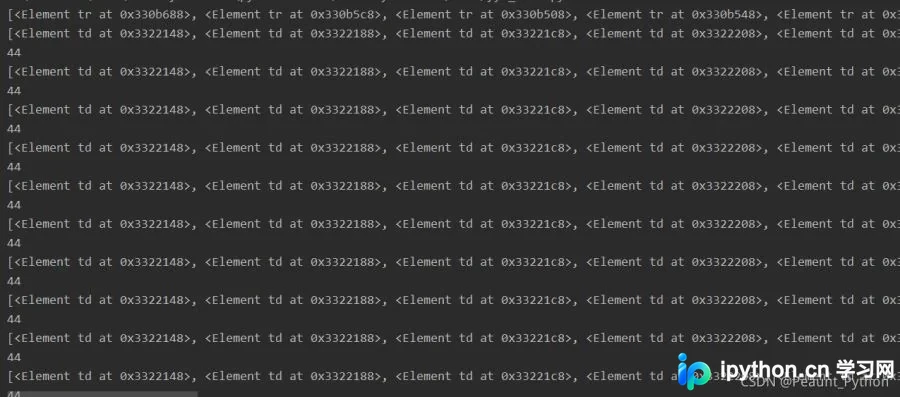
在for循环遍历变量a的过程中,我们期望从每个tr中提取其下属的td。理论上,每个tr下只有两个td元素,但实际运行结果却返回了页面中所有的44个td。造成这一问题的根源在于XPath表达式的写法:s = i.xpath("//td")。尽管变量i已经继承了a的XPath上下文,但使用双斜杠//表示绝对路径,这会指示XPath解析器从文档根节点重新开始搜索整个DOM树,从而忽略了当前的上下文节点。正确的做法是使用相对路径,即在斜杠前加上一个点号:s = i.xpath(".//td")。这里的单点(.)代表当前节点,双点(..)代表父节点,明确指定了搜索范围应局限于当前节点及其子树。
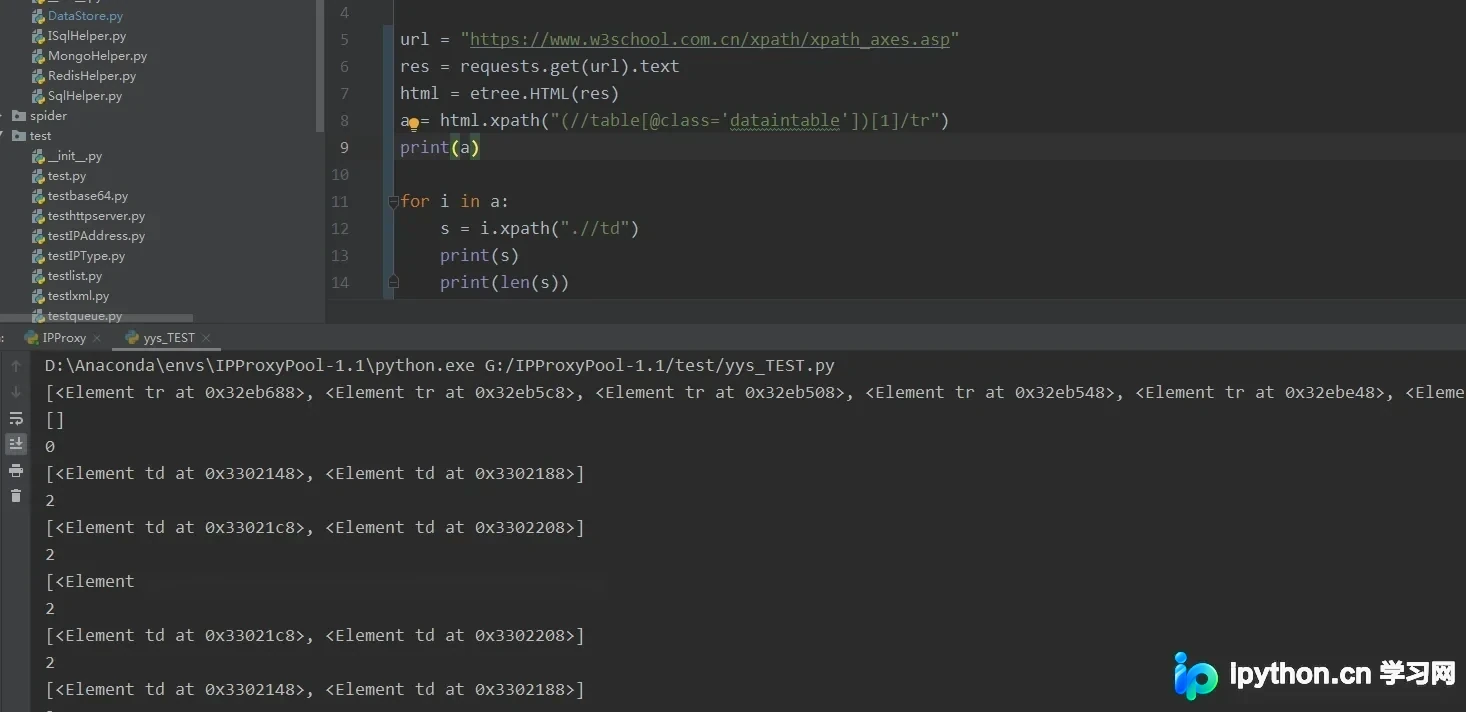
修正表达式后,再次运行代码,搜索结果恢复正常,仅返回当前tr下的td元素。
总结来说,如果在初始搜索时直接编写完整的绝对路径,例如 (//table[@class='dataintable'])[1]/tr//td,直接定位到td元素,则无需使用点号前缀。但在复用XPath表达式、特别是在循环中基于已定位的节点进行二次查询时,必须使用点号(.//)来表明这是相对路径搜索。否则,解析器会执行全局搜索,导致无法获取预期的局部结果。
以上就是关于Python中lxml XPath复用技巧的详细说明。希望读者能避免常见的路径陷阱,提高数据抓取的准确性。如需了解更多Python XPath相关内容,欢迎查阅本站过往文章或继续关注后续更新,感谢支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















