


JavaScript 平铺数组转树形结构:高性能实现方案

在处理后台下发的万级平铺数组并渲染至级联选择器时,递归转换易因高时间复杂度导致页面卡顿。本文对比了递归与非递归两种方案,推荐使用基于对象引用的非递归算法,将时间复杂度从 $O(n\log n)$ 降低至 $O(n)$,大幅提升了大数据量下的构建效率。
场景与目标
在实际开发中,后台有时会将庞大的层级数据以平铺形式返回。例如 Element-ui 的级联选择器(Cascader)通常接收嵌套的树形结构,而数据库或 API 返回的往往是扁平列表:
const flatArr = [
  { id: '001', name: '节点1' },
  { id: '0011', parentId: '001', name: '节点1-1' },
  { id: '00111', parentId: '0011', name: '节点1-1-1' },
  { id: '002', name: '节点2' }
]
我们的目标是将上述 flatArr 转换为包含 children 属性的树形结构:
let treeOptions = [
  {
    value: '001',
    label: '节点1',
    children: [
      {
        value: '0011',
        label: '节点1-1',
        children: [{ value: '00111', label: '节点1-1-1' }]
      }
    ]
  },
  { value: '002', label: '节点2' }
]
递归方式及其局限性
初学者常采用递归思路:遍历一次源数组,对每个节点再次遍历数组寻找其子节点。虽然逻辑直观且代码紧凑,但在数据量较大时性能急剧下降。
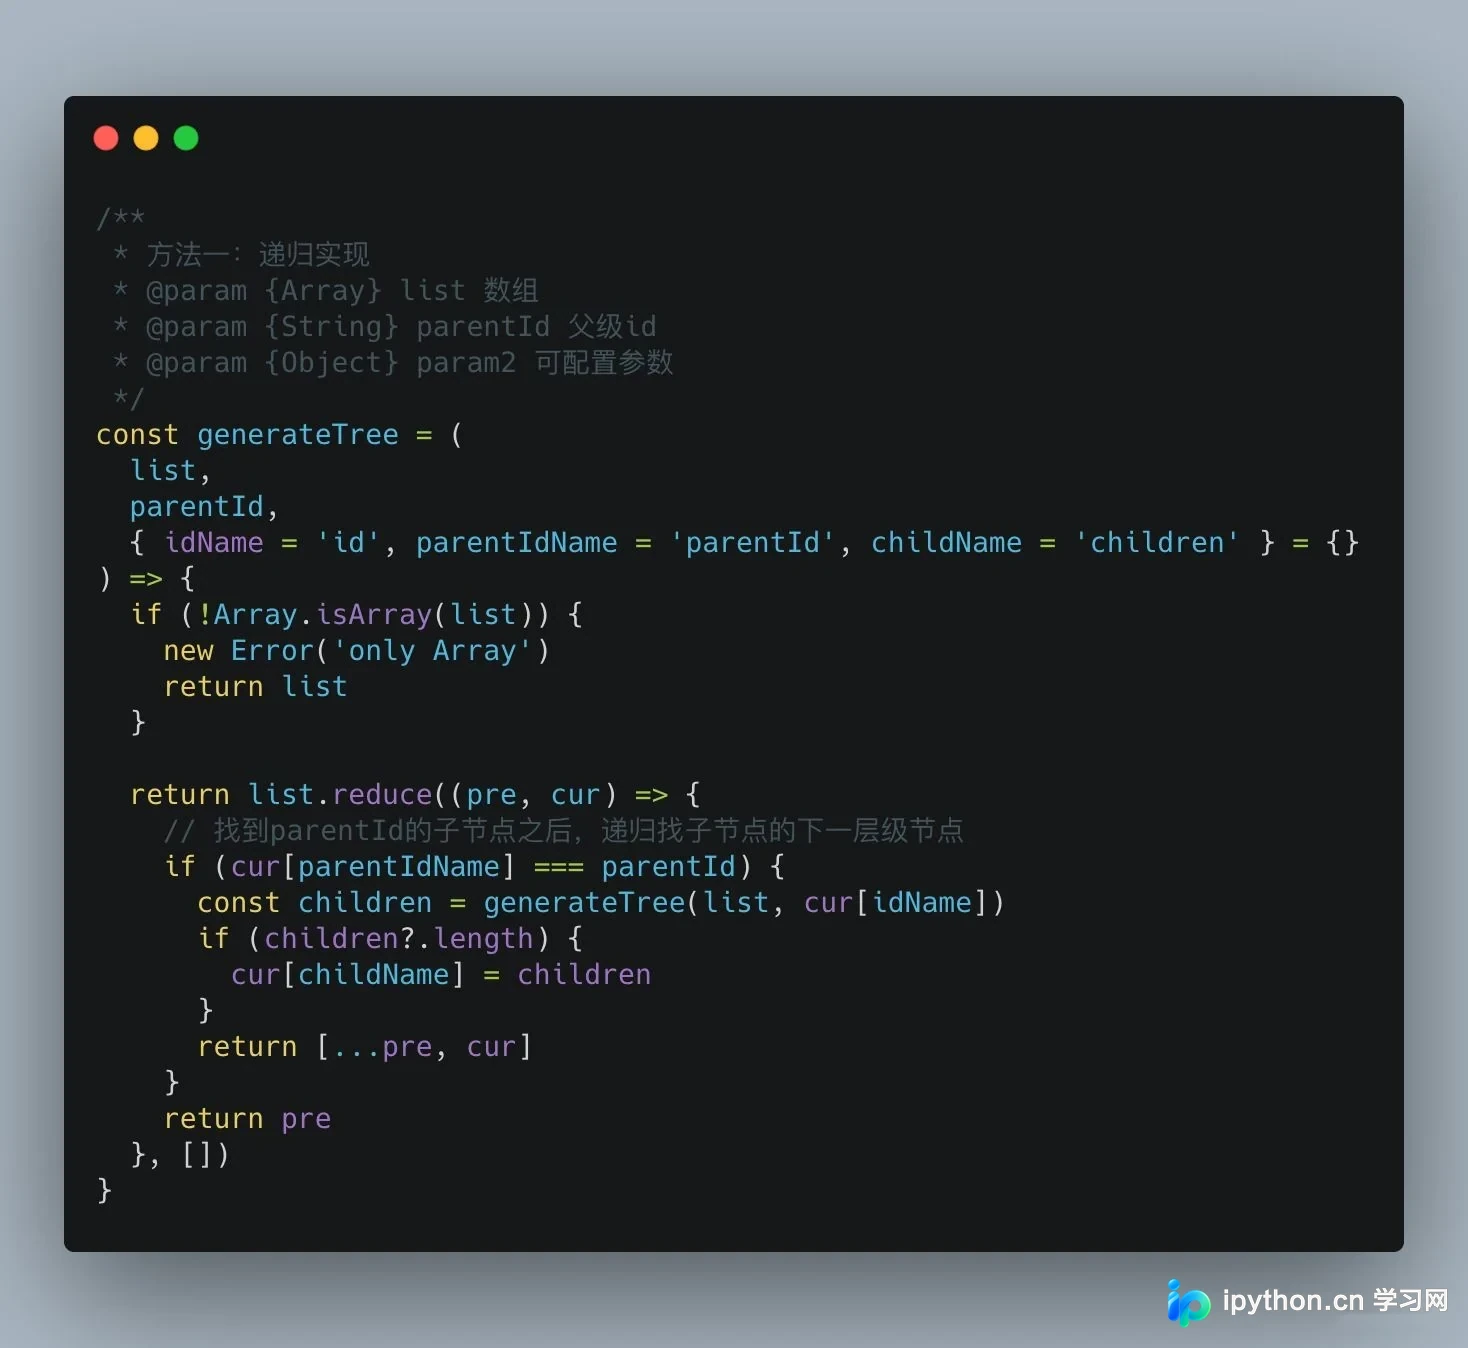
经测试,处理 1w+ 条数据时,递归方案耗时约 18 秒,直接导致页面主线程阻塞和界面卡顿。这是因为该算法在寻找子节点时需要反复遍历整个数组,时间复杂度高达 $O(n^2)$(或视作 $O(n\log n)$ 级别),无法满足实时交互需求。
非递归高性能方案
为解决性能瓶颈,可采用“空间换时间”的非递归策略。核心思想是利用 JavaScript 对象存储引用特性,通过一次遍历建立节点映射关系。
第1步:建立节点映射表
创建一个空对象 nodeMap,用于存储所有节点及其对应的引用。键为节点 id,值为完整的节点对象。由于对象保存的是引用地址,后续修改将直接反映在原数据或新结构中。
第2步:单次遍历构建层级
遍历平铺数组 flatArr,执行以下操作:
- 存入地图:将当前节点存入
nodeMap[节点.id]。 - 连接父级:根据
parentId在nodeMap中找到父节点引用。 - 挂载子节点:若存在父节点,将当前节点引用追加到父节点的
children数组中。 - 识别根节点:若无父节点(即
parentId为空或不存在),将其作为根节点收集起来。
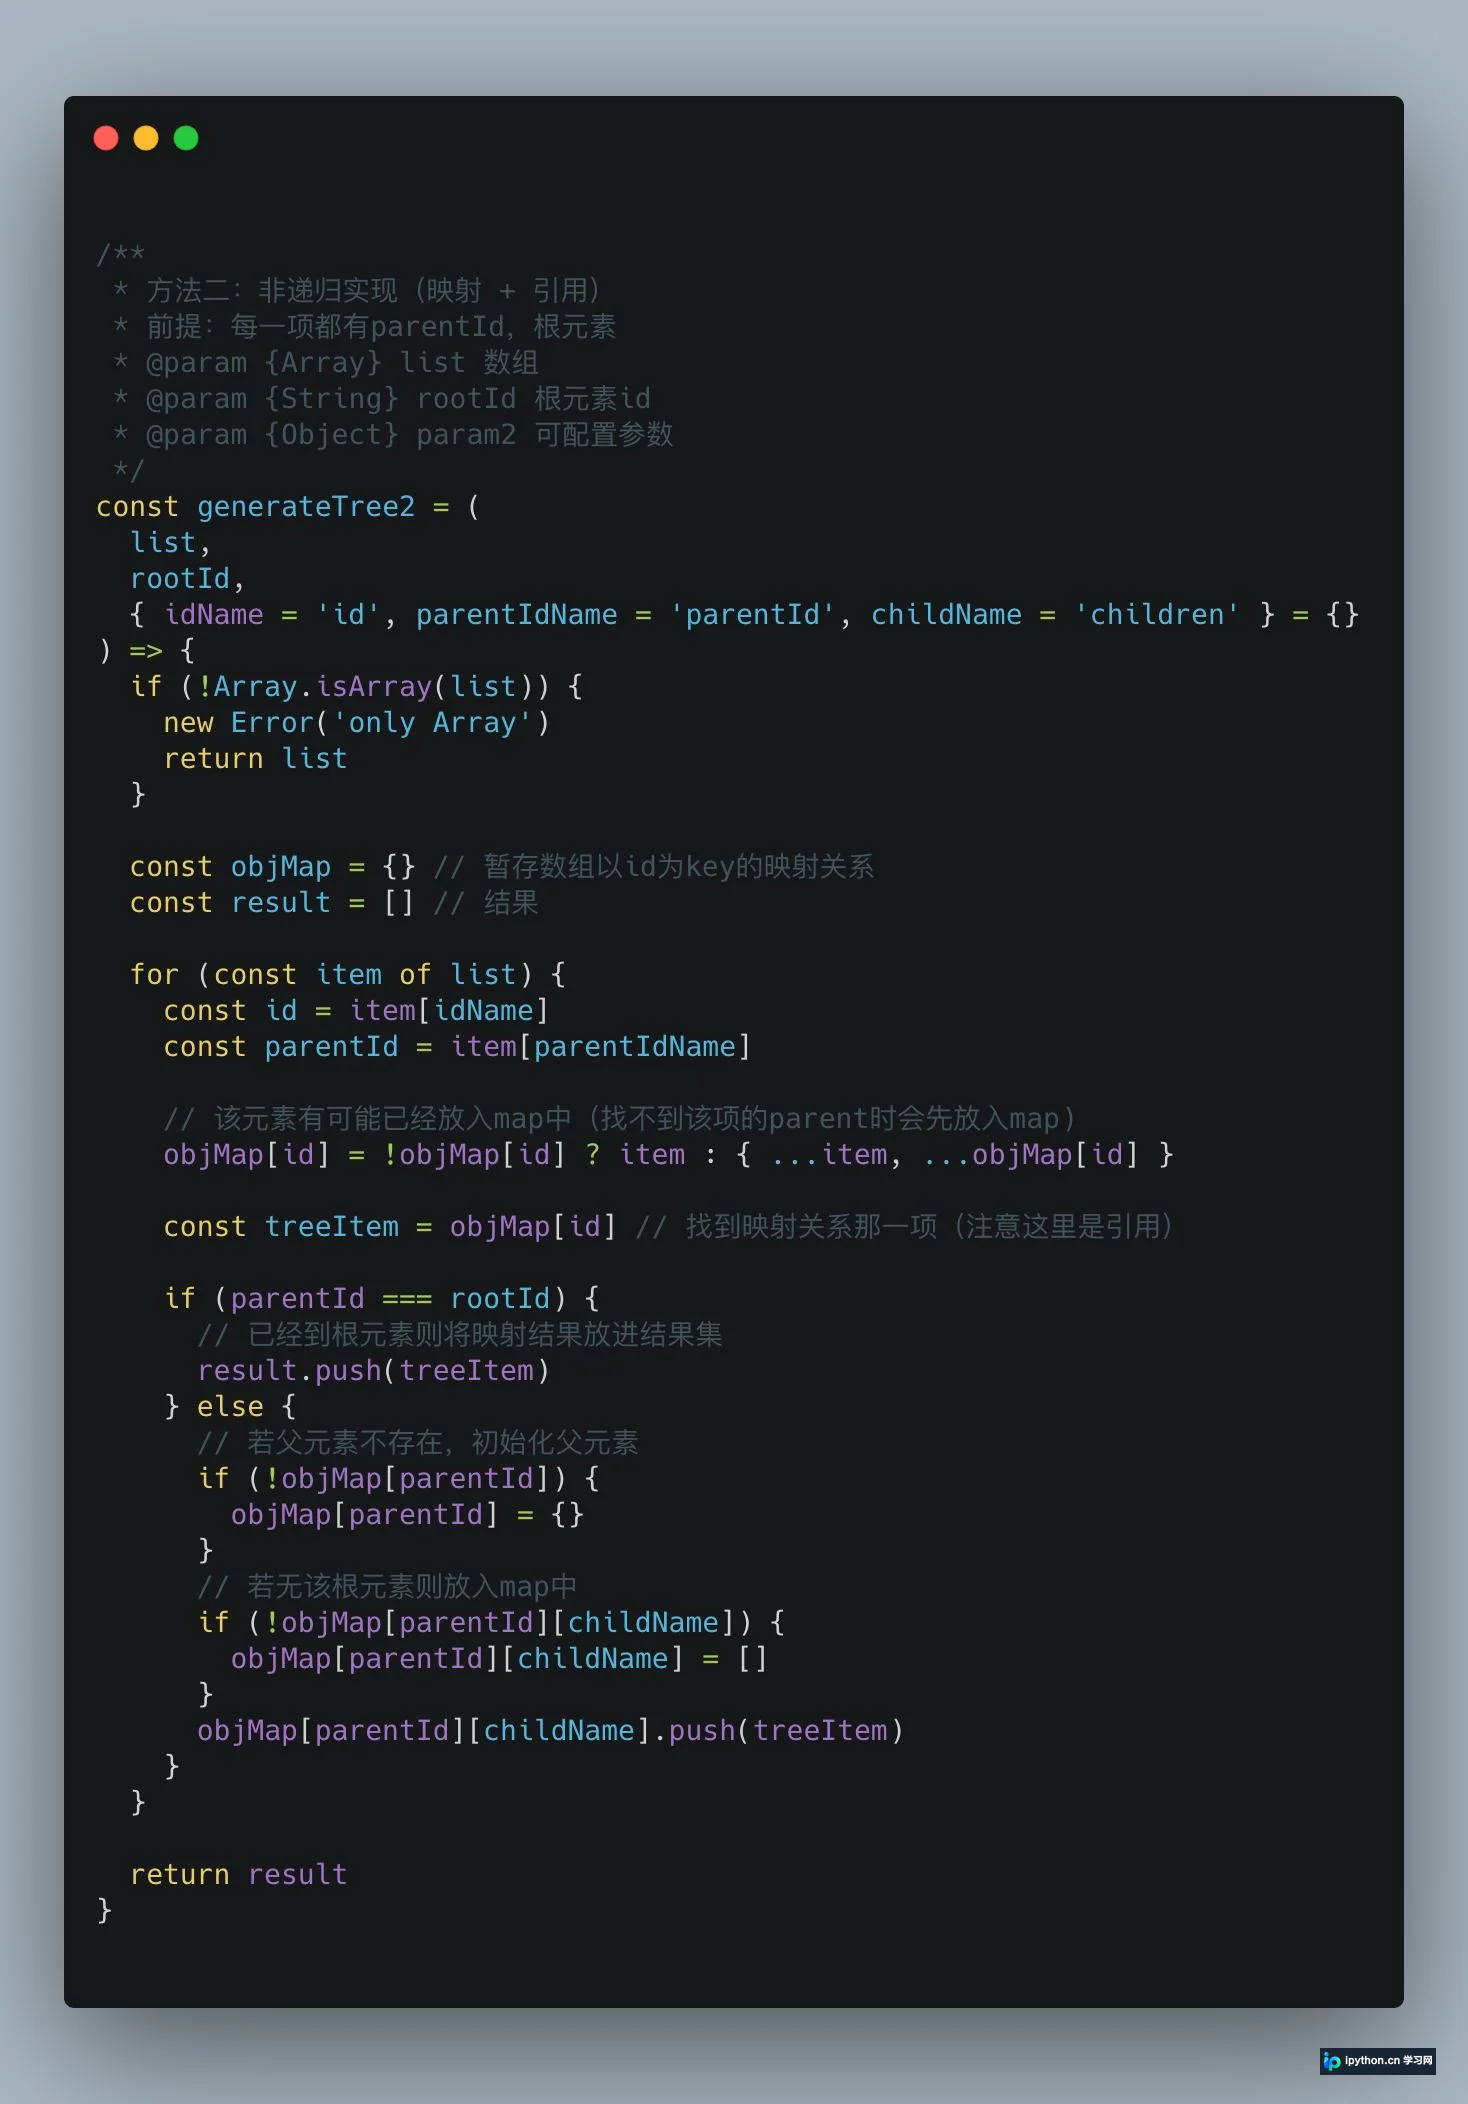
伪代码如下:
function flattenToTree(flatData) {
  const nodeMap = {};
  const roots = [];

  // 第一步:填充映射表并初步挂载
  for (const node of flatData) {
    nodeMap[node.id] = node;
    if (!node.parentId || !nodeMap[node.parentId]) {
      // 如果没有父节点ID或父节点尚未处理,暂时归为根(需确保顺序或二次处理)
      // 更稳健的做法是先建图,再遍历赋值,如下所示:
    }
  }

  // 更标准的单遍/双遍结合优化写法:
  // 1. 将所有节点放入 map
  flatData.forEach(node => nodeMap[node.id] = node);

  // 2. 遍历构建父子关系
  flatData.forEach(node => {
    if (node.parentId && nodeMap[node.parentId]) {
      nodeMap[node.parentId].children = nodeMap[node.parentId].children || [];
      nodeMap[node.parentId].children.push(node);
    } else {
      roots.push(node);
    }
  });

  return roots;
}
性能对比与总结
通过引入映射表,非递归方案只需遍历数组两次(或一次完成建图与关联,取决于具体实现细节,关键在于避免了内层循环),时间复杂度优化至 $O(n)$。实测显示,万级数据转换耗时仅需约 60ms,相比递归方案的 18s 有数量级的提升。
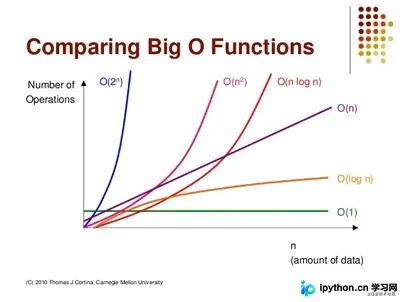
综上所述:
- 递归方式:代码简洁,适用于小规模数据(如 < 1000 项)。时间复杂度较高,数据量大时会导致严重的性能问题。
- 非递归方式:利用对象引用特性,通过哈希映射消除重复查找。时间复杂度为 $O(n)$,是处理后台万级甚至十万级平铺数据的最佳实践。
当面对复杂的前端数据展示需求时,选择合适的算法数据结构至关重要。在非递归模式下,通过简单的映射表即可实现高效转换,值得在各类项目中推广使用。
以上就是 JavaScript 平铺数组转树形结构的高性能实现详细内容,更多关于 JavaScript 数据转换优化的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















