


Python多线程详解:从基础概念到GIL限制与线程池应用

本文深入解析Python多线程机制,涵盖Thread类创建、参数配置及常用方法。重点剖析GIL锁对CPU密集型任务的限制,阐明多线程在IO密集型场景下的优势,并介绍利用multiprocessing.dummy实现线程池的最佳实践,帮助开发者高效提升程序运行效率。
线程
线程(Thread),有时也被称作轻量级进程(Lightweight Process,LWP),它是操作系统进行独立调度和分派的基本单位,从本质上看,线程就是一系列指令的集合。
一个标准线程由线程ID、当前指令指针(PC)、寄存器集合以及堆栈构成。作为进程中的一个实体,线程本身不拥有系统资源,仅持有运行过程中必不可少的少量资源(如程序计数器、寄存器和栈),但它能够与属于同一进程的其他线程共享进程所拥有的全部资源。线程无法独立执行,必须依附于进程存在。
多线程
多线程技术通过同时执行多个线程来完成任务,实现了任务的并行处理,从而有效提高了程序的运行效率。
假设在单个线程中执行多个任务(例如发送网络请求),若前面的任务耗时较长,后续任务必须等待前序任务完成后才能执行,这将严重影响整体效率。此时,采用多线程执行这些任务,使它们能够同时进行,将显著提升执行效率。
Python多线程
Python提供了threading模块来实现多线程操作,该模块建立在较低级的_thread模块基础之上,提供了更为易用的高级多线程API。
创建线程
可以通过threading模块中的Thread类来创建线程对象。
Thread语法结构:
threading.Thread(group, target, name, daemon)
group:默认为None(该参数是为了以后实现ThreadGroup类而保留的)target:在run方法中调用的可调用对象,即线程要执行的任务name:线程名称,可以不设定,默认为"Thread-N"形式的名称args:给target指定的函数传递的参数,以元组的方式传递kwargs:给target指定的函数传递命名参数daemon:默认为None,将显式地设置该线程是否为守护模式。如果是None,线程将继承当前线程的守护模式属性
Thread常用方法
start():启动线程,并调用该线程中的run()方法run():线程启动时运行的方法,正是它去调用target指定的函数join(timeout=None):让当前调用者线程(一般为主线程)等待,直到该线程结束,timeout是可选的超时时间is_alive():返回当前线程是否存活
import threading
import time
def work(i):
    print("子线程'{}'work正在运行......".format(threading.current_thread().name))
    time.sleep(i)
    print("子线程'{}'运行结束......".format(threading.current_thread().name))
if __name__ == '__main__':
    print("主线程{}启动".format(threading.current_thread().name))
    # 获取线程的名称
    threads = []
    for i in range(5):
        t = threading.Thread(target=work, args=(i,))
    # 启动线程
        threads.append(t)
        t.start()
    for t in threads:
        t.join()
    print("主线程结束")
执行结果为:
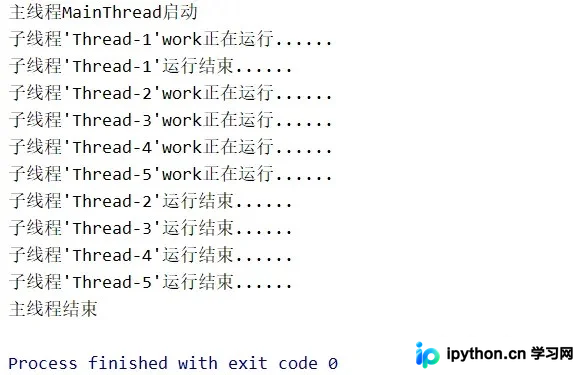
上述代码中使用t.join()的功能就是让主线程等待所有子线程结束后才结束,如果想设置守护线程(主线程结束,子线程也随之结束,无论任务执行完成与否)的话,可以使用t.daemon = True。
GIL锁
GIL的全称是Global Interpreter Lock(全局解释器锁),这个锁最初的设计是为了保证同一份数据不能被多个线程同时修改,每个线程在执行任务的时候都需要先获取GIL,保证同一时刻只有一个线程可以执行,即同一时刻只有一个线程在解释器中运行,因此Python中的多线程是假的多线程,不是真正意义上的多线程。 如果程序中有多个线程执行任务,那么多个线程会被解释器轮流执行,只不过是切换的很快、很频繁,给人一种多线程“同时”在执行的错觉。
线程池
在之前的文章说过,进程有进程池的机制,同样,线程也有线程池。线程池可以在程序启动时就创建自定义数量的空闲的线程,程序只要将一个任务提交给线程池,线程池就会启动一个空闲的线程来执行它。当该任务执行结束后,该线程并不会死亡,而是再次返回到线程池中变成空闲状态,等待下一个任务的执行。
multiprocessing.dummy里面也有一个Pool对象,它其实就是线程的封装,使用起来和multiprocessing的Pool非常类似。它们api都是通用的,简单地说,multiprocessing.dummy是multiprocessing进程池模块复制的一个线程池模块,强调一下,这里线程池也是受到GIL限制的。
使用方式和multiprocessing.Pool一致,具体参考Python进程池。
from multiprocessing.dummy import Pool
import time
def work(i):
    print("work'{}'执行中......".format(i))
    time.sleep(2)
    print("work'{}'执行完毕......".format(i))
if __name__ == '__main__':
    # 创建线程池
    # Pool(5) 表示创建容量为5个线程的线程池
    pool = Pool(5)
    for i in range(10):
        pool.apply_async(work, (i, ))
    pool.close()
    pool.join()
总结
由于Python中的多线程受GIL锁的限制,导致不能利用机器多核的特性,只能利用单核,是假的多线程,但是也不是一无是处,对于IO密集型任务,多线程是能够有效提升运行效率的,这是因为单线程下有IO操作时,会进行IO等待,这样会浪费等待的这段时间,而开启多线程能在线程A等待时,自动切换到线程B,可以减少不必要的时间浪费,从而能提升程序运行效率,但是也不是最好的选择,对于处理IO密集型任务,在Python还有更好的选择协程,在后续文章会介绍。
本篇文章就到这里了,希望能够给你带来帮助,也希望您能够多多关注本站的更多内容!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















