



很多人学 C# 正则时,最先踩坑的不是语法本身,而是看起来很像、实际行为却差很多的几个符号:比如 .* 为什么会“吃太多”,为什么表单校验少了 ^ 和 $ 就会误判,以及 ^ 放在字符类里为什么又变成了另一层意思。本文按“重复次数、匹配范围、位置判断”这三条线重组内容,并保留对应的 C# 示例,方便你直接对照业务里的校验、提取和多行文本匹配场景来理解。
量词先看懂:它控制的是前一项重复多少次
量词出现在一个“单元”后面,用来声明这个单元可以重复几次。这里的“单元”可以是普通字符、字符类,也可以是一个分组。
- 一个普通字符:
a - 一个字符类:
d、[A-Z] - 一个分组:
(ab)
常见量词一览
?:0 或 1 次*:0 次或多次+:1 次或多次{n}:恰好 n 次{n,}:至少 n 次{n,m}:n 到 m 次之间
例如下面这个模式,要求整串内容必须是 3 到 5 位:
using System.Text.RegularExpressions;

string pattern = @"^d{3,5}$";
bool ok = Regex.IsMatch("1234", pattern); // True
为什么量词经常“写对了却匹配错了”
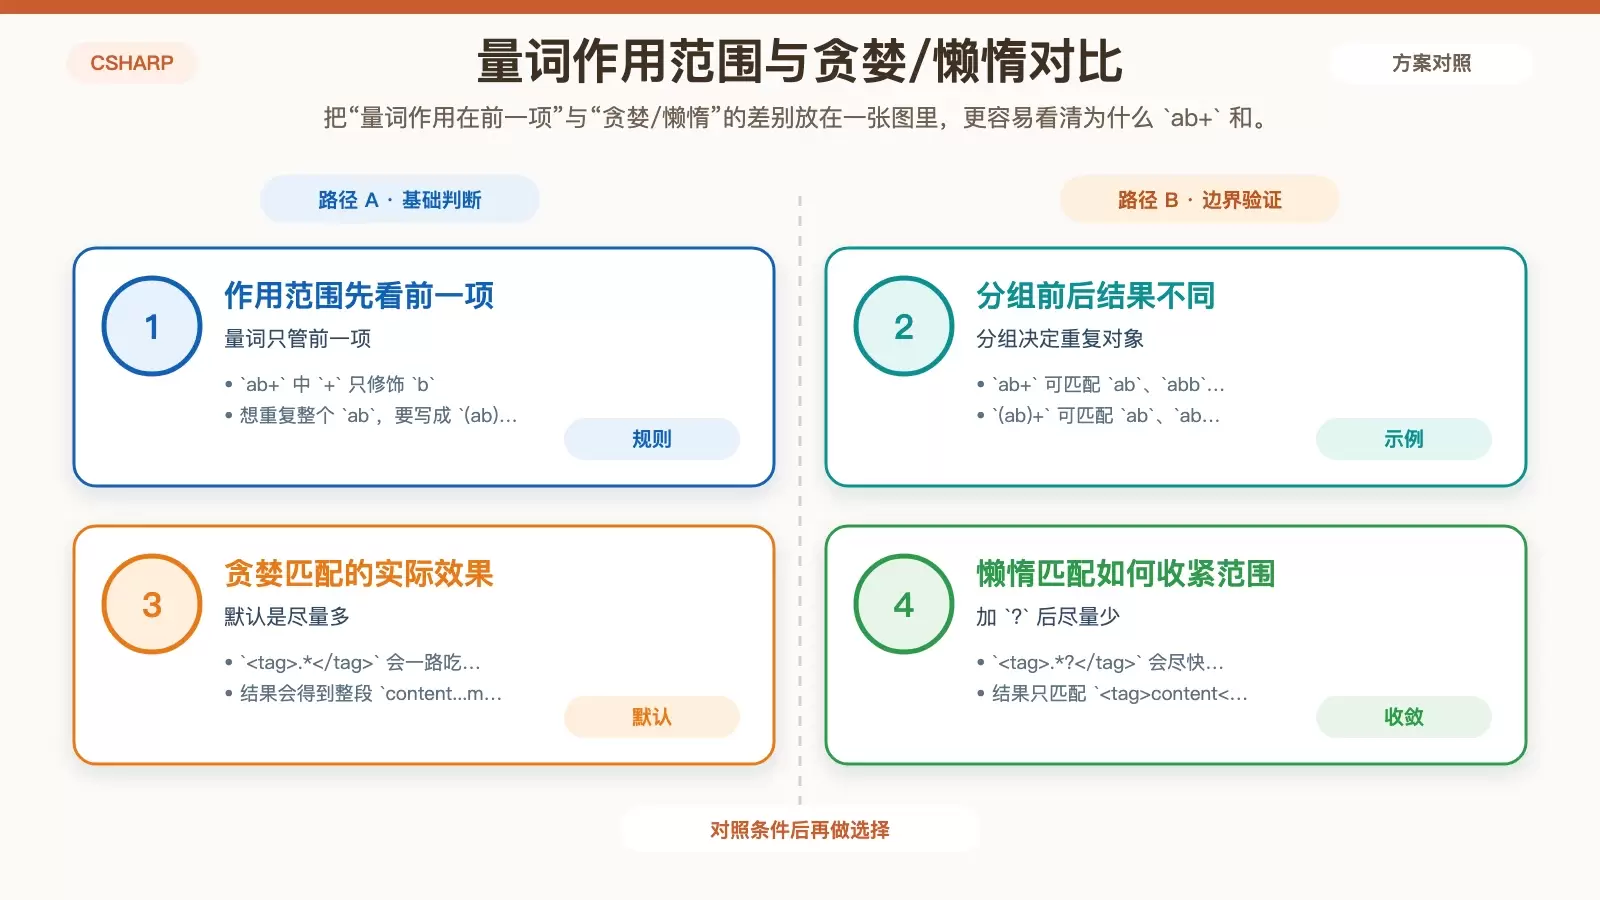
关键规则只有一条:量词只作用在前一项上。
这也是初学者最常见的误区。比如 ab+ 中,+ 只修饰 b,不会让整个 ab 重复。
- 模式:
ab+
匹配:"ab"、"abb"、"abbbb"... - 模式:
(ab)+
匹配:"ab"、"abab"、"ababab"...
所以,只要你想对一整段内容重复匹配,就应该先分组,再加量词。
为什么 .* 总是匹配过头:贪婪与懒惰的区别
量词默认是贪婪的,也就是在不影响匹配成功的前提下,尽可能多地吞掉字符。实际开发里,.* 造成的“超范围匹配”问题非常常见。
贪婪匹配:.*
string input = "<tag>content</tag><tag>more</tag>";
string pattern = @"<tag>.*</tag>";

Match m = Regex.Match(input, pattern);
Console.WriteLine(m.Value);
匹配结果:
<tag>content</tag><tag>more</tag>
原因在于 .* 会一直向后吃,直到最后一个仍然能让整个表达式成立的 </tag>。
懒惰匹配:.*?
如果在量词后面再加一个 ?,就会从默认贪婪改成懒惰,也就是在满足匹配成功的前提下,尽可能少地匹配。
*?:尽可能少的 0 次或多次+?:尽可能少的 1 次或多次??:尽可能少的 0 或 1 次{n,m}?:在 n~m 之间,尽量少
把上面的例子改成:
string pattern = @"<tag>.*?</tag>";

Match m = Regex.Match(input, pattern);
Console.WriteLine(m.Value);
匹配结果:
<tag>content</tag>
这也是提取 HTML 片段、日志片段、括号内容时最常见的一组对照:想抓最短片段,就优先检查自己是不是该用懒惰量词。
几个常见格式,如何用量词写出来
理解量词后,可以先从“格式校验”这类最直观的任务入手。下面几个模式都很常见,但要注意,它们表达的是格式,不一定涵盖完整语义合法性。
简单日期:yyyy-MM-dd
^d{4}-d{2}-d{2}$
- 这里只校验形式,不判断日期是否真实存在
用户名:字母开头,后面 3~15 位字母数字下划线
^[A-Za-z]w{3,15}$
[A-Za-z]:首字符必须是字母w{3,15}:后面 3~15 个字母数字下划线- 总长度:4~16
C# 示例:
string pattern = @"^[A-Za-z]w{3,15}$";
bool ok = Regex.IsMatch("User_001", pattern);
整数和小数
一个简单版本的“非负整数或小数”可以写成:
^d+(.d+)?$
d+:至少一位数字(.d+)?:可选的小数部分,即.加至少一位数字
能匹配:0、123、3.14、0.5
不能匹配:.、.5、3.。如果业务允许这些写法,再按需求放宽。
锚点为什么重要:它决定你匹配的是整串还是子串
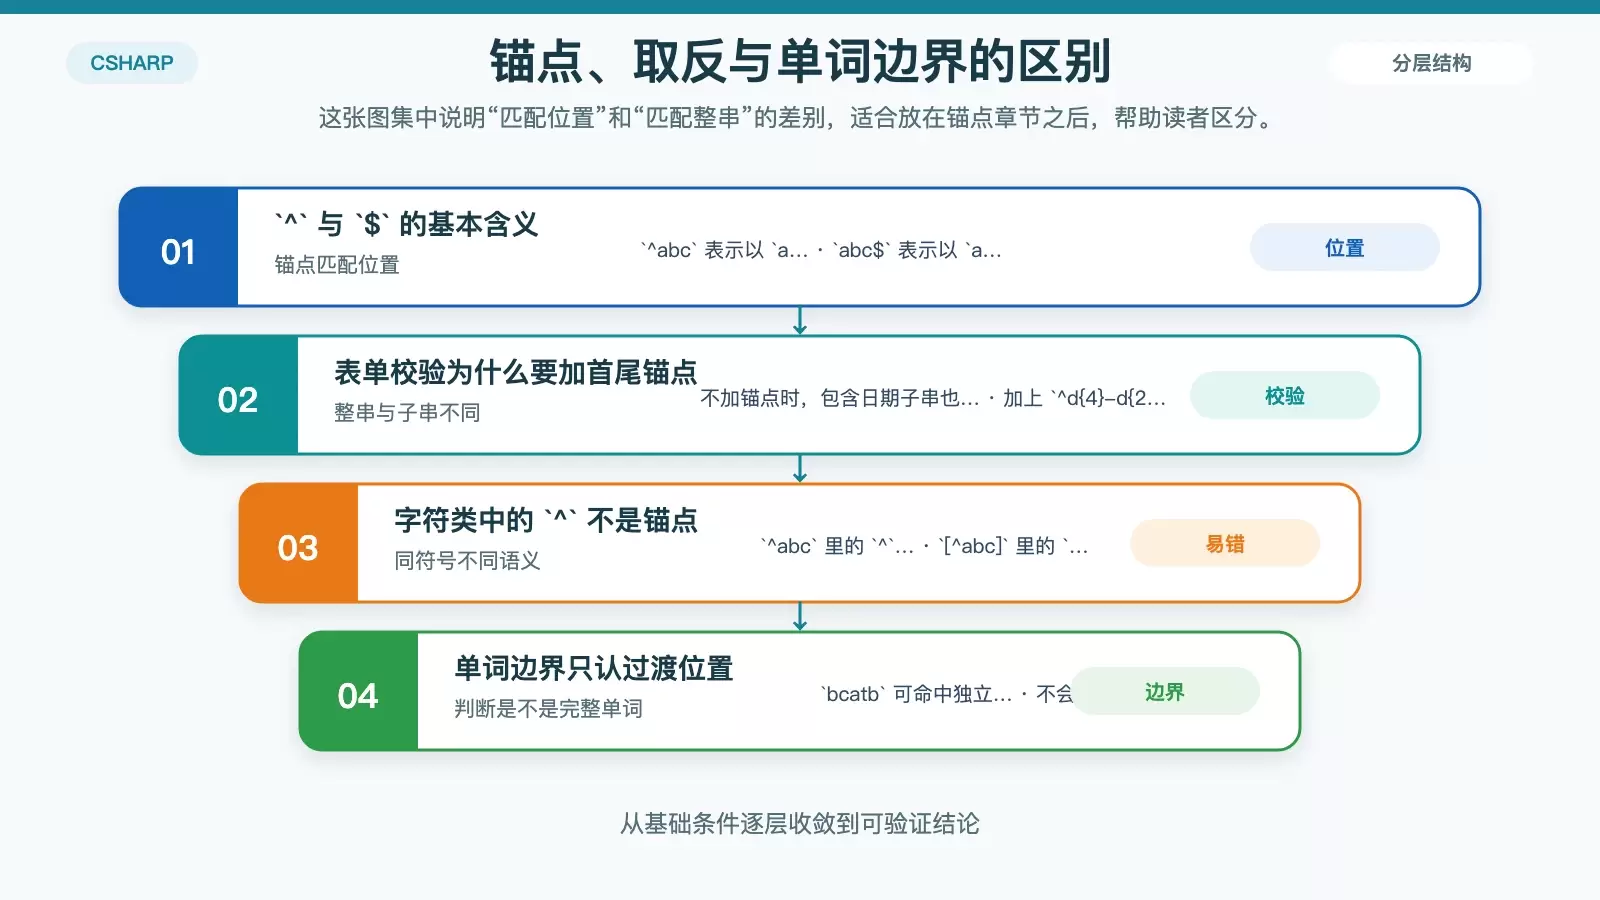
锚点(Anchor)本身不消耗字符,它匹配的是“位置”。在 C# 里做表单校验时,很多误判都不是量词写错,而是忘了用锚点把匹配范围收紧到整串。
^ 和 $ 分别表示什么
默认情况下:
^匹配字符串开头$匹配字符串结尾
例如:
^abc      // 匹配以 "abc" 开头的字符串
abc$      // 匹配以 "abc" 结尾的字符串
^abc$     // 字符串只能是 "abc"
Regex.IsMatch("abc123", @"^abc");   // True
Regex.IsMatch("123abc", @"abc$");   // True
Regex.IsMatch("xabcx", @"^abc$");   // False
为什么表单校验通常一定要加 ^ 和 $
如果没有锚点,Regex.IsMatch 判断的是“是否包含一个能匹配的片段”;加上锚点后,才是在验证整串是否符合要求。
// 不严谨
Regex.IsMatch("abc2025-12-18xyz", @"d{4}-d{2}-d{2}");
// True,只要“包含”符合格式的子串就通过

// 严谨
Regex.IsMatch("abc2025-12-18xyz", @"^d{4}-d{2}-d{2}$");
// False,整个字符串不是完整日期
这也是“看起来测通了,上线后却放过脏数据”的高频原因之一。
同样是 ^,放在字符类里意思完全不同
^abc        // 锚点:开头
[^abc]      // 取反:匹配任何不是a、b、c的字符
^在[]外:表示开头锚点^在[]内且位于首位:表示取反
这个区别必须单独记住,因为它不是“细节不同”,而是语义已经完全变了。
想匹配完整单词时,用单词边界 b
b 表示单词边界(word boundary),用于匹配从一个 w 字符过渡到非 w 字符的位置。它解决的问题不是“有没有这段字符”,而是“这段字符是不是一个完整单词”。
例如:
string text = "cat scat category";
string pattern = @"bcatb";

MatchCollection matches = Regex.Matches(text, pattern);
foreach (Match m in matches)
{
    Console.WriteLine(m.Value);
}
输出:
cat
可以这样理解:
"cat"左边是开头,右边是空格,前后都是边界,所以可以匹配"scat"里的cat左边是s,仍属于w字符,不满足边界条件"category"里的cat右边是e,同样不是边界
多行模式和单行模式,分别会改掉谁的行为
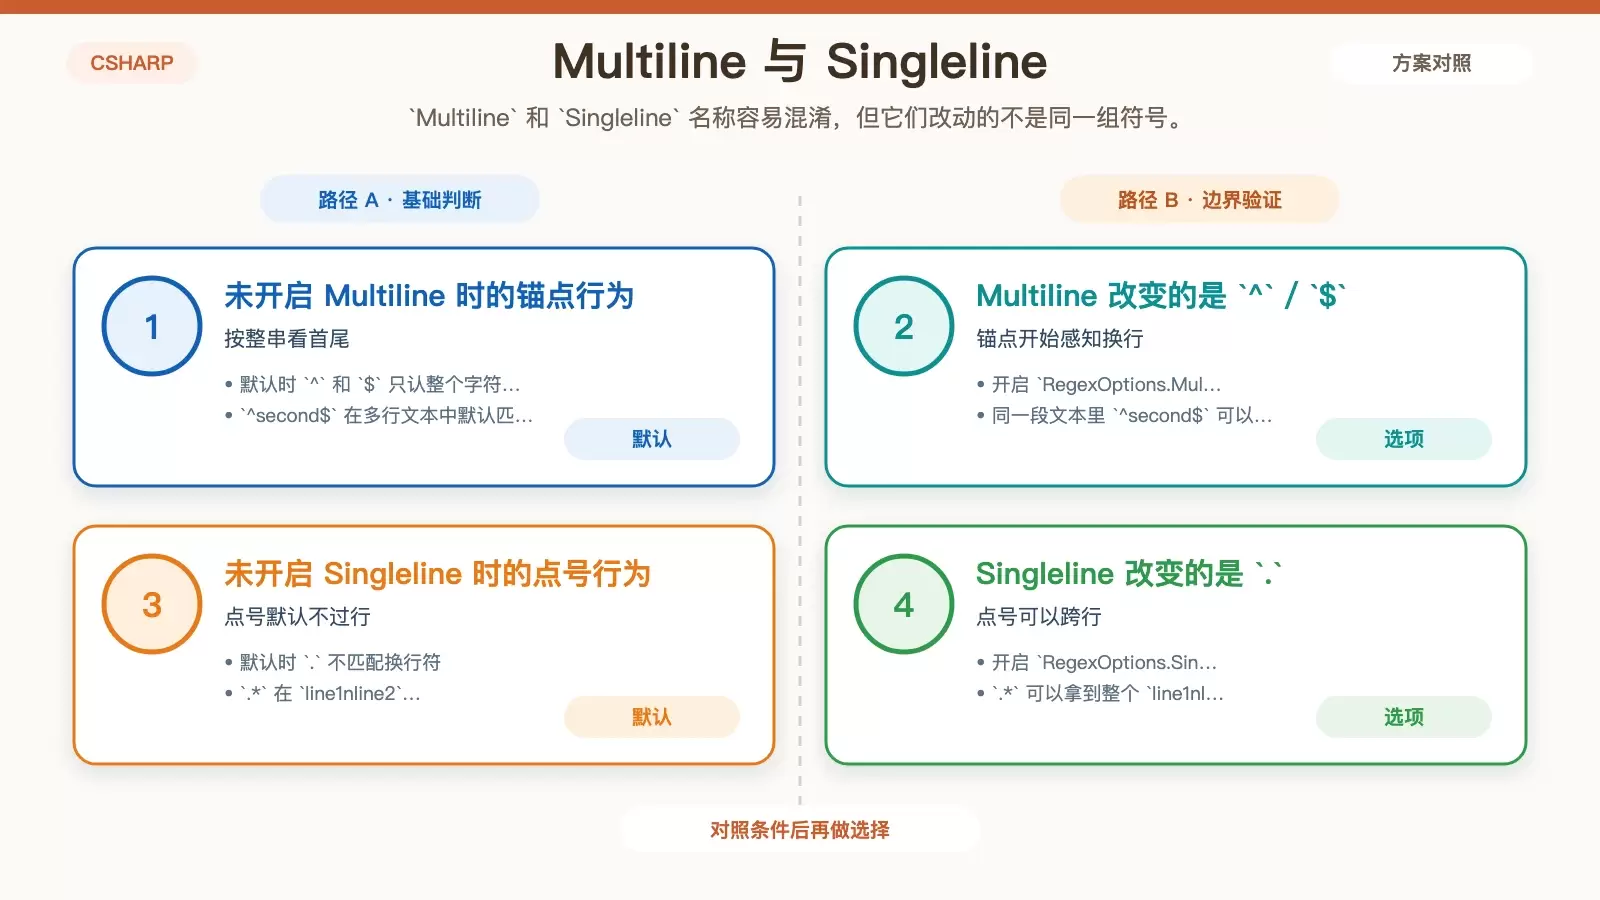
在 C# 中,可以通过 RegexOptions 改变 ^、$ 和 . 的默认行为。这里最容易混淆的,是 Multiline 和 Singleline 这两个名字看起来相反,但影响点并不在同一处。
RegexOptions.Multiline:让 ^ / $ 按“每一行”工作
默认情况下,^ 和 $ 只认整个字符串的起点和终点。
string text = "firstnsecondnthird";
string pattern = @"^second$";

Console.WriteLine(Regex.IsMatch(text, pattern)); // False
原因是默认模式下,它们不会感知中间的换行。
开启多行模式后:
bool ok = Regex.IsMatch(
    text,
    pattern,
    RegexOptions.Multiline
);
Console.WriteLine(ok); // True
此时 ^ / $ 会匹配每一行的开头和结尾。
RegexOptions.Singleline:让 . 也能匹配换行
默认情况下,点号 . 不匹配换行符。
string text = "line1nline2";
string pattern = @".*";

Match m1 = Regex.Match(text, pattern);
Console.WriteLine(m1.Value);    // "line1"
开启 Singleline 后:
Match m2 = Regex.Match(text, pattern, RegexOptions.Singleline);
Console.WriteLine(m2.Value);    // "line1nline2"
此时 . 会把换行也算进“任意字符”里。
一眼记住这两个选项
Multiline:影响^/$,让它们按行匹配Singleline:影响.,让点号可以跨越换行
它们也可以组合使用:
var regex = new Regex(
    pattern,
    RegexOptions.Multiline | RegexOptions.Singleline
);
结语:先判断目标,再决定用量词、锚点还是边界
回头看,正则里最常见的几类错误,其实都可以归到三个判断上:你是在控制“重复次数”,还是在限制“整串范围”,还是在判断“位置边界”。把这三件事分开想,.*、^、$、b 以及 RegexOptions 的用法就不会再混成一团。















