


C语言数据存储原理:整型、大小端与浮点数存储机制解析

C语言的数据存储涉及基本类型划分、整数补码表示、字节序(大小端)以及浮点数的IEEE 754标准。理解这些底层机制是掌握内存管理、指针操作及解决跨平台兼容性问题的基础。
C语言数据类型分类
C语言提供了丰富的数据类型以满足不同精度和范围的需求。根据数值的性质,主要分为整型和浮点型两大类:
整型类型
整型用于表示没有小数部分的数值。根据是否有符号(正负)以及占用字节数的不同,可分为以下类别:
- 字符型:
char、unsigned char、signed char - 短整型:
short、unsigned short [int]、signed short [int] - 整型:
int、unsigned int、signed int - 长整型:
long、unsigned long [int]、signed long [int] - 更长的整型:
long long
注:在代码声明中,int 关键字通常可以省略,例如 unsigned int a; 可简写为 unsigned a;。
浮点类型
浮点型用于表示带有小数部分的实数。C语言主要支持以下三种精度:
float:单精度浮点数double:双精度浮点数long double:扩展精度浮点数
整数在内存中的存储
理解整数存储的核心在于区分其表现形式与内部编码。计算机内存中存储整数时,使用的是补码,而非人们日常使用的原码或反码。
原码、反码与补码
这三种编码方式均包含符号位(最高位,0为正,1为负)和数值位:
- 原码:直接将数值转换为二进制,符号位置1或0。例如 +6 的原码为 00000110,-6 的原码为 10000110。
- 反码:正数的反码与原码相同;负数的反码是符号位不变,其余各位按位取反。
- 补码:正数的补码与原码相同;负数的补码是其反码加1。
为什么使用补码? CPU仅内置加法器,使用补码可以将减法运算转化为加法运算(例如 A - B 变为 A + (-B) 的补码),从而简化硬件设计并统一零的表示。
大小端存储模式
当多字节数据(如 int、float)存入内存时,字节的存放顺序取决于系统架构的大小端模式:
- 大端模式(Big-endian):数据的高位字节存放在内存的低地址处,低位字节存放在高地址处。符合人类阅读习惯。
- 小端模式(Little-endian):数据的低位字节存放在内存的低地址处,高位字节存放在高地址处。现代x86/x64架构主流采用此模式。
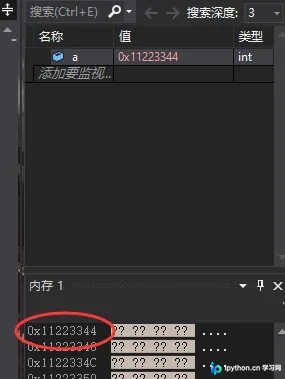
示例分析:假设变量 int a = 0x11223344;
- 在大端模式下,内存低地址到高地址依次存储:
11223344 - 在小端模式下,内存低地址到高地址依次存储:
44332211
浮点数的存储机制
浮点数在内存中的存储远比整数复杂,遵循 IEEE 754 国际标准。直接进行强制类型转换常会引发意想不到的结果,例如:
int n = 9;
float *pFloat = (float *)&n;
*pFloat = 9.0;
printf("num的值为:%d\n",n);  // 输出非9
printf("*pFloat的值为:%f\n",*pFloat); // 输出9.000000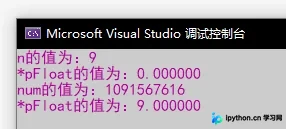
上述代码中,整数 n=9 被当作浮点数解释时,其二进制位序列被解读为极小的近似值,因此输出接近0而非9。理解这一现象需深入探究 IEEE 754 的存储格式。
IEEE 754 浮点数存储规则
任意二进制浮点数 V 可表示为:
V = (-1)^S × M × 2^E
- S (Sign):符号位,0表示正,1表示负。
- M (Mantissa):有效数字,满足
1 <= M < 2。 - E (Exponent):指数位,决定小数点的移动位数。
具体格式定义
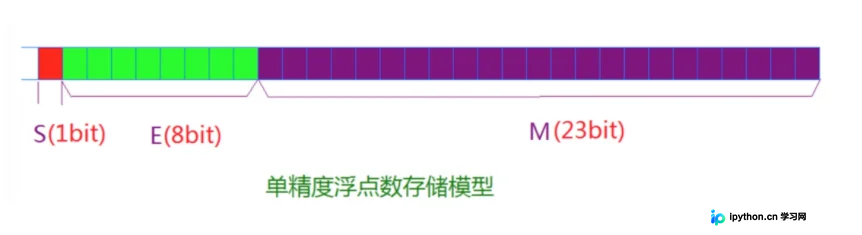
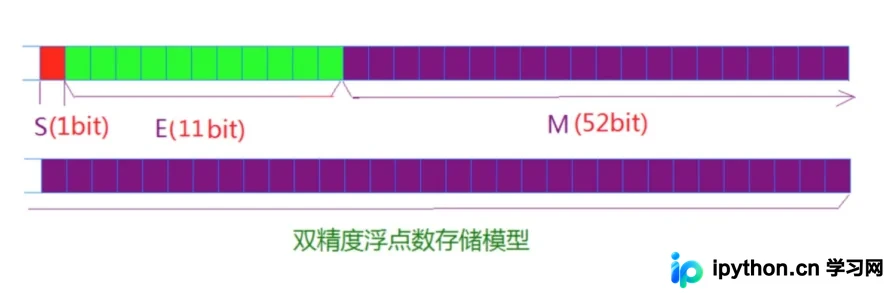
对于32位 float 和64位 double,各字段位数分配如下:
关键细节处理
1. 有效数字 M 的规范化
由于 1 <= M < 2,M 的二进制形式总是 1.xxxxxx...。
优化策略:保存时默认隐藏开头的 1,只存储小数部分 xxxxxx...。读取时再补回 1。
例如:将 1.01 存为 01。这使得32位浮点数能拥有相当于24位的精度。
2. 指数 E 的偏移量
E 是一个无符号整数,但实际科学计数法中指数可为负数。为此,IEEE 754 规定存入内存时需加上一个偏移量:
- 32位 float:偏移量为
127。真实指数为 E - 127。 - 64位 double:偏移量为
1023。真实指数为 E - 1023。
例如:2^10 的真实指数为10,存入内存时为 10 + 127 = 137。
特殊情况下的指数 E 处理
E 不全为0且不全部为1
这是标准的浮点数情况。真实指数通过减去偏移量获得,且有效数字 M 恢复前导 1。
实例:十进制 0.5
1. 转为二进制:0.1
2. 规格化:1.0 × 2^(-1)。此时 S=0, M=1.0, E=-1。
3. 计算存储值:
- S = 0
- E = -1 + 127 = 126 (01111110)
- M = .000...0 (23位)
最终二进制:0 01111110 000...0
E 全为0
此时真实指数定为 1 - 127 = -126(float)。有效数字 M 不再加前导 1,而是还原为 0.xxxxxx。
目的:表示 ±0 以及非常接近于0的非规约数(Subnormal numbers)。
E 全为1
- 若 M 全为0:表示
±Infinity(无穷大,由符号位 S 决定正负)。 - 若 M 不全为0:表示 NaN(Not a Number,非数值)。
总结
C语言的数据存储不仅关乎类型的选择,更涉及底层的二进制编码规则。整数以补码形式存储解决了运算问题;大小端模式体现了硬件架构的差异;而浮点数通过 IEEE 754 标准在有限的32/64位空间中实现了高精度的范围覆盖。掌握这些原理,能有效避免类型混淆带来的Bug,并更深入地理解程序的行为。
以上就是C语言数据存储原理的详细内容,更多关于C语言底层机制的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















