


Java BufferedOutputStream:原理、用法与数据安全性解析

BufferedOutputStream是Java IO操作中用于提升文件写入性能的常用类,它基于装饰者模式封装了底层输出流。本文将深入解析其核心方法的使用场景、默认8KB缓冲区的运作机制,并通过实际对比实验展示其在速度与数据安全性方面的特点,帮助开发者避免缓冲区溢出导致的数据丢失问题。
BufferedOutputStream 简介与构造方式
BufferedOutputStream(字节缓冲输出流)主要作用是为其他输出流添加缓冲功能。由于频繁的磁盘I/O操作效率较低,引入缓冲区可以将多次小写合并为一次大块写入,从而显著减少系统调用的次数,提高程序运行效率。
在实际开发中,通常采用以下两种方式创建 BufferedOutputStream:
- 使用默认缓冲区大小:不指定buffer大小时,系统会分配一个足够大的默认缓冲区。
public BufferedOutputStream(OutputStream out)- 自定义缓冲区大小:根据业务需求指定具体的缓冲区容量,单位是字节。
public BufferedOutputStream(OutputStream out, int size)注意:size参数必须大于0,否则将抛出 IllegalArgumentException 异常。
核心方法详解
BufferedOutputStream 继承自 FilterOutputStream,其核心操作均围绕数据的写入与刷新展开。
第1步:向缓冲区写入单个字节
该方法将指定的一个字节写入到缓冲的输出流中。数据首先存入内部数组,未满时不会立即写入磁盘。
public void write(int b) throws IOExceptionb:要写入的字节数据。
第2步:向缓冲区写入字节数组的一部分
这是更高效的批量写入方式,可以指定从数组的哪个位置开始,写入多少个字节。
public void write(byte[] b, int off, int len) throws IOExceptionb:包含待写入数据的目标字节数组。off:数据的起始偏移量(索引)。len:要写入的字节数量。
第3步:强制刷新缓冲区(关键)
当需要将缓冲区中的数据强制写出到底层输出流(如文件)时调用此方法。这能确保数据持久化到存储设备,防止进程异常中断导致数据丢失。
public void flush() throws IOException第4步:关闭输出流
关闭此流并释放相关系统资源。底层实现会自动先调用 flush() 确保所有缓冲数据被写出,然后再关闭底层的输出流。
public void close() throws IOException基础使用示例
以下是基于装饰者设计模式的典型用法,演示如何将文本转换为字节并写入文件:
public static void main(String[] args) throws Exception {
    // 创建带有缓冲功能的输出流,包装 FileOutputStream
    BufferedOutputStream bos = new BufferedOutputStream(new FileOutputStream("output.txt"));

    // 将字符串转为字节数组并写入缓冲区
    bos.write("Hello BufferedStream".getBytes());

    // 推荐显式调用flush或close以确保数据写入文件
    bos.flush();
    bos.close();
}
性能分析与数据安全深入解析
虽然 BufferedOutputStream 能显著提升速度,但其“缓存”特性也带来了数据一致性的挑战。我们通过对比实验来观察其行为。
实验设计
我们准备了三个场景进行并行测试,每次写入包含换行符的8字节数据,目标文件分别位于不同的路径下。场景包括使用纯 FileOutputStream 直接写入,以及使用 BufferedOutputStream 进行无限循环写入和有限次写入。
public class BufferFileDemo {
    public static void main(String[] args) {
        byte[] data = "TestData\n".getBytes();

        // 线程1: BufferedOutputStream 无限循环写入 (模拟高频操作)
        new Thread(() -> {
            try (BufferedOutputStream bos = new BufferedOutputStream(
                    new FileOutputStream("/var/file_test_data/out_buffer_while.txt"))) {
                while (true) {
                    Thread.sleep(100);
                    bos.write(data);
                }
            } catch (Exception e) { e.printStackTrace(); }
        }).start();

        // 线程2: BufferedOutputStream 写入固定次数 (1千万次)
        new Thread(() -> {
            try (BufferedOutputStream bos = new BufferedOutputStream(
                    new FileOutputStream("/var/file_test_data/out_buffer_for.txt"))) {
                for (int i = 0; i < 10000000; i++) {
                    bos.write(data);
                }
            } catch (Exception e) { e.printStackTrace(); }
        }).start();

        // 线程3: FileOutputStream 直接写入 (1千万次)
        new Thread(() -> {
            try (FileOutputStream fos = new FileOutputStream(
                    new File("/var/file_test_data/out_file_direct.txt"))) {
                for (int i = 0; i < 10000000; i++) {
                    fos.write(data);
                }
            } catch (Exception e) { e.printStackTrace(); }
        }).start();
    }
}
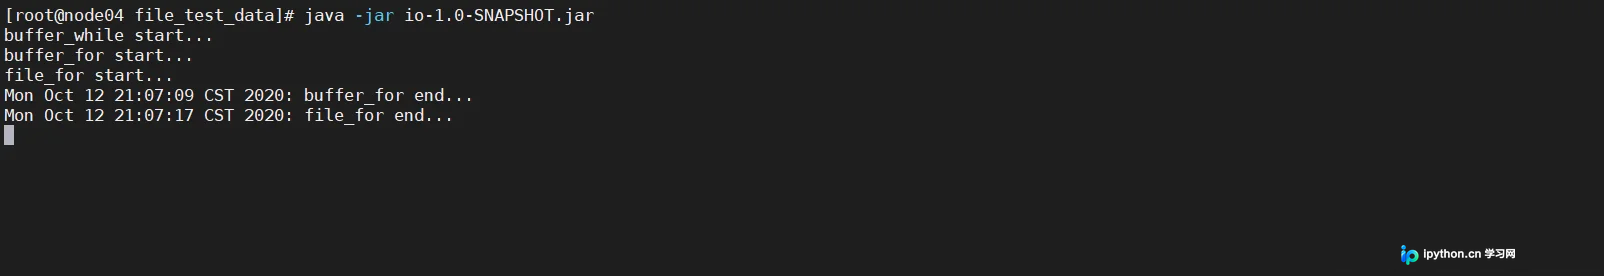
实验过程涉及多线程并发执行,具体运行情况如下:
结果分析
1. 写入速度优势:
实验显示,在相同写入量下,BufferedOutputStream 比直接使用 FileOutputStream 速度快数秒。这是因为 Buffered 减少了频繁的系统内核态切换,而 Direct Write 每次调用都会触发磁盘 I/O。
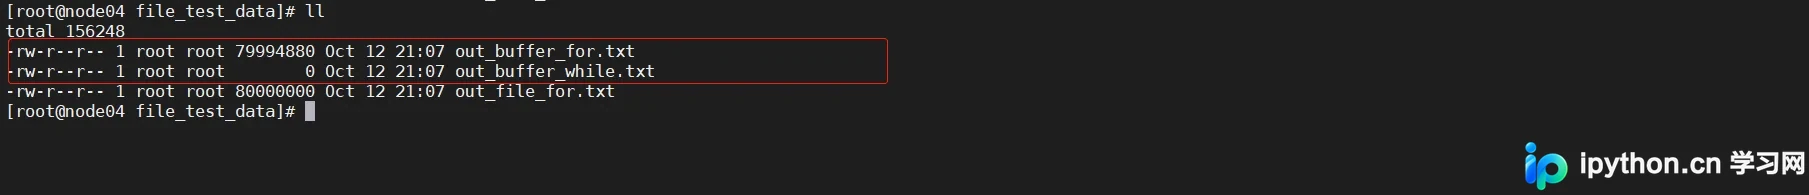
2. 数据完整性与丢失风险:
从测试结果可以看出明显的差异:
- 无限循环场景:在未主动调用 flush 的情况下强行停止进程,
out_buffer_while.txt可能完全为空或数据残缺。这是因为数据还停留在 JVM 堆内存的缓冲区中,尚未刷入磁盘。 - 有限次写入场景:如果在代码末尾遗漏了
flush()或依赖自动关闭机制失败,同样会出现“丢数据”现象,表现为文件大小不符合预期。
原因剖析
BufferedOutputStream 内部维护了一个大小为 8KB (8192字节) 的字节数组作为缓冲区。数据写入时,是先填充这个内存数组。只有满足以下任一条件时,数据才会真正调用底层流的 write 写入磁盘:
- 缓冲区已满 (count >= buf.length)。
- 显式调用了
flush()。 - 调用
close()时。

如何确保数据安全?
为了修复上述数据丢失问题,必须在适当时机将数据落盘。正确的做法是在大量数据写入完毕后,或者在业务逻辑的关键节点调用 flush()。
修正后的安全写入代码:
// 在循环结束后,手动刷盘
for (int i = 0; i < 10000000; i++) {
    bufferedOutputStream.write(bytes);
}
// 关键步骤:确保缓冲区数据写入磁盘
bufferedOutputStream.flush();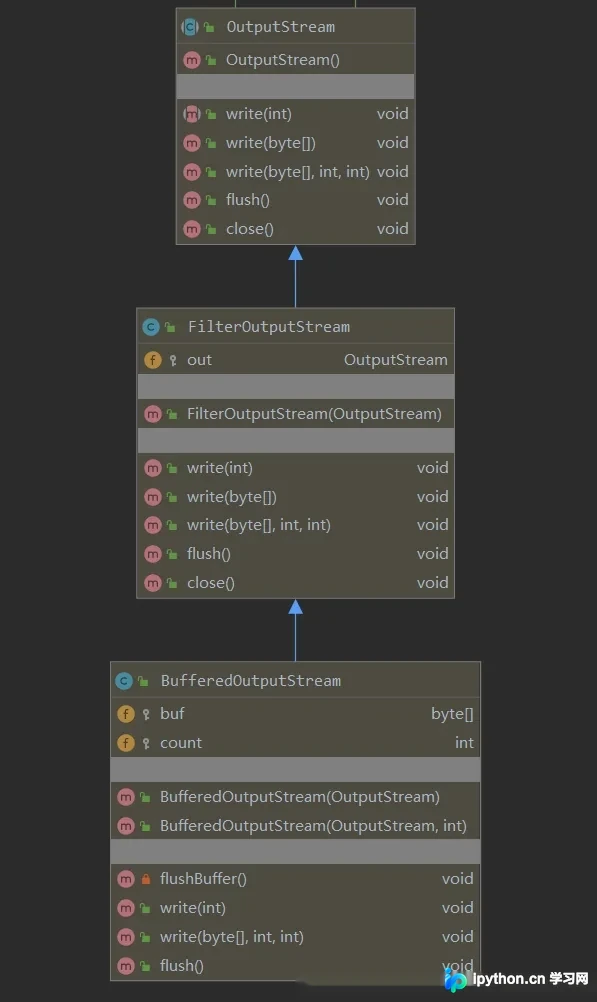
源码深度解析
了解内部实现有助于更好地调优。BufferedOutputStream 的类结构体现了典型的装饰器模式:
protected byte buf[];

// 默认构造函数,设置8KB缓冲区
public BufferedOutputStream(OutputStream out) {
    this(out, 8192);
}

// 指定大小构造函数
public BufferedOutputStream(OutputStream out, int size) {
    super(out);
    if (size <= 0) {
        throw new IllegalArgumentException("Buffer size <= 0");
    }
    buf = new byte[size];
}
当执行 write(int b) 时:
public synchronized void write(int b) throws IOException {
    // 如果缓冲区满了,先执行刷盘
    if (count >= buf.length) {
        flushBuffer();
    }
    // 将字节放入缓冲数组
    buf[count++] = (byte)b;
}
flushBuffer 方法的职责是将缓冲区非空的部分写入底层流:
private void flushBuffer() throws IOException {
    if (count > 0) {
        out.write(buf, 0, count); // 真正的磁盘写入
        count = 0; // 重置计数器
    }
}
缓冲区大小的优化建议
可以通过构造函数 BufferedOutputStream(out, size) 自定义缓冲区大小。对于高吞吐场景(如 Kafka 等消息队列组件),往往会调整这一参数。
- 增大缓冲区:
- 优点:大幅降低系统调用频率,提升吞吐量。
- 缺点:增加堆内存消耗;一旦异常崩溃,未刷盘丢失的数据量更大。
- 保持默认或较小:
- 适合对实时性要求高、数据量大但允许频繁刷盘的普通应用。
总结而言,使用 BufferedOutputStream 时应遵循“写完即刷”的原则,特别是在不确定是否充满缓冲区时,务必调用 flush() 或确保正确关闭流,以兼顾性能与安全。
以上就是 Java BufferedOutputStream 类的原理、常用方法与注意事项的详细内容,更多关于 Java IO 性能优化的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















