


Java基于Jsoup实现简单的网络爬虫示例

本文介绍了在Java环境中使用Jsoup库进行简单网页数据采集的方法。主要涵盖项目初始化、第三方依赖配置、建立网络连接、解析HTML DOM结构以及提取特定元素数据的全流程。通过百度贴吧数据抓取作为实例,展示了如何将HTML响应转化为结构化文本。
开发环境准备
首先启动Eclipse IDE,创建一个名为 pachong 的Java Project。
在项目中新建一个用于程序入口的Java Class文件:
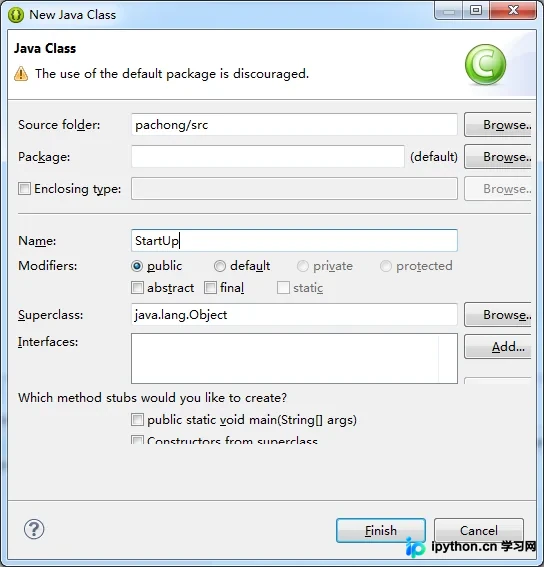
在生成的类中编写标准的程序入口方法 main:
public class StartUp {
	public static void main(String[] args) {

	}
}
引入核心依赖包
本示例主要依赖两个工具:一个是 jsoup 用于解析HTML网页,另一个是 commons-io 用于处理本地文件的数据保存。
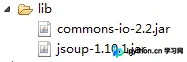
操作指南:将下载好的jar文件复制至项目目录后,右键点击对应的jar包,依次选择 Build Path → Add to Build Path 将其加入项目的编译路径中。
建立网络连接并获取页面
此处以百度贴吧“动漫吧”版块为例进行测试。目标链接地址为:https://tieba.baidu.com/f?kw=动漫&tpl=5(注:原文URL包含编码参数,实际测试时请替换为对应编码或动态链接)。
使用Jsoup的 connect 方法发起连接请求:
String url = "https://tieba.baidu.com/f?kw=动漫&tpl=5";
Connection connect = Jsoup.connect(url);
System.out.println(connect); // 打印连接对象确认连通性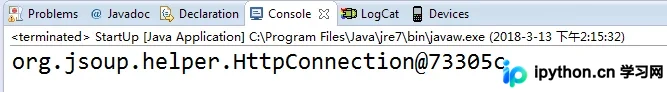
若控制台能成功打印出连接详情,表明基础网络环境正常。接着调用 get() 方法拉取服务端返回的完整HTML数据:
Document document = connect.get();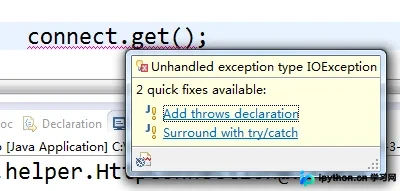
注意:此类网络IO操作可能因网络波动导致异常,需抛出 IOException。
解析HTML提取目标数据
完整的HTML结构被封装进 Document 对象中,此时我们可以查看解析后的结果:
System.out.println(document);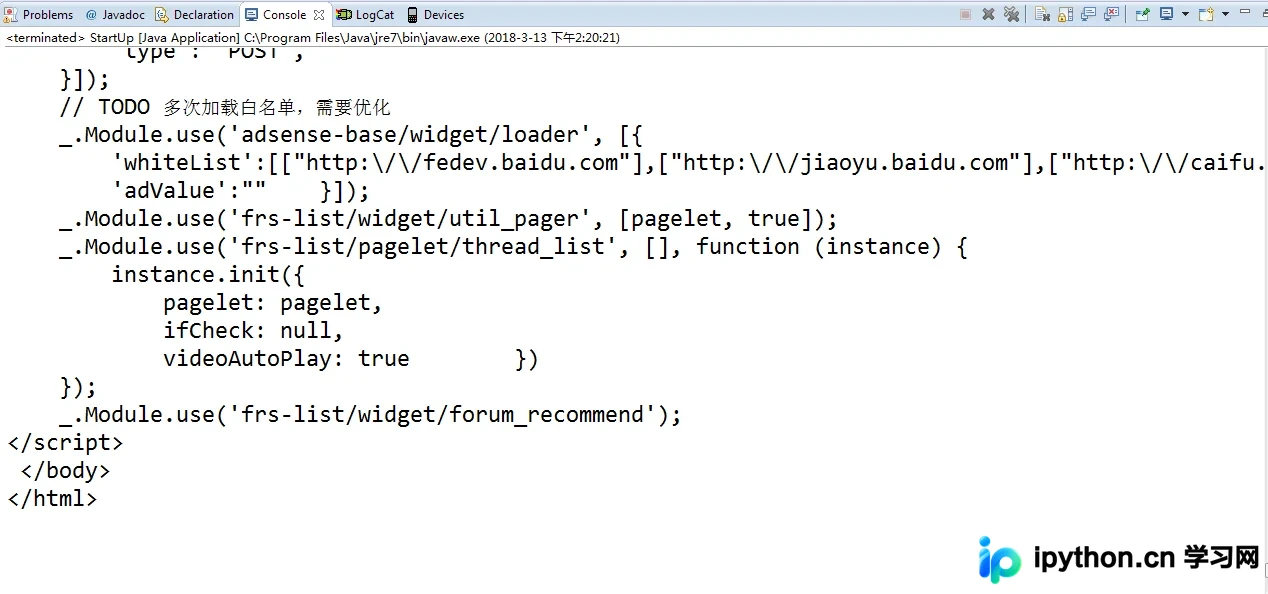
接下来定位我们要提取的核心信息——帖子标题。通过检查网页源码可以发现,每个标题都包裹在 a 标签内,并且具有特定的CSS样式类名 j_th_tit:
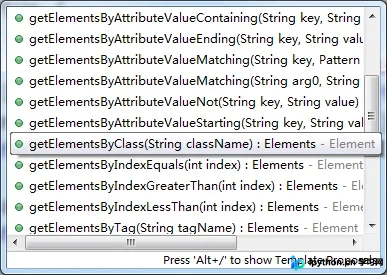
利用 Document 提供的 getElementsByClass 方法即可精准捕获这些节点:
Elements titles = document.getElementsByClass("j_th_tit");最后,遍历该集合对象,逐个获取每个节点的属性值并打印输出:
for (int i = 0; i < titles.size(); i++) {
    System.out.println(titles.get(i).attr("title"));
}
完整代码汇总
整合上述所有逻辑步骤,最终的Java实现代码如下:
import java.io.IOException;
import org.jsoup.Connection;
import org.jsoup.Jsoup;
import org.jsoup.nodes.Document;
import org.jsoup.select.Elements;

public class StartUp {
	public static void main(String[] args) throws IOException {
		// 1. 定义目标URL
		String url = "https://tieba.baidu.com/f?kw=动漫&tpl=5";

		// 2. 建立连接
		Connection connect = Jsoup.connect(url);

		// 3. 获取HTML文档
		Document document = connect.get();

		// 4. 根据CSS类名筛选元素
		Elements titles = document.getElementsByClass("j_th_tit");

		// 5. 遍历输出标题
		for (int i = 0; i < titles.size(); i++) {
			System.out.println(titles.get(i).attr("title"));
		}
	}
}
以上就是Java编程实现简单的网络爬虫示例过程的详细内容,更多关于Java实现网络爬虫的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















