


C语言实现BMP图像细化算法提取文字骨架

本文将详细讲解如何利用C语言读取BMP格式的二值图像,并通过迭代移除非骨架点来实现图像细化(Thinning),最终输出清晰的文字骨架图。该方法适用于需要从扫描文档或复杂图形中提取中心轮廓的应用场景。
原理与目标
图像细化旨在从二值图像中去除冗余的边界点,仅保留宽度为一个像素的骨架结构。所谓“骨架”,可以理解为图像的中轴线:长方形的长边中线、正方形的中心点、圆形的圆心等。细化的核心在于判断某个黑色(前景)像素是否可以安全删除而不破坏图像的拓扑结构。
判断依据主要依赖于该像素周围 3x3 邻域内的 8 个相邻像素的状态。一般遵循以下规则:
- 内部点不删:如果周围全是黑点,说明是物体内部,不能删。
- 孤立点不删:如果周围全是白点,说明是噪点或孤岛,不能删(视具体需求而定,通常保留)。
- 端点不删:如果是直线的终点,删除会导致结构断裂。
- 连通性保持:若删除某点会导致原有连通区域分裂成多个部分,则不可删除。
准备条件
为了简化处理逻辑,我们假设输入图像为 256级灰度图 且仅为调色板索引模式,其中只使用了调色板中的两项:0(黑色背景/前景)和 255(白色背景/前景)。程序将直接操作内存中的像素数据,跳过复杂的解压过程,直接针对黑白文本场景进行优化。
第1步:加载并解析BMP文件头
首先需要打开输入的 .bmp 文件,读取文件头(BITMAPFILEHEADER)和信息头(BITMAPINFOHEADER),获取图像的宽高、位深及每行字节数。同时读取调色板数据备用,用于输出相同格式的图像。
// ... 前置省略 ...
FILE* fp = fopen("./threshold.bmp", "rb");
if (fp == 0) return 0;

BITMAPFILEHEADER fileHead;
fread(&fileHead, sizeof(BITMAPFILEHEADER), 1, fp);

BITMAPINFOHEADER infoHead;
fread(&infoHead, sizeof(BITMAPINFOHEADER), 1, fp);
int width = infoHead.biWidth;
int height = infoHead.biHeight;
int biCount = infoHead.biBitCount;

// 计算每行实际的存储字节数(包含填充位)
int lineByte = (biCount*width / 8 + 3) / 4 * 4;
RGBQUAD* pColorTable;
pColorTable = new RGBQUAD[256];
fread(pColorTable, sizeof(RGBQUAD), 256, fp);

unsigned char* pBmpBuf,*pBmpBuf2;
pBmpBuf = new unsigned char[lineByte*height];
fread(pBmpBuf, lineByte*height, 1, fp);
fclose(fp);
// ... 后续处理 ...
第2步:初始化结果缓冲区
创建一个新的内存缓冲区 pBmpBuf2,初始状态下将其内容完全复制自原图数据。在细化过程中,我们将根据判断条件直接修改 pBmpBuf2 中的对应像素值(设置为 255 表示删除该点使其变白)。
// 新图
FILE* fop = fopen("thinging.bmp", "wb");
if (fop == 0) return 0;

pBmpBuf2 = new unsigned char[lineByte*height];
for (int i = 0; i < height; ++i){
 for (int j = 0; j < width - 1; ++j){
  *(pBmpBuf2 + i*lineByte + j) = *(pBmpBuf + i*lineByte + j);
 }
}
第3步:构建预定义匹配表与核心循环
为了提高运行效率,我们可以预先定义一组特定的“可删除”模板。在这个简化的算法演示中,我们定义了6种典型的边界点情况。通过遍历每个非边缘像素,采集其周围的8邻域数据,并与预定义的模板字符串进行比对。
注意:在实际工业级的Zhan/Suzuki算法中,需要两次扫描来判断旋转数和连通分量,此处代码展示了一种基于简单模板匹配的近似实现,重点在于演示数据结构的操作流程。
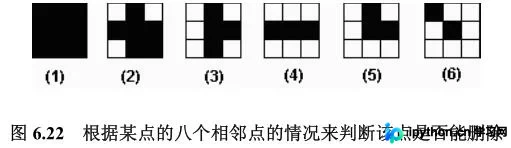
// 比较矩阵,0为黑,1为白;
// 这里的 str 数组定义了特定的可删除场景示例
char str[6][8] = { { 0, 0, 0, 0, 0, 0, 0, 0, }, { 255, 0, 255, 0, 0, 255, 0, 0 },
{ 255, 0, 255, 255, 0, 255, 0, 255 }, { 255, 255, 255, 0, 0, 255, 255, 255 },
{ 255, 0, 255, 255, 0, 255, 255, 255 }, { 0, 255, 255, 255, 255, 255, 255, 255 } };

int temp, k;
char strTemp[8];

// 避开图像边缘的一圈像素
for (int i = 1; i < height-1; ++i){
 for (int j = 1; j < width - 1; ++j){
  k = 0;
  // 采集8邻域数据
  for (int m = -1; m <= 1; ++m){
   for (int n = -1; n <= 1; ++n){
    // 注意:这里跳过了中心点(m==0 && n==0)
    if(m==0 && n==0) continue;
    temp = *(pBmpBuf + (i - m)*lineByte + (j + n));
    strTemp[k] = temp;
    k++;
   }
  }

  // 查表匹配
  for (int k = 0; k < 6; ++k){
   if (strcmp(strTemp, str[k])==0){
    // 如果匹配到预设的可删除模式,则将结果图中的该点置白(255)
    // 注:实际逻辑需确保这是单侧扫描或分阶段处理以防止过度腐蚀
    if (k == 3 || k == 5){
     *(pBmpBuf2 + i*lineByte + j) = 255;
    }
   }
  }
 }
}
第4步:保存结果文件
处理完成后,按照原始 BMP 文件的顺序,依次写入文件头、信息头、调色板以及经过细化处理后的像素数据 pBmpBuf2。
fwrite(&fileHead, sizeof(BITMAPFILEHEADER), 1, fop);
fwrite(&infoHead, sizeof(BITMAPINFOHEADER), 1, fop);
// 注意:通常调色板有256项,确保写入长度一致
fwrite(pColorTable, sizeof(RGBQUAD), 255, fop);
fwrite(pBmpBuf2, lineByte*height, 1, fop);
fclose(fop);
system("pause");
return 0;
实验结果
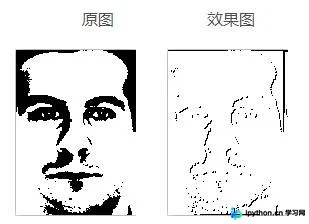
经过上述处理,原始的较粗文字或图形将被转化为均匀的线条骨架。这能有效降低后续OCR识别或特征提取的计算量。
总结
通过手动维护像素指针和预定义的模式匹配表,即使在低层的C语言环境中也能高效完成图像的形态学细化操作。需要注意的是,生产环境中建议使用更严谨的Zhan-Suzuki算法以确保拓扑结构的严格保持,避免产生悬挂毛刺或不必要的断裂。
以上就是C语言实现BMP图像细化处理的详细内容,更多关于C语言图像处理的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















