


C语言实现BMP图像处理(哈夫曼编码)

本文详细介绍如何在C语言中实现哈夫曼(Huffman)编码。哈夫曼编码是一种基于符号出现频率的无损压缩算法,通过构建最优二叉树为高频字符分配短码,低频字符分配长码,从而减小数据体积。内容涵盖算法核心步骤、C语言结构体设计、建树逻辑以及完整的编译运行示例。
哈夫曼编码的核心原理
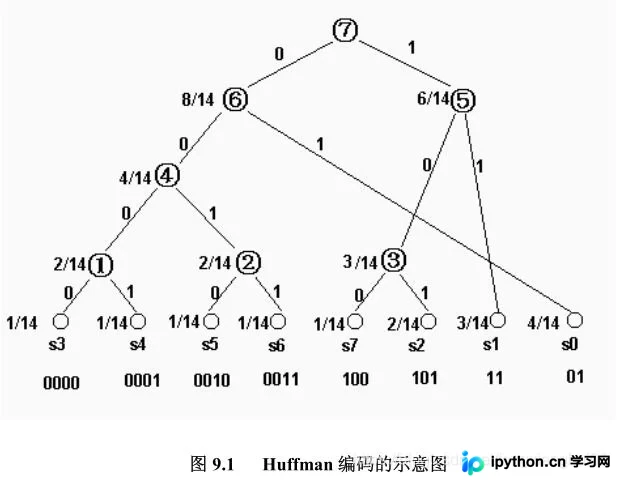
哈夫曼编码于1952年由David A. Huffman提出,其基本思想是利用数据中各字符出现的概率(频率)不同,设计长度不等的编码。具体操作遵循以下规则:
- 统计频率:遍历原始数据,精确统计每个符号出现的次数或频率。
- 排序初始化将统计结果按权值从小到大排列,每个节点作为独立的二叉树根节点。
- 合并节点:每次选取当前森林中权值最小的两棵二叉树,将它们合并为一棵新树,新树的根节点权值为左右子树根节点权值之和。
- 重复构建:重复上述过程,直到所有节点合并为一棵树,即最终的哈夫曼树。
- 生成编码:从根节点出发,约定左分支代表0,右分支代表1,路径上的序列即为该叶子节点的哈夫曼编码。
这种前缀编码确保了任何一个字符的编码都不是另一个字符编码的前缀,从而保证了解码的唯一性。
C语言实现步骤详解
在C语言中实现哈夫曼编码,主要涉及数据结构定义、树的创建、编码生成以及解码还原四个关键环节。以下是可直接运行的完整示例代码。
第1步:定义哈夫曼树节点结构体
首先需要定义用于存储哈夫曼树节点的结构体 TreeNode。该结构体需包含以下字段:
- weight:节点的权值(字符出现的频率)。
- id:记录原始字符的索引,主要用于后续解码时映射回原字符。
- lchild 和 rchild:分别指向左右子节点的指针。
第2步:构建哈夫曼树 (createTree)
建树是核心逻辑。算法采用贪心策略:初始化一个临时数组存放所有叶子节点;在循环中,每次从未参与合并的节点中找出权值最小的两个节点(记为 small1 和 small2);创建一个新的父节点,其权值为两者之和,并将这两个最小节点作为新节点的左右孩子;最后将新节点放回数组,标记原最小节点已使用(设为NULL),直到只剩一个根节点。
第3步:生成哈夫曼编码 (hufmTreeCode)
使用前序遍历递归实现。当访问到叶子节点时,打印当前静态数组中存储的路径(0或1组合)。非叶子节点在向左递归前存入0,向右递归前存入1,通过回溯切换状态以生成不同路径的编码。
第4步:解码过程 (hufmTreeDecode)
解码需要利用已建立的哈夫曼树。从根节点开始,读取编码串:
- 若遇到 '0',则进入左子树;
- 若遇到 '1',则进入右子树。
到达叶子节点时,根据节点的 id 找到对应的原始字符并输出,然后重新从根节点开始处理下一位编码。
#include <stdio.h>
#include <malloc.h>
#include <stdlib.h>
#include <string.h>

// 结构体
typedef struct Tree
{
 int weight; // 权值
 int id;     // 后面解码用到
 struct Tree * lchild; // 左孩子
 struct Tree * rchild; // 右孩子
}TreeNode;

// 创建哈夫曼树
TreeNode* createTree(int *arr, int n)
{
 int i, j;
 TreeNode **temp, *hufmTree;
 temp = (TreeNode**)malloc(sizeof(TreeNode*)*n); // 创建结构体指针数组
 for (i = 0; i < n; ++i)
 {
  temp[i] = (TreeNode*)malloc(sizeof(TreeNode));
  temp[i]->weight = arr[i];
  temp[i]->lchild = temp[i]->rchild = NULL;
  temp[i]->id = i;
 }

 for (i = 0; i < n - 1; ++i)
 {
  int small1 = -1, small2; // 存储最小权值的两个节点
  for (j = 0; j < n; ++j)  // 第一步:找到最开始两个非空节点
  {
   if (temp[j] != NULL && small1 == -1)
   {
    small1 = j;
    continue;
   }
   if (temp[j] != NULL)
   {
    small2 = j;
    break;
   }
  }
  for (j = small2; j < n; ++j) // 找到权值最小的两个节点,并将最小的序号赋给small1,次小的赋给small2
  {
   if (temp[j] != NULL)
   {
    if (temp[j]->weight < temp[small1]->weight)
    {
     small2 = small1;
     small1 = j;
    }
    else if (temp[j]->weight < temp[small2]->weight)
    {
     small2 = j;
    }
   }
  }
  hufmTree = (TreeNode*)malloc(sizeof(TreeNode));
  hufmTree->lchild = temp[small1];
  hufmTree->rchild = temp[small2];
  hufmTree->weight = temp[small1]->weight + temp[small2]->weight;

  temp[small1] = hufmTree;
  temp[small2] = NULL;
 }
 free(temp);
 return hufmTree;
}

// 前序遍历
void PreOrderTraversal(TreeNode* hufmTree)
{
 if (hufmTree)
 {
  printf("%d", hufmTree->weight);
  PreOrderTraversal(hufmTree->lchild);
  PreOrderTraversal(hufmTree->rchild);
 }
}

// 哈夫曼编码
void hufmTreeCode(TreeNode* hufmTree,int depth)
{
 static int code[10],i;

 if (hufmTree)
 {
  if (hufmTree->lchild == NULL && hufmTree->rchild == NULL)
  {
   int i=0;
   printf("权值为%d的节点,哈夫曼编码为:", hufmTree->weight);
   for (i = 0; i < depth; ++i)
   {
    printf("%d", code[i]);
   }
   printf("\n");
  }
  else
  {
   code[depth] = 0;
   hufmTreeCode(hufmTree->lchild, depth + 1);
   code[depth] = 1;
   hufmTreeCode(hufmTree->rchild, depth + 1);
  }
 }
}

// 哈夫曼解码
// 思想:通过定位ID,找到源码中的位置
void hufmTreeDecode(TreeNode* hufmTree, char a[],char st[])
{
 int i,arr[100];
 TreeNode* temp;
 for (i = 0; i < strlen(a); ++i) // 转化字符串编码为数组编码
 {
  if (a[i] == '0')
   arr[i] = 0;
  else
   arr[i] = 1;
 }
 i = 0;
 while (i < strlen(a))
 {
  temp = hufmTree;
  while (temp->lchild != NULL && temp->rchild != NULL)
  {
   if (arr[i] == 0)
    temp = temp->lchild;
   else
    temp = temp->rchild;
   i++;
  }
  printf("%c", st[temp->id]);
 }
 printf("\n");
 free(temp);
}

int main()
{
 int i, n, arr[100];
 printf("输入需要创建的节点个数:\n");
 scanf("%d", &n);
 printf("输入权值:\n");
 for (i = 0; i < n; ++i)
  scanf("%d", &arr[i]);

 printf("\n请输入每个权值对应的字符:\n");
 char st[100];
 scanf("%s",st);

 // 创建哈夫曼树
 TreeNode* hufmTree;
 hufmTree = createTree(arr, n);

 // 哈夫曼编码
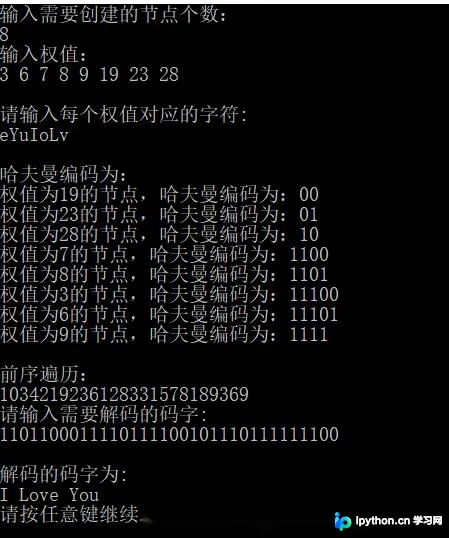
 printf("\n哈夫曼编码为:\n");
 hufmTreeCode(hufmTree, 0);

 // 遍历
 printf("\n前序遍历:\n");
 PreOrderTraversal(hufmTree);

 // 解码
 printf("\n请输入需要解码的码字:\n");
 char codeSt[100];
 scanf("%s",codeSt);
 printf("\n解码的码字为:\n");
 hufmTreeDecode(hufmTree, codeSt, st);

 free(hufmTree);
 system("pause");
 return 0;
}
应用局限性与优化方向
标准的哈夫曼编码需要对原始数据进行两次扫描:第一次统计频率,第二次构建树并编码。虽然算法简单有效且压缩率较高,但在实际大规模数据处理(如实时视频流或大型文件压缩)中,建立二叉树和遍历操作会带来较大的计算开销,导致速度相对较慢。此外,静态哈夫曼编码无法适应数据分布的变化。在现代图像处理(如BMP压缩)中,通常会根据数据特性选择更高效的变种(如LZW)或结合其他变换编码技术,但在教学和小规模数据压缩场景中,C语言实现的这一标准算法仍具有极高的参考价值。
总结
通过上述C语言代码,我们可以清晰地看到哈夫曼编码从统计、建树到编解码的全过程。掌握这一算法不仅有助于深入理解数据结构与算法的设计思想,也为后续学习更复杂的文件格式解析和优化提供了基础。以上就是C语言实现哈夫曼编码的详细内容,更多关于编程入门的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















