


MySQL LIMIT深层原理解析与深度分页优化方案

在MySQL数据库开发中,LIMIT子句常用于分页查询。然而,当偏移量(OFFSET)很大时,查询性能会显著下降。本文深入剖析MySQL Server层与InnoDB存储引擎在处理LIMIT时的交互机制,解释为何深度分页会导致回表开销巨大,并给出通过子查询优化的具体解决方案。
问题现象与分析
为了便于理解,首先构建一个包含1万条记录的测试表 t:
CREATE TABLE t (
    id INT UNSIGNED NOT NULL AUTO_INCREMENT,
    key1 VARCHAR(100),
    common_field VARCHAR(100),
    PRIMARY KEY (id),
    KEY idx_key1 (key1)
) Engine=InnoDB CHARSET=utf8;
表中 id 为主键,key1 为二级索引列。
浅层分页(使用索引):
当执行取第一条记录的查询时,MySQL能充分利用二级索引 idx_key1:
EXPLAIN SELECT * FROM t ORDER BY key1 LIMIT 1;执行结果显示 type 为 index,仅扫描1行。因为 key1 有序,MySQL直接从索引树获取第一条记录的回表数据即可。
深层分页(回表失效):
若将需求改为跳过前5000条,取第1条记录:LIMIT 5000, 1,执行计划却变为:
EXPLAIN SELECT * FROM t ORDER BY key1 LIMIT 5000, 1;此时 type 变为 ALL(全表扫描),并使用 Using filesort。许多人疑惑:既然有索引,为何不能直接找到第5001条索引记录并回表?这涉及到底层的实现机制。
Server层与存储引擎层的交互机制
MySQL由负责逻辑处理的 Server层 和负责物理存储的 InnoDB引擎层 组成。SQL的执行依赖两者的多次交互:
- 发起请求:Server层解析SQL后,调用存储引擎接口请求数据区间内的第一条记录。
- 引擎执行:InnoDB通过B+树定位到对应二级索引记录,进行回表(访问主键聚簇索引)获取完整记录返回给Server层。
- 条件过滤与发送:Server层接收记录后应用
WHERE条件过滤。符合要求的记录暂存于本地网络缓冲区(默认16KB),满包或结束时才发送至客户端。 - 循环获取:Server层继续请求“下一条”记录。由于所有索引记录均按链式结构连接,InnoDB依次向后查找,重复上述回表过程。
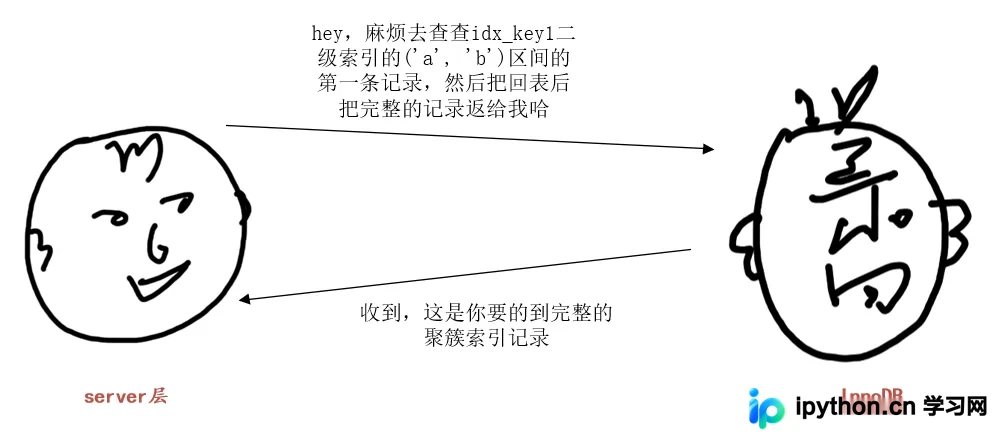
图1:Server层向InnoDB请求指定区间的初始记录
这一机制在正常遍历时效率尚可,但在处理复杂的 LIMIT 偏移时暴露出严重瓶颈。
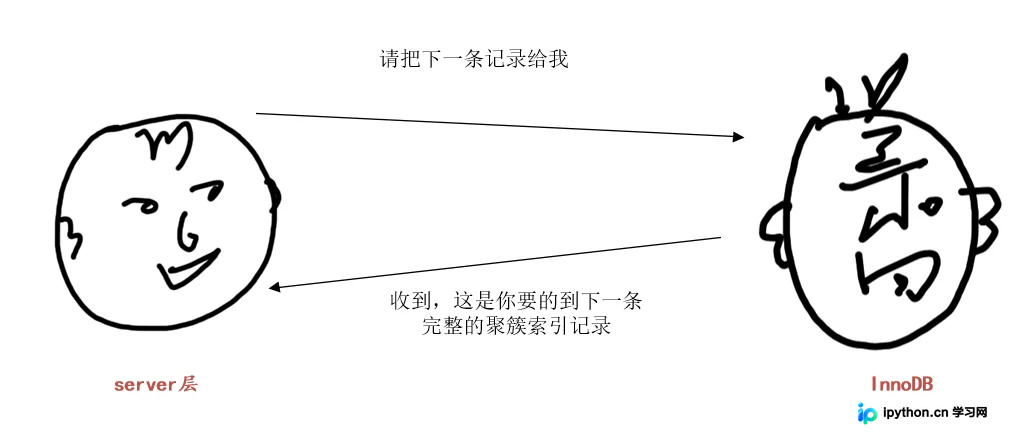
图2:获取中间节点并触发服务器端过滤判断
为何深分页会导致全表扫描?
LIMIT m, n 的处理发生在 Server层 准备发送数据之前,而非存储引擎内部完成。
- 计数机制:Server层维护一个计数器。对于
LIMIT 5000, 1,它需要丢弃前5000条符合条件的记录。 - 代价计算:如果使用二级索引,Server层必须驱动InnoDB连续回表5001次,每回表一次都要检查条件并递增计数器。
- 优化器决策:在执行计划阶段,优化器评估发现:5000次随机I/O(回表)的成本远高于顺序I/O(全表扫描)。因此,即使存在可用索引,优化器也会选择全表扫描 + 文件排序(filesort),以避免大量的上下文切换与随机磁盘读取。
图3:循环过程中服务器端对回表结果进行计数判定
简而言之,MySQL的设计缺陷在于无法让存储引擎只返回特定位置的结果,导致Server层承担了巨大的“无效”回表工作。
深度分页优化方案
要解决此问题,核心思路是:让存储引擎只做索引扫描,将回表动作推迟到最后一步。
可以将原来的查询改写为关联子查询,仅在子查询中获取符合条件的主键ID:
SELECT * FROM t,
    (SELECT id FROM t ORDER BY key1 LIMIT 5000, 1) AS d
WHERE t.id = d.id;
执行流程优势:
- 子查询独立执行:内部子查询
(SELECT id ...)仅扫描idx_key1二级索引树。因为只需要id字段,而id已在索引中或通过聚簇索引根节点获取(覆盖索引概念),无需回表。 - 结果集极小:子查询仅返回一条主键值
id。 - 精准回表:外层查询根据获取到的单个
id进行一次精准的主键回表,获取整行数据。
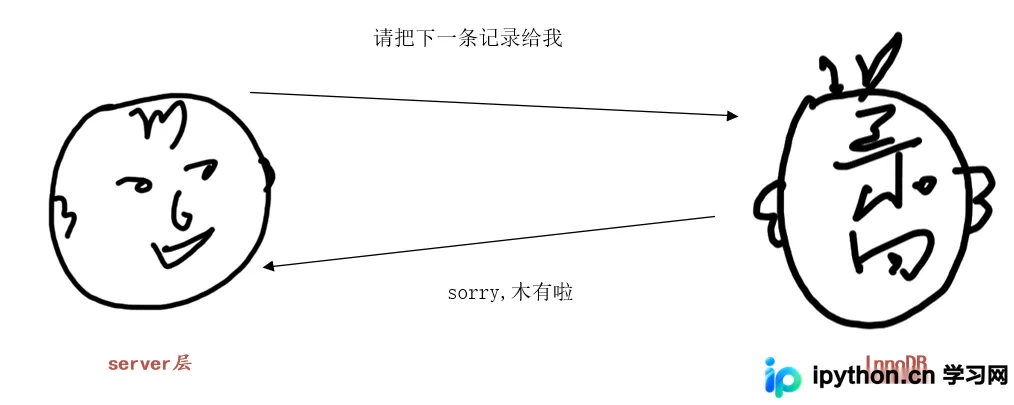
图4:最终通过主键精确检索并返回结果
这种写法巧妙欺骗了优化器,使其放弃了全表扫描,转而使用高效的“索引覆盖 + 少量回表”模式,大幅降低了I/O消耗。
总结
理解Server层与引擎层的分工是优化MySQL的关键。LIMIT 的深度偏移会导致大量无意义的回表操作,从而引发执行计划退化至全表扫描。在实际业务中,面对深分页场景,采用先查ID再查数据的优化方式,能有效提升数据库响应速度。
以上就是MySQL中LIMIT语句深层原理与优化方案的详细内容,更多关于MySQL的性能调优与高级用法资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















