


C++ 内联函数:原理、语法与使用规范详解

C++ 内联函数(inline function)旨在解决频繁调用带来的性能损耗问题。它通过将函数体直接嵌入调用点,消除了传统函数调用的压栈与出栈开销。然而,内联并非强制指令,且存在代码体积膨胀的风险。本文将详细拆解其语法结构、与宏定义的优劣对比,并列出在实际开发中必须遵守的使用禁忌与规范。
内联函数的核心机制
在 C 语言中,开发者常通过宏(Macro)来实现类似内嵌的效果。宏处理发生在预处理阶段,虽然避免了函数调用的开销,但缺乏类型检查和语法检测,容易引发语义差错或难以调试的逻辑错误。C++ 引入 inline 关键字,提供了一种兼具宏的效率优势和函数的类型安全特性的高级抽象。
从编译原理角度理解,当编译器遇到内联函数的调用表达式时,会在编译阶段直接用函数体的代码进行替换。这意味着原本需要在运行时刻才进行的跳转操作,被转化为了编译时刻的代码展开。这是一种典型的以空间换时间的策略,通常适用于代码简短(1-5行)、逻辑简单且被高频调用的函数。
第1步:理解宏定义与内联函数的本质差异
为了清晰界定两者的边界,我们可以通过一段对比代码来观察其行为。宏仅仅是文本替换,而内联函数具备完整的函数语义。
#include <iostream>
#include <string.h>
using namespace std;

// 宏定义方式:仅做文本替换,无类型检查
#define SQR(x) ((x)*(x))

// 内联函数方式:具备类型检查与函数作用域
inline int sqr(int x)
{
	return (x)*(x);
}

int main()
{
	int i=0;
	while(i<5)
	{
		// 宏调用示例
		printf("%d\n",SQR(i++)); // 注意:宏展开可能导致i++执行多次
		printf("%d\n",i);

		// 内联函数调用示例
		printf("%d\n",sqr(i++)); // 参数求值后传递,行为可预测
		printf("%d\n",i);
	}
	return 0;
}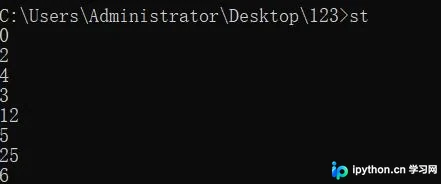
上图为内联展开前后汇编代码或内存布局的对比示意,直观展示代码替代过程。
内联函数的优缺点评估
在使用内联函数进行性能优化时,必须权衡以下利弊:
- 优势:
- 消除调用开销:避免寄存器压栈、返回地址保存及跳转指令的执行。
- 类型安全:作为真正的函数,支持参数类型检查,减少隐性 Bug。
- 调试友好:符号表中有明确的函数名,便于调试器定位,优于宏。 - 劣势:
- 代码膨胀:每个调用点都会复制一份函数体代码。若函数较大或被广泛调用,会显著增加二进制文件大小,可能导致缓存命中率下降反而降低性能。
- 非强制性:inline仅是向编译器发出的建议。如果函数包含复杂逻辑(如循环),编译器可能会自动忽略该建议,将其视为普通函数。
内联函数的严格使用规范
为确保内联机制生效并避免未定义行为,请遵循以下关键约束:
第2步:检查函数体内的语句结构
内联函数内部不允许包含循环语句(for, while, do-while)和开关语句(switch)。这些控制流结构会增加代码复杂性,编译器通常会拒绝将它们内联。保持函数简短是实现高性能内联的前提。
第3步:确保定义位置的合规性
由于内联依赖编译时的文本替换,内联函数的完整定义必须出现在第一次调用之前。如果在头文件中声明但在源文件中定义,会导致链接错误或未按预期内联。通常做法是将内联函数的定义直接写在头文件(.h / .hpp)中,或者放在类的成员函数声明处。
第4步:利用类结构的隐式内联特性
在类结构(class/struct)内部,所有直接定义的成员函数默认都是内联函数。即使未显式添加 inline 关键字,编译器也会尝试内联这些函数。这种设计符合现代 C++ 最佳实践,既简化了代码,又提升了封装性与性能。
总结
C++ 内联函数是连接宏的高效与函数的安全之间的桥梁。正确使用它能显著提升短小函数的执行效率,但不当使用会导致代码体积失控。开发者应牢记“简短为宜、定义前置、避开复杂控制流”的原则,结合编译器实际生成的汇编代码进行性能验证。以上就是C++内联函数原理、对比及规范的详细内容,更多关于C++性能优化的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















