


C++浮点数存储原理与使用注意事项详解

C++中的浮点数用于表示带小数部分的数字,其存储结构远比整数复杂。文章详细拆解了IEEE 754标准的二进制编码规则,包括尾数的隐含位优化和阶码的偏置处理,并列举了代码示例说明如何正确进行浮点精度比较及避免大数运算中的有效数字丢失问题。
浮点数的基本概念与存储结构
在C++中,浮点数是第二组基本数据类型,主要用于处理需要小数精度的场景。与整数直接存储二进制01串不同,浮点数通过特定的科学计数法形式在计算机内存中进行编码,以平衡数值范围与精度。
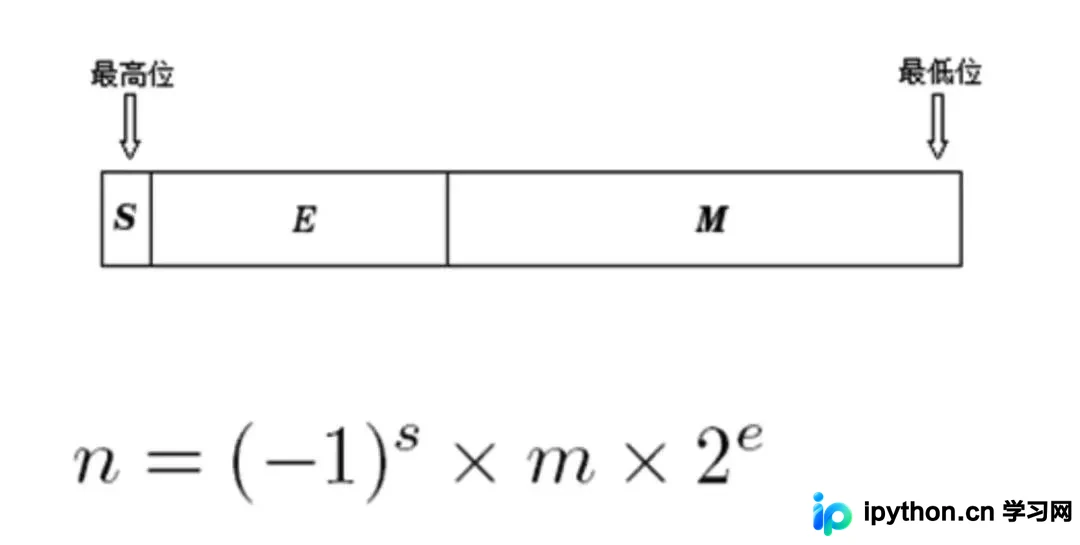
浮点数的通用存储公式可表示为:(-1)^s * m * 2^e。其中:
s:符号位,0代表正数,1代表负数。m:尾数(Mantissa),即有效数字部分。e:指数(Exponent),用于确定小数点的位置。
以十进制3.0为例,其二进制表示为11.0。转换为科学计数法即为1.1 × 2^1。在此情况下,s=0,m=1.1,e=1。
尾数m的处理规则
根据IEEE 754标准,尾数m被归一化定义为满足 1 ≤ m < 2 的小数。这意味着其二进制形式总是以“1.”开头,例如 1.xx...
隐含位优化:由于m的最高位恒为1,存储时该位会被省略,仅保留小数点后的部分。这不仅节省了存储空间,还额外增加了一位的有效精度。
例如,对于32位浮点数(float):
- 总位数:32位
- 符号位:1位
- 阶码位:8位
- 尾数位:23位
虽然只存储了23位小数,但加上隐含的1位整数1,实际有效精度相当于24位二进制位。
阶码e的编码方式
阶码e在内存中以无符号整数形式存储。为了能够表示负指数,IEEE 754引入了偏移量(Bias)机制。
偏移量计算
真实指数值 = 存储值 - 偏移量。
对于32位浮点数,偏移量为127;对于64位双精度(double),偏移量为1023。
例如,若真实指数为10,则在内存中存储的值应为 127 + 10 = 137。
特殊情况处理
阶码e的全0或全1组合具有特殊含义:
- 正常情况:
e不全为0且不全为1时,按上述偏移规则还原真实指数,尾数默认加1(隐含位)。 - 次正规数(Denormalized):当
e全为0时,真实指数固定为 1 - 127 = -126,且尾数不再加1(即 m = 0.xx...)。此设计用于表示接近于0的极小数值,平滑过渡到零。 - 无穷大与NaN:当
e全为1时:
- 若尾数
m全为0,表示无穷大(Inf),符号由s决定。 - 若尾数
m不全为0,表示非数字(NaN, Not a Number)。
- 若尾数
这种设计避免了引入额外的符号位来处理指数的正负,使得硬件比较逻辑更加简洁优雅。
C++浮点数的书写与类型
C++提供了三种浮点类型:float(单精度)、double(双精度)和long double(扩展精度)。
书写方式
1. 常规小数点表示法:
double a = 1.23;
float b = 3.43f; // 注意后缀f
2. 科学记数法:
double large = 2.45e8;   // 2.45 × 10^8
double small = 1e-7;     // 1 × 10^-7
注意:`e` 前后不能包含空格,`e` 后跟随的是10的幂次。
类型特性对比
float:通常占用4字节(32位),有效数字约7位十进制,指数范围至少为 -37 到 37。double:通常占用8字节(64位),有效数字约16位十进制,精度更高,范围更广。long double:至少与double一样宽,具体取决于编译器和平台。
常量类型提示:在代码中书写的浮点常量(如 `1.23`)默认类型为 double。若需赋值给 float 变量,建议添加后缀 f 或 F(如 `2.34f`),以避免隐式转换警告或精度丢失风险。
浮点数使用的关键注意事项
1. 禁止直接判断相等
由于二进制无法精确表示某些十进制小数(如0.1),直接使用 == 运算符比较两个浮点数往往会导致错误的结果。正确的做法是比较它们的差值是否小于一个极小的阈值(epsilon)。
#include <cmath>

// 定义精度阈值
const double epsilon = 1e-8;

// 判断 a 和 b 是否“相等”
if (std::abs(a - b) < epsilon) {
    // a 和 b 视为相等
}
2. 大数运算中的精度丢失
当参与运算的数值数量级差异过大时,较小的数值可能因超出浮点数的有效精度范围而被“吞没”,导致运算无效。
float a = 2.3e22f;
float b = a + 1.0f;

// 输出结果为 0
std::cout << b - a << std::endl;原因分析:a 是一个拥有23位整数部分的巨大数值,而 float 类型仅有约7位十进制的有效精度。在向 a 加上1时,1所处的数位远低于 a 的最小有效位,因此加法操作对结果没有影响,最终 b 等于 a,差值为0。
3. 输出格式简化
使用 std::cout 输出浮点数时,默认会去掉末尾无意义的零。例如 `1.230` 可能被显示为 `1.23`。如需控制输出精度,可使用 std::fixed 和 std::setprecision。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















