


JavaScript 闭包原理与应用详解

闭包是 JavaScript 中最重要且独特的概念之一。它允许内部函数访问并保留外部函数的变量状态,即便外层函数已经执行完毕。本文将通过代码实例解析闭包的运作原理,演示其在实现数据记忆和模拟私有变量方面的实际应用,并分析使用时的注意事项。
什么是 JavaScript 闭包
闭包是指一个函数与其声明时所处的词法环境(环境状态)的组合。简单来说,就是函数能够记住并访问其定义时所在的作用域中的变量,即使该函数是在其定义的环境之外被调用或执行。
这意味着,如果我们将一个内部函数返回到外部,这个内部函数就形成了一个“闭包”,它拥有对创建它的外部函数局部变量的持久访问权。
基础示例:
function foo() {
    let a = 1;
    return function() {
        console.log(a);
    }
}
let foo1 = foo();
foo1(); // 输出 1在上述代码中,foo() 执行完毕后通常会销毁其作用域内的变量 a。但由于 foo() 返回了一个引用了 a 的内部匿名函数,并被赋值给 foo1,因此 a 依然存在于内存中。foo1 继续持有对该变量的访问权限,这就是闭包的基本形态。
闭包的主要应用场景
第1步:利用闭包实现数据记忆性
闭包最显著的特性之一是“记忆性”。当闭包产生时,其包含的外部函数环境状态会一直保存在内存中,不会随着外层函数的调用结束而被垃圾回收机制清除。
这种机制使得变量可以在多次函数调用之间保持状态。每个闭包实例都维护着自己独立的变量副本。
function foo() {
    let a = 0;
    return function() {
        a ++;
        console.log(a);
    }
}
let foo1 = foo();
let foo2 = foo();

foo1();  // 输出 1
foo2();  // 输出 1
foo2();  // 输出 2
foo1();  // 输出 2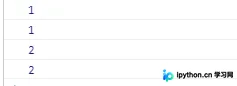
运行结果解析:
由于 foo1 和 foo2 分别调用了两次 foo(),它们各自生成了两个完全独立的闭包。每个闭包内部的 a 初始值都为 0,互不影响。因此,尽管初始值相同,但随着各自的调用次数增加,内存中的累加值也独立增长。
第2步:利用闭包模拟私有变量
在 JavaScript 早期版本中没有类的私有属性概念,闭包常被用来模拟私有变量,从而保证数据的封装性和安全性。通过将变量包裹在函数作用域内,只暴露特定的操作方法供外部调用,外部无法直接访问或修改该变量。
function foo() {
    let A = 0;
    return {
        getA : function() {
            return A;
        },
        add : function() {
            A ++;
        },
        del : function() {
            A --;
        }
    }
}
let foo1 = foo();

console.log(foo1.getA()); // 输出 0
foo1.add();
console.log(foo1.getA()); // 输出 1
foo1.del();
console.log(foo1.getA()); // 输出 0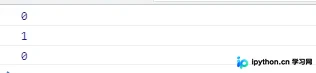
在这个例子中,A 是 foo 的局部变量,外部代码无法直接读取或修改 A 的值。只有通过 foo1 暴露出来的 getA、add 和 del 方法才能安全地操作该数据。这就实现了类似面向对象编程中“私有字段”的效果。
使用闭包的注意事项
虽然闭包功能强大,但不能滥用。由于闭包会使外部函数的变量始终驻留在内存中,如果频繁创建大量闭包或在循环中不当使用,可能会导致内存占用过高,进而引发页面性能下降甚至内存泄漏。
在实际开发中,应确保不再需要引用的闭包变量及时解除引用(例如将变量设为 null),以帮助 JavaScript 引擎进行垃圾回收。
总结
以上就是 JavaScript 闭包原理解析与实战应用的详细内容,更多关于 JavaScript 进阶教程的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















