


C语言数据的存储:类型、原反补与大小端详解

C语言中的数据存储由数据类型决定,涉及整型的原反补码转化、大小端字节序差异以及浮点数的特殊编码规则。理解这些底层机制有助于排查程序中的隐蔽Bug,如死循环和数据截断问题。
1. 数据类型与内存视角
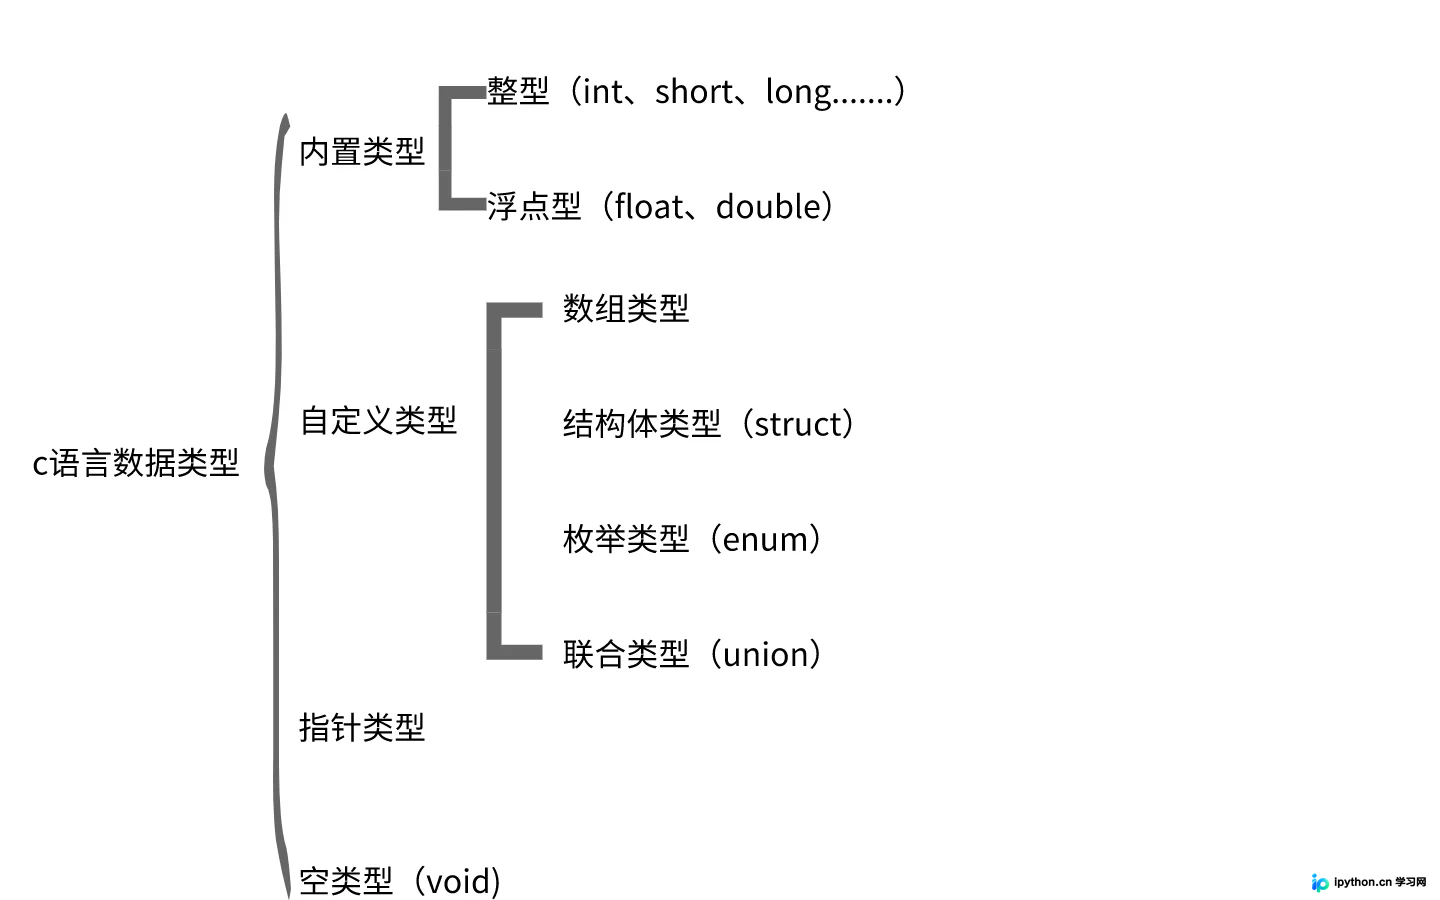
C语言的数据类型决定了编译器如何解释内存空间中的数据。类型主要分为内置类型和自定义类型:
- 内置类型:包括整型(
char,short,int,long,分有符号signed和无符号unsigned)和浮点型(float,double)。 - 自定义类型:数组、结构体
struct、枚举enum和联合union。 - 其他:指针类型和空类型
void。
不同类型的核心区别在于对同一串二进制位的解释方式不同。例如,同一段内存,以整数看待是数值大小,以字符看待是ASCII码值。
2. 整型的存储:原码、反码与补码
在计算机系统中,整型数据统一以补码形式存储。这解决了负数表示和减法运算的问题。
第1步:理解原码、反码、补码的关系
- 原码:直接将二进制按正负号形式翻译(最高位为符号位,0为正,1为负)。
- 反码:原码的每一位取反(符号位不变,或根据具体定义,通常针对数值位)。
- 补码:反码加1。
关键规则:
- 正数:原码 = 反码 = 补码。
- 负数:需要计算。例如 -1 在8位二进制中:
- 原码:1000 0001
- 反码:1111 1110
- 补码:1111 1111
- 无符号数:
unsigned类型没有符号位,其原码、反码、补码完全一致,能表示更大的正数范围,但无法表示负数。
第2步:大小端存储模式判断
内存按字节编址,多字节数据(如 int 占4字节)在内存中的存放顺序分为两种:
- 大端存储(Big-Endian):数据的低位字节保存在内存的高地址中。
- 小端存储(Little-Endian):数据的低位字节保存在内存的低地址中。
现代PC机大多采用小端存储。可通过强制指针类型转换来检测:
#include <stdio.h>
int main()
{
    int a = 1;
    // 获取a的地址,并强制转换为字符指针
    // char* 解引用时只读取1个字节,即最低地址处的内容
    char* p = (char*)&a;

    // 如果低地址处存储的是1(低位),则为小端
    if (*p == 1)
    {
        printf("小端\n");
    }
    else
    {
        printf("大端\n");
    }
    return 0;
}
3. signed 与 unsigned 的差异陷阱
signed与unsigned的核心区别在于是否能表示负数,这直接影响了变量的取值范围和循环终止条件。
第3步:无符号数的死循环风险
当使用 unsigned 类型作为循环变量时,需警惕下溢问题。
#include <stdio.h>
int main()
{
    unsigned int i;
    for (i = 9; i >= 0; i--)
    {
        // 当 i 减到 0 后,再执行 i--
        // 由于是无符号类型,0 减去 1 会变成最大的无符号整数
        // 因此 i >= 0 永远成立,导致死循环
        printf("%d", i);
    }
}
第4步:char 类型的存储范围
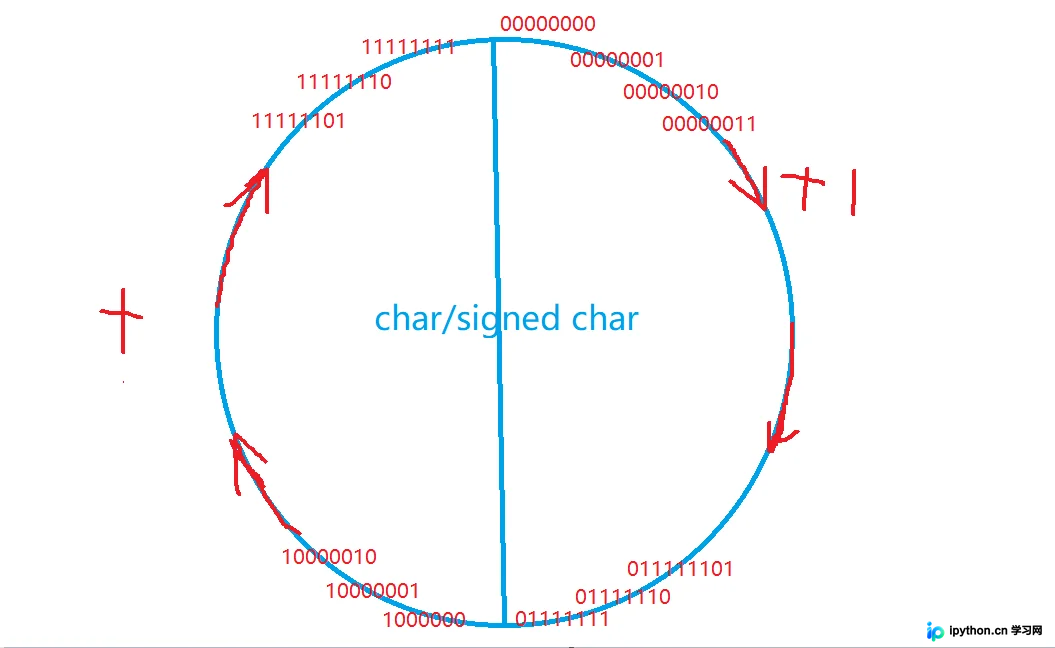
char 类型通常为1字节(8 bits)。若为 signed char,范围为 -128 到 127;若为 unsigned char,范围为 0 到 255。
注意:在大多数实现中,char 默认等同于 signed char。二进制 10000000 在 signed char 中表示 -128,而在 unsigned char 中表示 128。
第5步:strlen 与字符截断实例
观察以下代码,理解字符型数组的存储上限:
#include <stdio.h>
#include <string.h>
int main()
{
    char a[1000];
    int i;
    for (i = 0; i < 1000; i++)
    {
        a[i] = -1 - i;
        // 当 i=127 时, a[127] = -128
        // 当 i=128 时, a[128] = -129 -> 溢出变成 127 (unsigned 视角) 或根据编译器特性变化
        // 关键在于,char 是 8 位,超过范围会循环或截断
    }
    // strlen 计算遇到 '\0' (值为0) 停止
    // -1 - i 的值序列中,何时会出现 0?
    // 在 signed char 中,-1, -2 ... -128, 127, 126 ... 0
    // 从 -1 到 -128 是 128个数,从 127 到 0 是 128个数
    // 总共 255 个非零字符,直到出现一个值为 0 的字节才结束
    printf("%d", strlen(a));
    return 0;
}
输出结果为 255。因为 char 只有8位,存储范围有限,赋值操作会发生截断或循环映射,最终在数组中形成特定的非零序列直到偶然遇到0。
4. 浮点数的特殊存储(IEEE 754)
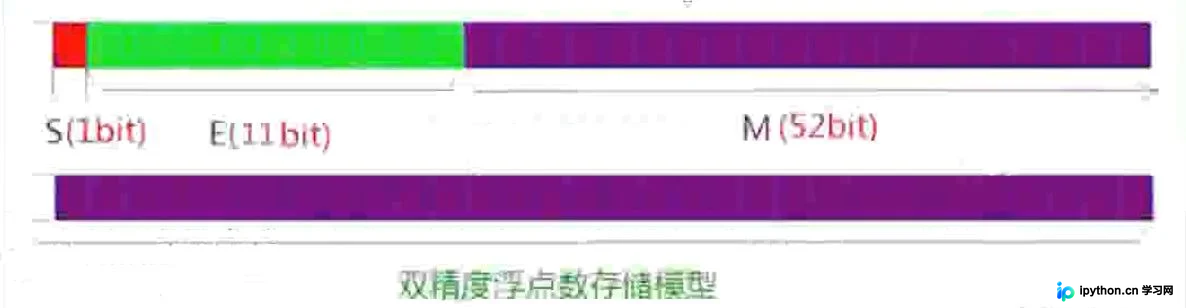
浮点数不使用原反补码存储,而是遵循 IEEE 754 标准,分为符号位、指数位和尾数位。
第6步:浮点数结构解析
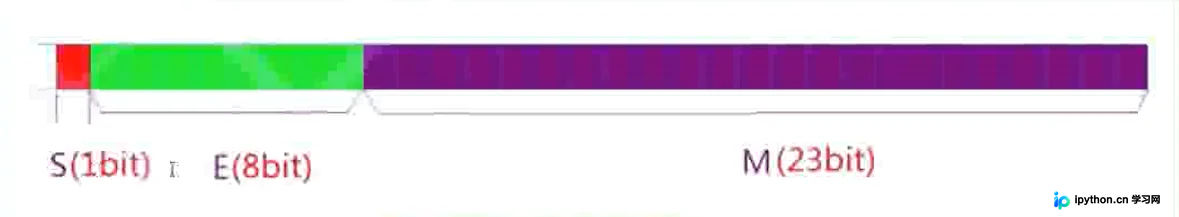
以 float(单精度)为例,共32位:
- S (Sign):1位,符号位(0正1负)。
- E (Exponent):8位,阶码,用于表示数量级。
- M (Mantissa):23位,尾数,表示有效数字。
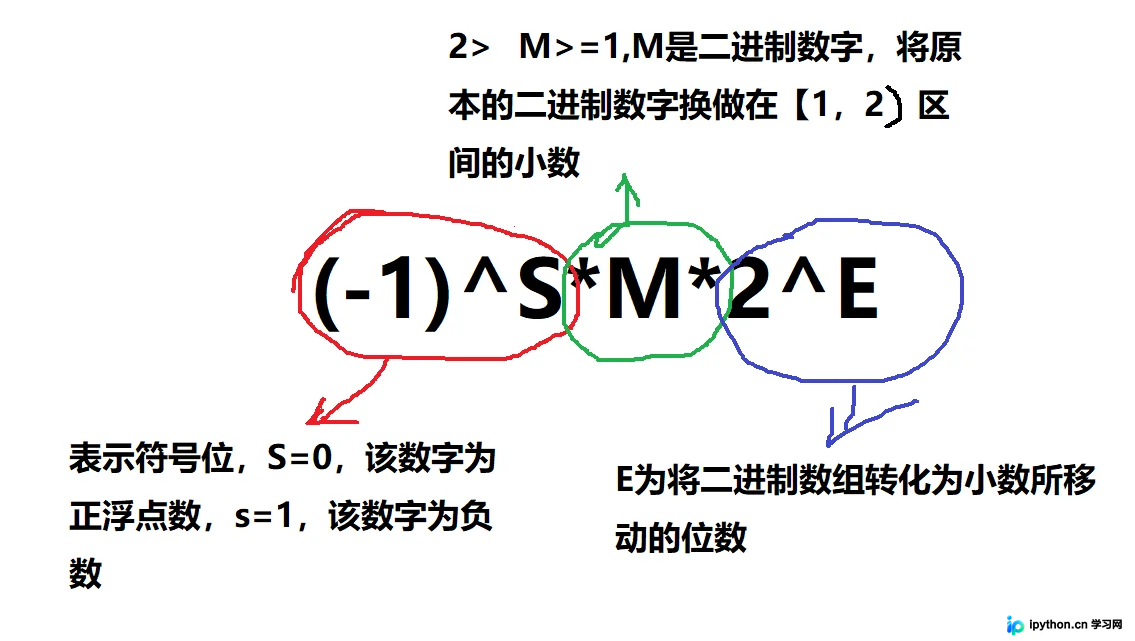
数值计算公式为:$V = (-1)^S \times M \times 2^E$。
第7步:实例演示 8.5 的存储
将十进制 8.5 转换为二进制:1000.1。
科学计数法规范化:1.0001 × 2³。
对应字段:
- S:0(正数)。
- E:真实指数为 3。存储时需要加上偏移量(单精度偏移量为 127),故存储值为 3 + 127 = 130。130 的二进制为 10000010。
- M:1.0001 去掉整数部分的 1(隐藏位),存储 00010000...(补零至23位)。
最终二进制序列:0 10000010 00010000000000000000000。
第8步:特殊值处理
E 全为 0 或全为 1 时有特殊含义:
- E 全 0:表示非常接近 0 的小数(或非规约数),指数 E 视为 -126(而非127),且 M 不隐藏前导1。
- E 全 1:表示无穷大(Infinity)或 NaN(非数),取决于 M 是否全为 0。
第9步:整型与浮点型存储差异验证
通过指针类型转换,可以直观看到两者存储结构的巨大差异:
#include <stdio.h>
int main()
{
    int n = 9;
    float* pfloat = (float*)&n;

    printf("n的值为:%d\n", n);          // 9
    printf("*pfloat的值为:%f\n", *pfloat); // 0.000000 (误读)

    *pfloat = 9.0;
    printf("n的值为:%d\n", n);          // 1091567616 (被覆盖后的整数值)
    printf("*pfloat的值为:%f\n", *pfloat); // 9.000000
    return 0;
}
上述代码证明:整型 9 和浮点型 9.0 在内存中的二进制布局完全不同。用 float* 去解读 int 内存,得到的结果是错误的;反之,写入浮点数会彻底改变原来整数的内存位分布。
总结
C语言数据的存储涉及底层的二进制逻辑。整型依赖补码简化运算,需注意符号位和大小端的影响;浮点数依据 IEEE 754 标准,通过分离符号、指数和尾数来实现广泛的数量级表示。掌握这些原理是进行高级编程调试和优化内存管理的基础。
以上就是C语言中数据的存储的详细内容,更多关于C语言数据存储机制的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















