


一文读懂C语言大小端模式与字节序原理

C语言开发中常遇到大小端(Endianness)导致的数据解析错误。本文从位权与地址关系入手,图解大端与小端的内存存储差异,并通过代码示例展示如何判断当前系统的字节序,深入理解底层数据存取机制。
理解大小端的基础:位权与地址
要理解大小端,首先需要明确“位权”的概念。在多位数中,某一位上的数字所表示的数值大小取决于其位置,称为该位的位权。例如在十六进制数 0x010001 中,左边的 1 处于高位,权重为 2^7;右边的 1 处于低位,权重为 2^0。这就是典型的“位置化数字系统”,权值大的为高位,权值小的为低位。
在计算机内存中,数据以字节(Byte)为单位进行存储。如同数位有高低之分,内存地址也有“高地址”和“低地址”之分。不同的内存地址由二进制编号组成,编号较大的为高地址,编号较小的为低地址。
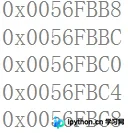
通过观察内存地址示意图可知,左侧对应较高的地址数值,右侧对应较低的地址数值。明确了高位/低位数据与高地址/低地址空间之间的映射关系,就能进一步推导大小端的定义。
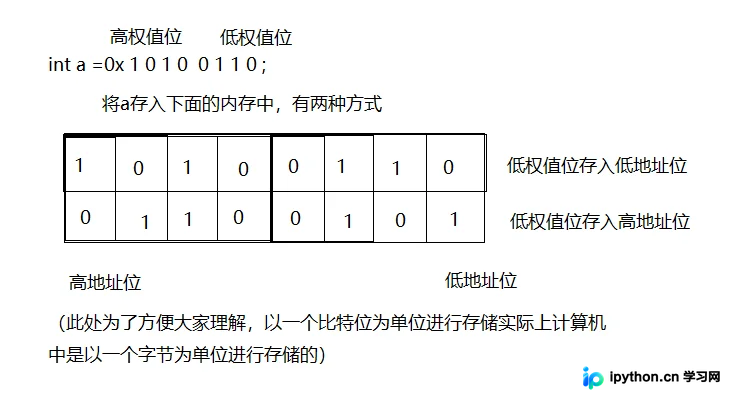
大小端本质上描述了多字节数据在内存中的两种不同存放顺序策略。
大小端的基本概念与存储形式
大端模式(Big-Endian)和小端模式(Little-Endian)的区别在于多字节数据的高低位存放在内存的高低地址上。
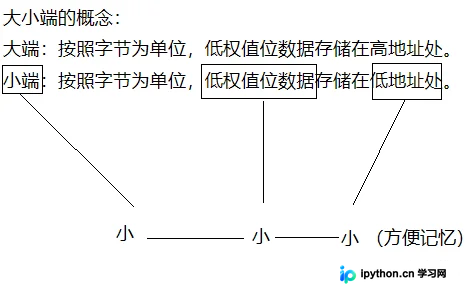
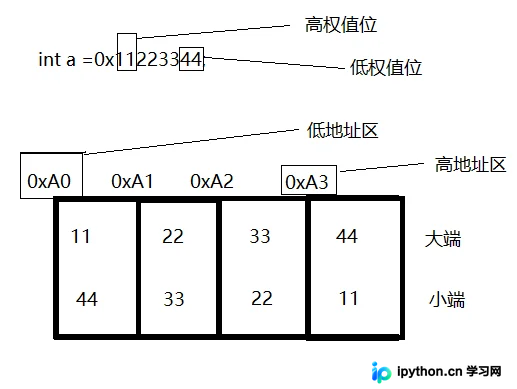
以上图为例,假设有一个四字节整数 0x12345678:
- 大端存储: 高字节(
0x12)存放在低地址,低字节(0x78)存放在高地址。符合人类阅读数字的习惯(从左到右,高位到低位)。 - 小端存储: 低字节(
0x78)存放在低地址,高字节(0x12)存放在高地址。这与Intel x86架构等常见处理器的默认存储方式一致。
大小端对数据存取的影响
大小端决定了数据和内存空间按照字节为单位的一种映像关系。这种关系在处理跨平台数据传输、网络协议解析或反汇编时至关重要。
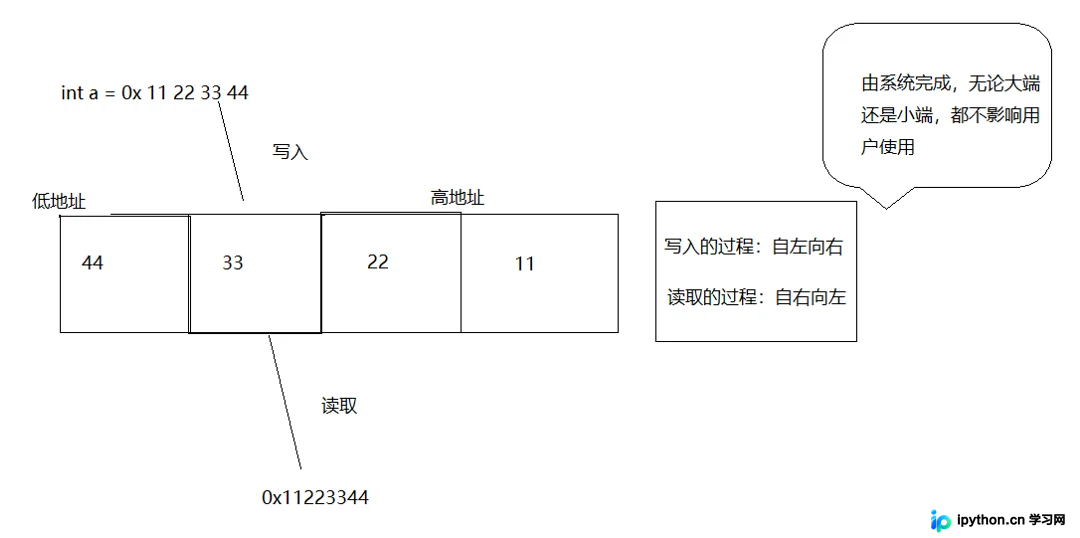
以小端存储为例,数据存入内存的过程类似于栈操作中的“压栈”。如果将一个双字(Double Word)写入内存,小端模式会先将最低有效字节(LSB)放入起始的低地址单元,随后依次填入更高位的字节。取出数据时则遵循相应的逆序或直接按地址累加读取。
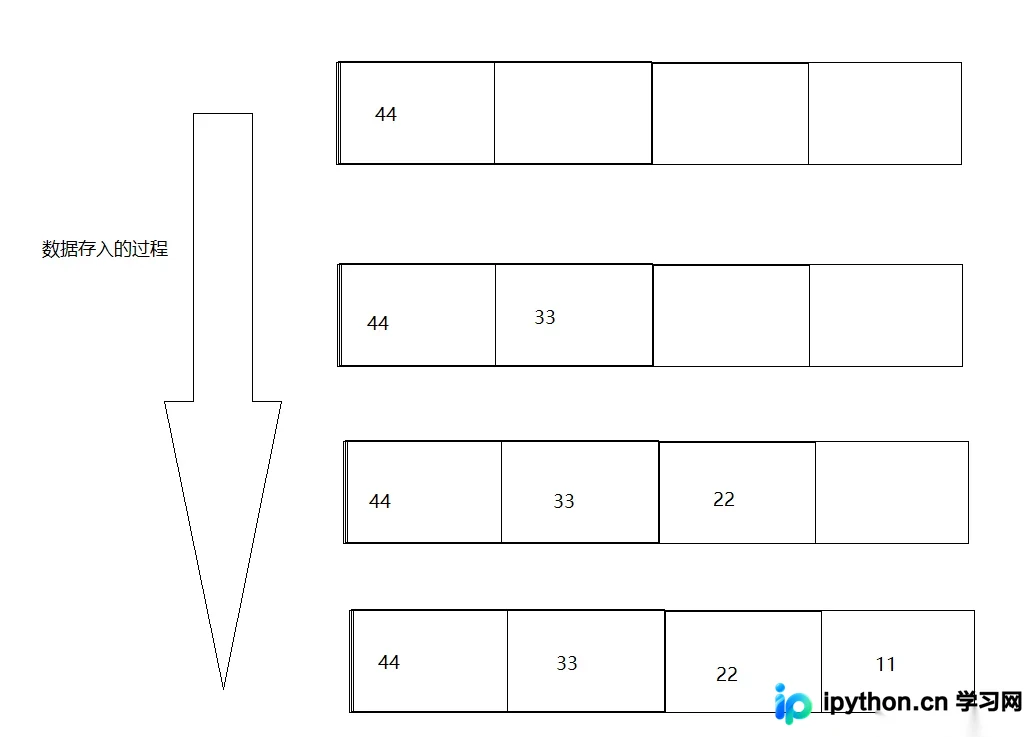
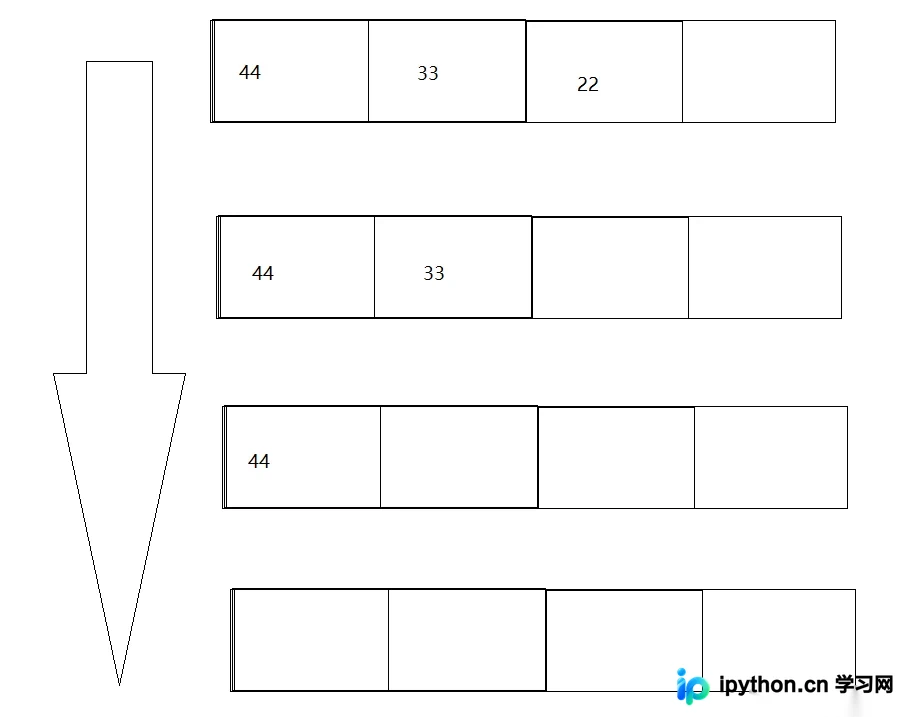
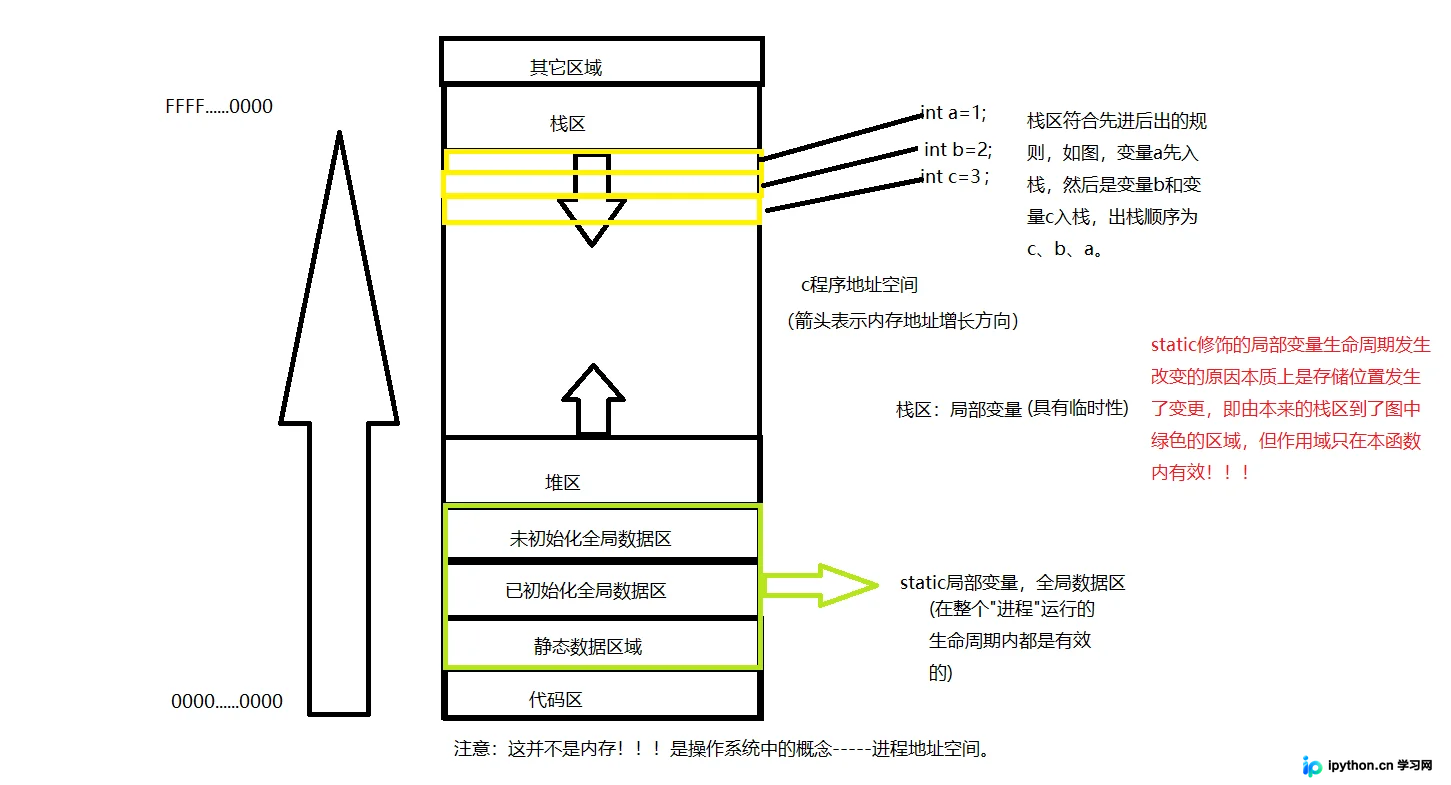
这种存与取的底层逻辑,与程序运行时的内存地址空间布局是一致的。即数据的压栈与出栈过程符合先进后出(LIFO)或特定的地址递增规律。理解这一点有助于分析缓冲区溢出、结构体对齐等底层问题。
总结
掌握大小端模式对于C/C++开发者理解底层内存布局、编写跨平台兼容代码以及调试二进制数据具有重要意义。在实际工程中,若涉及网络通信(通常使用大端/网络字节序),需特别注意主机字节序与网络字节序的转换。
以上就是C语言大小端问题原理与示例的详细内容,更多关于C语言底层存储机制的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















