


Go语言并发爬虫实战:从单线程到Goroutine的性能对比

在Web数据采集场景中,提升爬取速度是关键目标。Go语言凭借其内置的Goroutine和Channel机制,成为实现高并发爬虫的理想选择。本文将基于电子商城API演示三种Go爬虫实现:基础单线程、Channel同步以及sync.WaitGroup协程组控制,并通过实际耗时对比展示并发带来的性能显著提升。
1. 单线程爬虫实现
首先回顾基础的串行抓取逻辑。这种方式代码简单,但在面对大量URL时效率较低,因为必须等待前一次HTTP请求完全结束后才能发起下一次请求。
第1步:定义全局HTTP客户端
创建一个复用的http.Client实例,避免每次请求都重新建立TCP连接,这在并发场景下尤为重要。
var Client http.Client第2步:主函数循环触发请求
在主函数中,通过for循环依次调用爬虫函数。记录起始时间,并在所有任务完成后计算总耗时。这里模拟爬取第一页商品数据10次,作为基准测试。
func main() {
	url := "http://localhost:3000/api/v1/products"
	start := time.Now()
	// 串行执行10次请求
	for i := 0; i < 10; i++ {
		Spider(url, i)
	}
	elapsed := time.Since(start)
	fmt.Printf("Time %s", elapsed)
}
第3步:封装核心抓取逻辑
在Spider函数中构造GET请求,设置必要的Header(如模拟XHR请求),执行请求并解析JSON响应体。若遇到错误则直接终止程序。
func Spider(url string, i int) {
	req, err := http.NewRequest("GET", url, nil)
	if err != nil {
		log.Fatal(err)
	}
	req.Header.Set("accept", "*/*")
	req.Header.Set("x-requested-with", "XMLHttpRequest")

	resp, err := Client.Do(req)
	if err != nil {
		log.Fatal(err)
	}
	defer resp.Body.Close() // 建议补充关闭Body

	bodyText, _ := ioutil.ReadAll(resp.Body)
	var result Result
	_ = json.Unmarshal(bodyText, &result)
	fmt.Println(i, result.Data)
}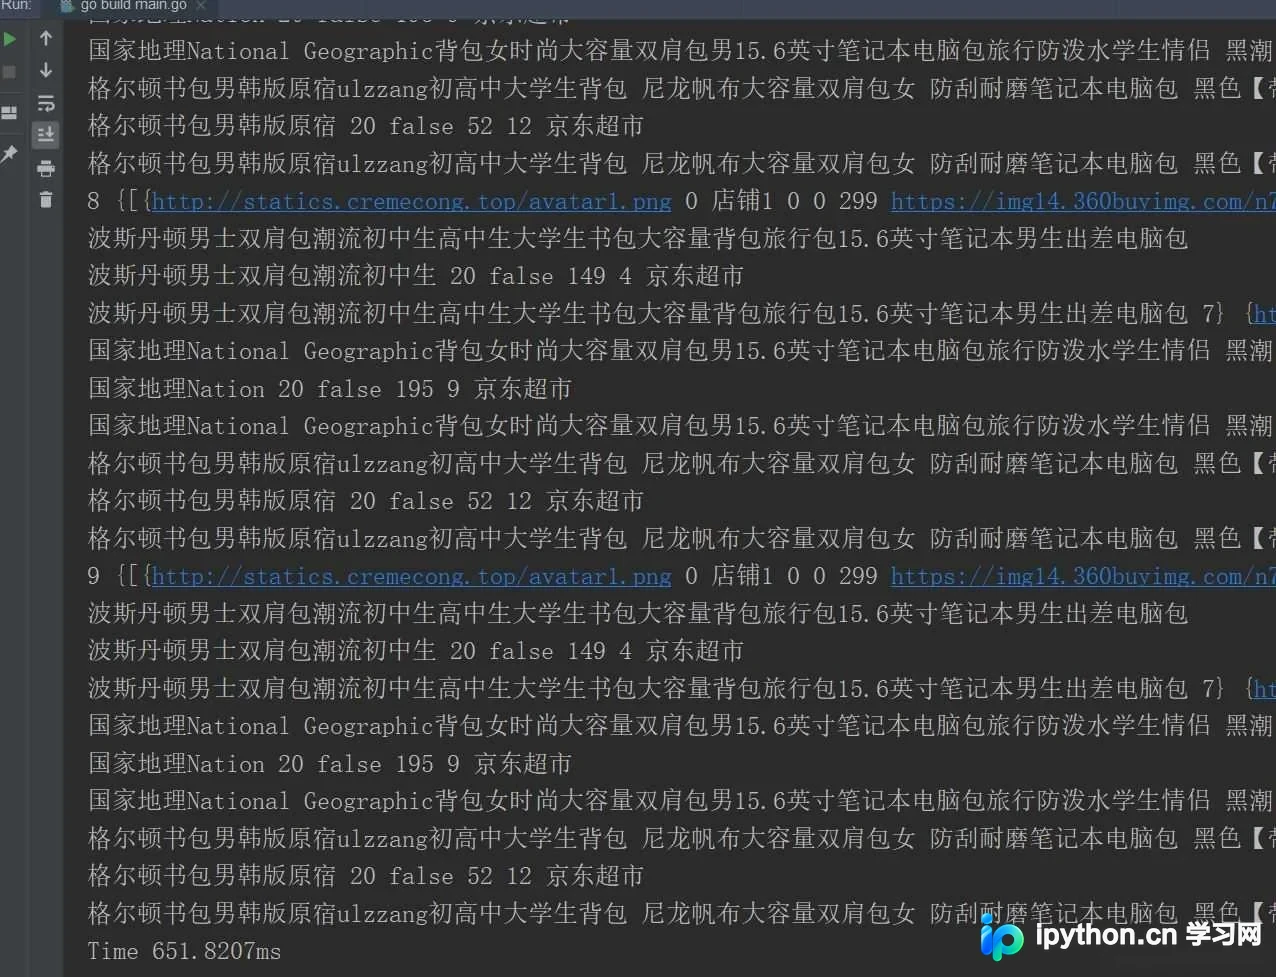
运行结果显示,单线程处理10次请求耗时约 651.8207ms。这主要受限于网络RTT(往返时间)及服务器处理延迟的累加。
2. 多线程(并发)爬虫实现
Go语言的核心优势在于轻量级协程。下面介绍两种常用的并发控制方案。
2.1 Channel阻塞主进程
利用无缓冲通道(Unbuffered Channel)的特性,主goroutine发送消息后会被阻塞,直到其他goroutine接收消息。这提供了一种简单的同步机制。
第4步:启动协程并等待完成
创建chan bool,在主循环中启动10个Spider协程。随后开启第二个循环,从channel接收10次信号,以此阻塞主线程直到所有子任务结束。
func main() {
	url := "http://localhost:3000/api/v1/products"
	ch := make(chan bool)
	start := time.Now()

	// 启动10个并发爬虫
	for i := 0; i < 10; i++ {
		go Spider(url, ch, i)
	}

	// 等待10个信号,确保所有goroutine执行完毕
	for i := 0; i < 10; i++ {
		<-ch
	}

	elapsed := time.Since(start)
	fmt.Printf("Time %s", elapsed)
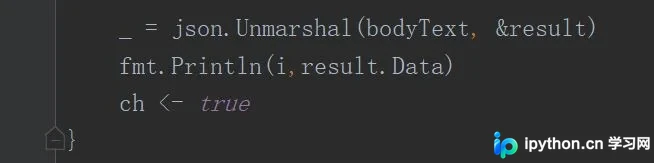
}注意:在Spider函数末尾需执行ch <- true来释放阻塞。
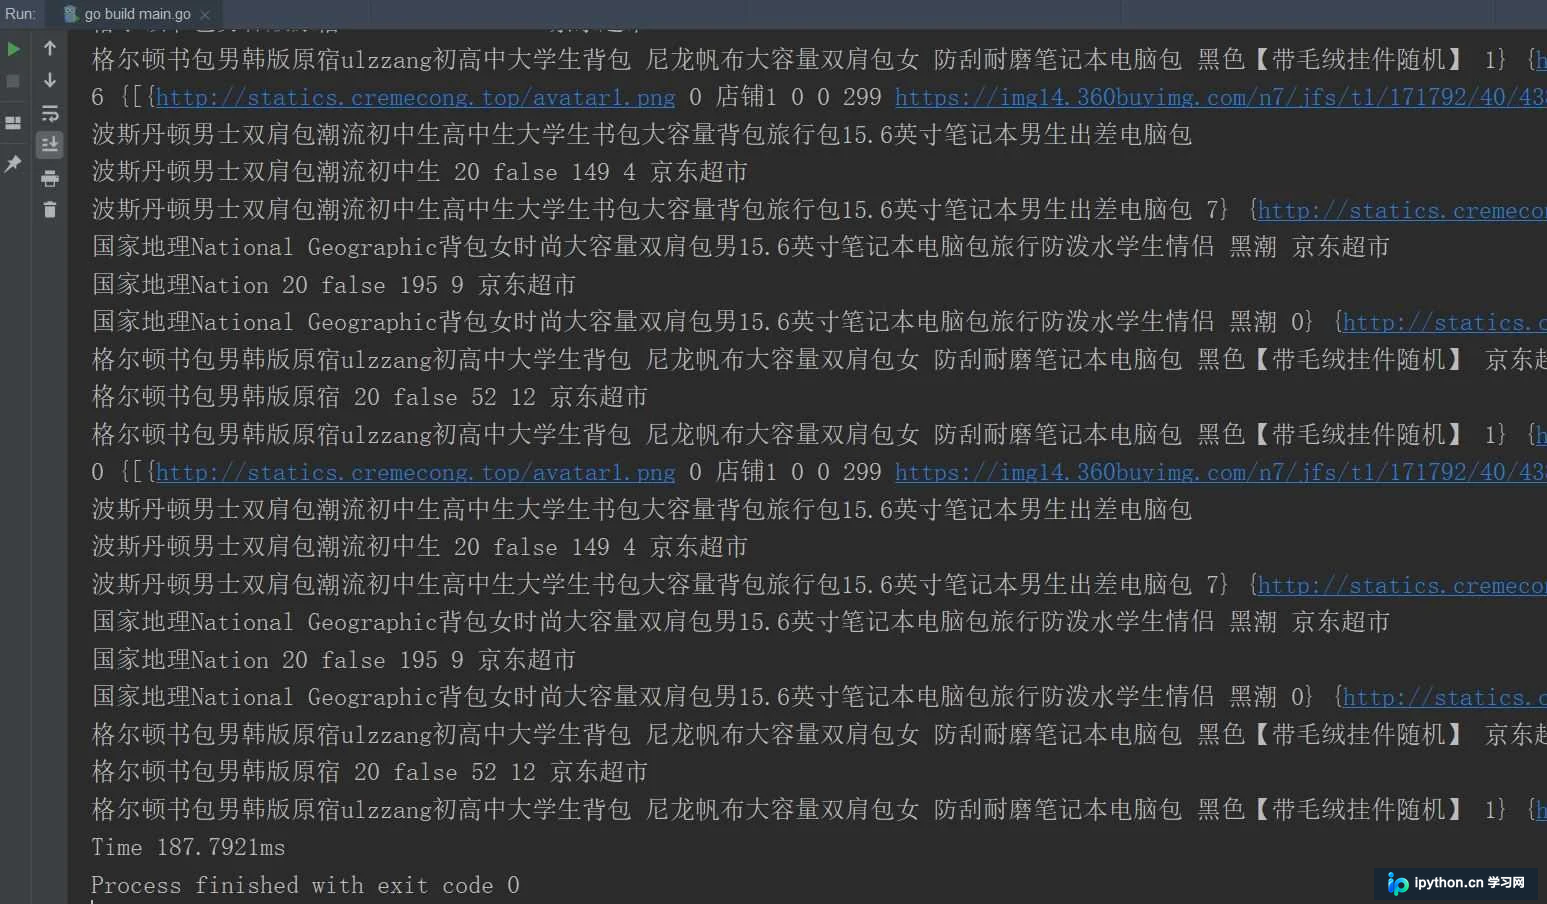
采用Channel方案后,耗时降至约 187.7921ms,相比单线程提升了近三倍,因为多个HTTP请求得以并行执行。
2.2 使用 sync.WaitGroup 控制
sync.WaitGroup是标准库提供的更直观的并发同步工具,它通过计数器管理一组 goroutine 的生命周期。
第5步:初始化 WaitGroup
调用Add(10)预设计数器为10,表示将启动10个任务。
var wg sync.WaitGroup
wg.Add(10)
第6步:执行协程并计数递减
在每个协程中使用defer wg.Done()确保任务结束时计数器减1。这种写法避免了遗漏信号导致的永久阻塞。
for i := 0; i < 10; i++ {
	go func(idx int) {
		defer wg.Done()
		SpiderWaitGroup(url, idx)
	}(i)
}
第7步:阻塞直至全部完成
调用wg.Wait(),当前协程将在此挂起,直到所有任务的计数器归零。
wg.Wait()结果:64.5246ms
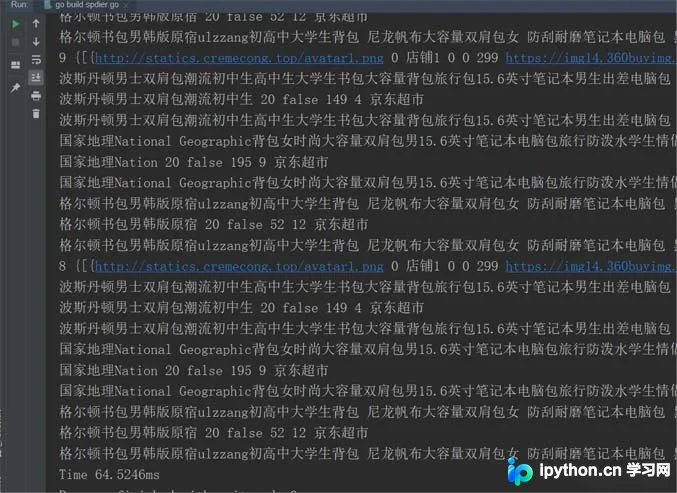
sync.WaitGroup方案表现最佳,仅需约 64ms。这是因为它能更精准地管理协程生命周期,且在实际高并发场景下比Channel方案更具扩展性。
3. 源码与总结
完整的示例代码已开源,包含了上述三种模式的完整实现及结构体定义:
- GitHub地址:
https://github.com/CocaineCong/Go-Spider-Demo
项目中提供了统一的入口调用:
NormalStart(url)      // 单线程
ChannelStart(url)     // Channel并发
WaitGroupStart(url)   // WaitGroup并发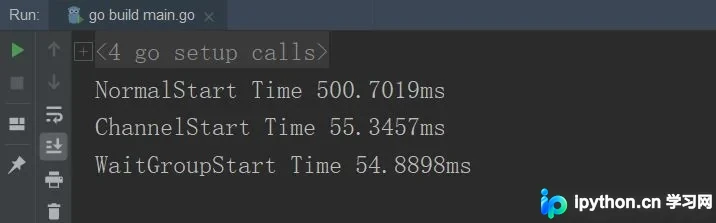
综上所述,在Go语言中进行爬虫开发时,应避免使用单线程串行模式。推荐使用sync.WaitGroup配合Goroutine来实现高效的数据采集,既保证了并发执行的效率,又确保了主程序的正确退出。需要注意的是,在生产环境中还需考虑限速、重试机制及反爬策略应对。
以上就是Go语言并发爬虫的具体实现教程,更多关于Go语言网络编程的内容请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















