


多线程编程避坑:C语言rand()线程锁与rand_r()性能优化详解

在使用C语言进行多线程程序开发时,全局随机数生成器rand()容易成为性能瓶颈。本文将分析为什么多线程运行反而比单线程更慢的“负优化”现象,解释其背后的互斥锁竞争机制,并提供利用rand_r()实现无锁、独立随机数生成的最佳实践方案。
背景:多线程蒙特卡洛模拟中的性能陷阱
在进行使用Pthreads并行化蒙特卡洛法估计π(圆周率)的实验时,一个常见的反直觉问题是:增加线程数量导致运行时间反而大幅增加。
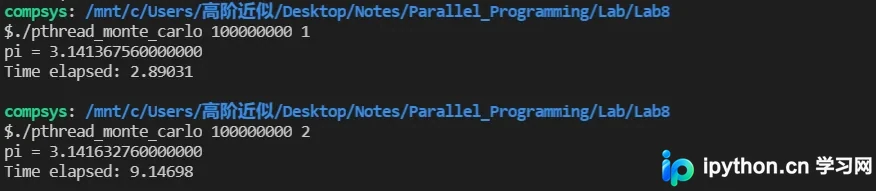
在实际测试中,使用单个线程耗时约 2.89031 秒,而使用两个线程时,耗时却激增至 9.14698 秒。这种性能倒退的核心原因在于:rand() 是线程不安全的标准库函数,在高频调用下导致了严重的线程竞争和阻塞。
long long total_times_in_cycle;
long long local_number_toss;
pthread_mutex_t times_in_cycle_mutex = PTHREAD_MUTEX_INITIALIZER;
void* do_Monte_Carlo_simulation(void* my_rank){
double offset = RAND_MAX / (double)2;
long long times_in_cycle = 0;
long long i;
// 核心问题点:此处频繁调用全局状态的 rand()
for(i = 0; i < local_number_toss; ++i){
double x = rand() / offset - 1;
double y = rand() / offset - 1;
if(x*x + y*y < 1){
times_in_cycle++;
}
}
pthread_mutex_lock(×_in_cycle_mutex);
total_times_in_cycle += times_in_cycle;
pthread_mutex_unlock(×_in_cycle_mutex);
}
核心差异:rand() 的临界段与 rand_r() 的解耦
第1步:深入理解 rand() 的全局状态竞争
rand() 函数的底层实现通常依赖一个全局静态变量来保存当前的种子(seed)。这意味着整个进程内所有的线程都在共享同一个随机数生成器实例。
当多个线程并发调用 rand() 时:
- 内部锁定:POSIX 标准要求
rand()必须是可重入或线程安全的,因此 libc 内部必须为这个全局状态加互斥锁(Mutex)。 - 高频竞争:蒙特卡洛算法需要产生海量随机点,每个循环体都会触发一次加锁、解锁操作。
- 性能损耗:由于锁竞争导致的上下文切换和时间片浪费,远远超过了并行计算带来的收益,从而导致“越并行越慢”的结果。
实验验证:为了证实所有线程共用了同一个种子流,可以通过以下简单代码测试:
#include#include #include int generate_rand_count; int thread_count; // 被线程执行的函数 void* thread_func(void* my_rank){ int i; int local_rand_count = generate_rand_count / thread_count; for(i = 0; i < local_rand_count; ++i){ printf("%d ", rand()); } } int main(int argc, char* argv[]){ pthread_t* all_threads_id; // 从命令行获取参数 generate_rand_count = strtol(argv[1], NULL, 10); thread_count = strtol(argv[2], NULL, 10); all_threads_id = malloc(sizeof(pthread_t) * thread_count); // 设置全局种子 srand(0); // 创建线程 int i; for(i = 0; i < thread_count; ++i){ pthread_create(&all_threads_id[i], NULL, thread_func, (void*) i); } // 等待完成 for(i = 0; i < thread_count; ++i){ pthread_join(all_threads_id[i], NULL); } printf("\n"); free(all_threads_id); return 0; }
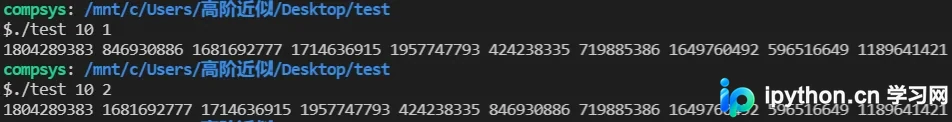
运行结果显示,无论是单线程还是双线程,输出的随机数序列完全一致。这证明了无论多少个线程同时运行,底层都在串行地消费同一个种子队列,并未发挥并行优势。
第2步:使用 rand_r() 实现无锁独立生成
为了解决上述竞态条件,应使用 POSIX 标准的 rand_r() 函数。该函数允许传入用户自定义的种子指针,从而实现每线程独立的随机数生成环境。
关键改进:将全局种子改为线程局部变量。
void* do_Monte_Carlo_simulation(void* my_rank){
// 为每个线程分配独立的种子
unsigned int local_seed = time(NULL) + my_rank;
double offset = RAND_MAX / (double)2;
long long times_in_cycle = 0;
long long i;
for(i = 0; i < local_number_toss; ++i){
// 传入独立种子指针,无全局锁竞争
double x = rand_r(&local_seed) / offset - 1;
double y = rand_r(&local_seed) / offset - 1;
if(x*x + y*y < 1){
times_in_cycle++;
}
}
// 仅对最终结果进行锁保护
pthread_mutex_lock(×_in_cycle_mutex);
total_times_in_cycle += times_in_cycle;
pthread_mutex_unlock(×_in_cycle_mutex);
}
注意初始化 local_seed 时建议加上线程ID偏移量,以避免不同线程在同一毫秒内获得完全相同的初始种子而导致相关性过高。
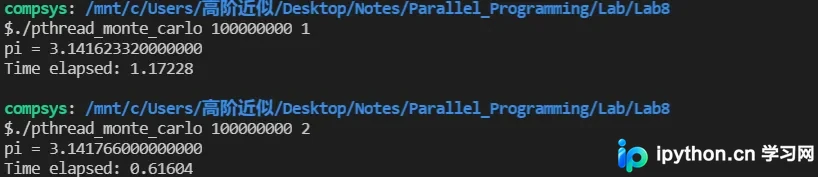
应用此方法后,程序恢复正常的并行加速效果,消除了因系统内置随机数生成器的锁争用造成的性能损失。
总结
在C/C++高性能并发编程中,切勿在热点循环中使用 rand()。虽然它简单好用,但在高并发场景下会演变为性能杀手。优先选用 rand_r() 绑定线程局部状态,或者使用 C++11 <random> 头文件提供的现代随机数设施,才是构建稳健并发系统的正确路径。
以上就是关于C语言rand()与rand_r()在多核性能优化方面的详细内容,更多关于多线程并发编程的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















