


SQL 查询连续 N 天登录用户:基于窗口函数与日期差值算法

在数据分析与用户行为研究中,识别连续活跃用户(如连续登录、连续下单)是衡量用户粘性的核心指标。由于关系型数据库中登录日志通常按天分布且可能存在间隔,直接使用 `BETWEEN` 或范围匹配无法高效处理任意天数的连续性。本文以 SQL 为例,讲解如何利用窗口函数 `ROW_NUMBER()` 与日期算术运算,构建一个通用解法来查找连续 N 天的用户。
核心逻辑解析
要判断“连续登录”,本质上是寻找序列中的等差数列。假设用户 ID 固定,每天获得一个递增的自然数排名(Rank),那么:
- 第 1 天的 Rank 为 1,
Date - 1 day - 第 2 天的 Rank 为 2,
Date - 2 days - 第 3 天的 Rank 为 3,
Date - 3 days
对于连续的时间序列,Date - Rank 的结果始终是一个固定的基准日期。一旦日期出现断层(如第 3 天缺失),下一行的结果将不再等于基准日期,从而实现自然分组。这种方法比自连接(Self-Join)性能更高,代码更简洁。
具体操作步骤
第一步:准备测试数据
为了演示效果,首先创建一个包含用户 ID (id)、登录日期 (date) 和订单量 (orders) 的表,并插入覆盖连续与非连续情况的数据。
create table if not exists orde(
  id varchar(10),
  date datetime,
  orders varchar(10)
);

insert into orde values('1' , '2019/1/1',10 );
insert into orde values('1' , '2019/1/2',109 );
insert into orde values('1' , '2019/1/3',150 );
insert into orde values('1' , '2019/1/4',99);
insert into orde values('1' , '2019/1/5',145);
insert into orde values('1' , '2019/1/6',1455);
insert into orde values('1' , '2019/1/7',199);
insert into orde values('1' , '2019/1/8',188 );
insert into orde values('4' , '2019/1/1',10 );
insert into orde values('2' , '2019/1/2',109 );
insert into orde values('3' , '2019/1/3',150 );
insert into orde values('4' , '2019/1/4',99);
insert into orde values('5' , '2019/1/5',145);
insert into orde values('6' , '2019/1/6',1455);
insert into orde values('7' , '2019/1/7',199);
insert into orde values('8' , '2019/1/8',188 );
insert into orde values('9' , '2019/1/1',10 );
insert into orde values('9' , '2019/1/2',109 );
insert into orde values('9' , '2019/1/3',150 );
insert into orde values('9' , '2019/1/4',99);
-- 此处中断,未登录 1/5
insert into orde values('9' , '2019/1/6',145);
-- 此处中断,未登录 1/7, 1/8, 1/9 -> 仅登录 1/10? 原文数据有点跳跃,这里保留原文数据结构作为参考
insert into orde values('9' , '2019/1/10',199);
-- 原文数据 1/13 也是断开的
insert into orde values('9' , '2019/1/13',188 );
执行后查看表结构及数据全貌,确保日期字段格式正确:
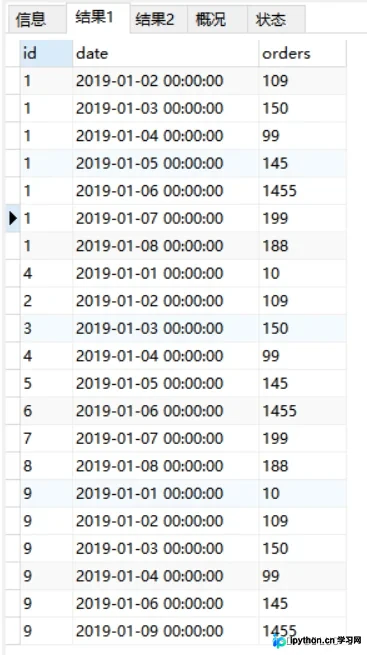
第二步:计算每日排名 (Row Number)
使用窗口函数 ROW_NUMBER() 为用户 ID 分区并按日期排序,生成唯一序号。此步骤目的是消除日期的实际数值干扰,建立相对顺序。
SELECT *,
  ROW_NUMBER() OVER(PARTITION BY id ORDER BY date) AS rank
FROM orde
WHERE orders IS NOT NULL;
观察结果,同一用户的每一天都有对应的序数,非当日登录的行被忽略:
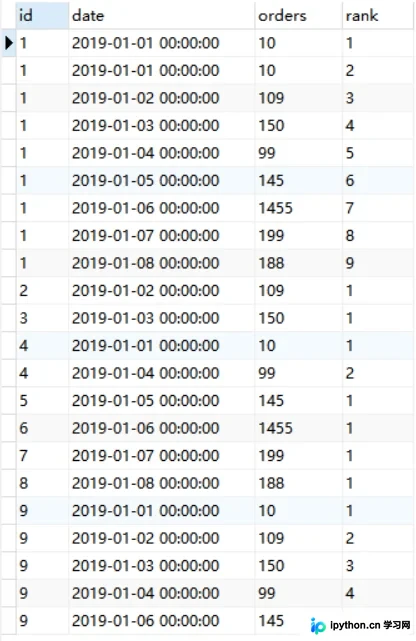
第三步:推导连续基准日期
这是最关键的一步。在 MySQL 中,可以使用 DATE_SUB(date, INTERVAL rank DAY)。对于连续的用户 A:
- Rank 1, Date 2019-01-01 → Base: 2018-12-31
- Rank 2, Date 2019-01-02 → Base: 2018-12-31
- Rank 3, Date 2019-01-03 → Base: 2018-12-31
只要日期是连续的,计算出的基准日期就完全一致。如果是跨月或跨年,数学逻辑依然成立。嵌套子查询实现如下:
SELECT a.*,
  DATE_SUB(a.date, INTERVAL a.rank DAY) AS date_sub
FROM (
    SELECT id, date, orders,
           ROW_NUMBER() OVER(PARTITION BY id ORDER BY date) AS rank
    FROM orde
    WHERE orders IS NOT NULL
) a;
输出结果中可以看到,连续登录的记录其 date_sub 列的值相同:
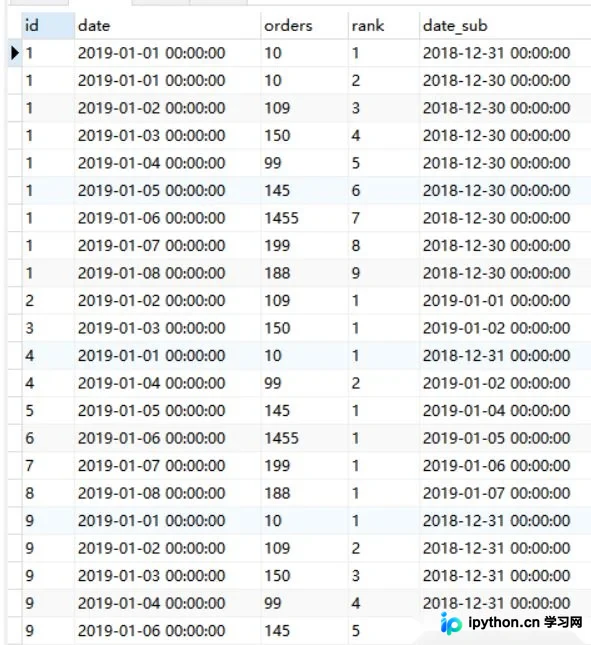
第四步:分组聚合并过滤连续 N 天
最后,根据 id 和计算出的 date_sub 进行分组统计。设置 HAVING COUNT(*) >= N 即可筛选出目标用户,同时使用 MIN() 和 MAX() 获取该连续周期的开始和结束时间。在此以连续 3 天为例:
SELECT b.id,
       MIN(b.date) AS start_time,
       MAX(b.date) AS end_time,
       COUNT(*) AS date_count
FROM (
    SELECT a.*,
           DATE_SUB(a.date, INTERVAL a.rank DAY) AS date_sub
    FROM (
        SELECT id, date, orders,
               ROW_NUMBER() OVER(PARTITION BY id ORDER BY date) AS rank
        FROM orde
        WHERE orders IS NOT NULL
    ) a
) b
GROUP BY b.date_sub, b.id
HAVING COUNT(*) >= 3;
最终查询结果显示了所有达到至少 3 天连续登录标准的用户及其具体的登录时间段:
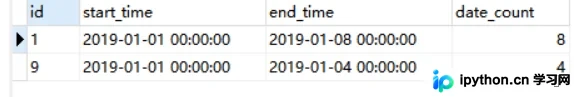
排错与注意事项
- 日期去重:如果同一天有多个操作(多次登录或下单),直接排序会产生多条 Rank 行。建议在对
date排序前先对日期字段去重(`DISTINCT date`),或使用DENSE_RANK()代替ROW_NUMBER(),并在后续逻辑中调整。 - 时区问题:如果使用
DATETIME类型,需确保系统时区与应用期望的业务日期一致。推荐使用DATE类型仅存储年月日以避免午夜时间的边界模糊。 - N 的动态化:在实际业务中,连续天数通常是配置项。只需修改
HAVING COUNT(*) >?中的数值即可适配不同标准(如 7 天、30 天)。
以上就是 SQL 查询连续 N 天登录用户情况的详细内容,更多关于 SQL 高级查询技巧的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















