


深入理解C语言数组下标为何从0开始:底层寻址机制解析

在学习编程语言时,我们常发现数组下标习惯从0开始,这与我们日常生活中“第1个”的习惯不符。对于C语言而言,这一设计的核心驱动力并非为了与众不同,而是为了在计算机底层实现最高效的内存寻址。通过分析汇编代码可知,0起始的下标允许直接将索引作为偏移量,避免了每次访问元素时额外的减法指令,从而降低了CPU开销并提升了整体执行效率。
结果或目标
C语言的数组操作之所以从下标 0 开始,主要是因为在硬件层面和汇编指令中,基于基址加偏移量的寻址模式(Base + Index * Size)无需任何预处理即可直接计算内存地址。如果采用从 1 开始的下标,编译器必须在计算地址前执行减法操作(将下标减 1),这在循环密集型操作中会累积大量的 CPU 周期。
准备条件
- 开发环境: Visual Studio 及支持反汇编功能的调试器。
- 源程序逻辑: 一个包含全局整型数组
int arr[5]且循环为其赋值的 C 语言程序。 - 观察重点: 关注编译后的机器码与汇编指令,特别是内存赋值指令中的地址偏移计算部分。
第1步:编写测试程序并开启反汇编
首先创建一个简单的 C 语言控制台应用,定义一个全局数组并在主函数中进行初始化循环。在 Visual Studio 中调试运行该程序,并查看反汇编窗口以获取底层指令详情。
int arr[5]; // 一个全局数组

int main()
{
    int i;
    for (i = 0; i < 5; i++)
        arr[i] = 9;
    return 0;
}
第2步:分析数组元素的内存寻址方式
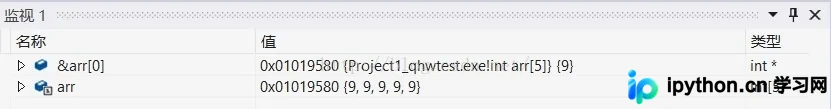
在生成的汇编代码中,找到对应 arr[i] = 9; 的关键指令。通过分析可以看到一条核心汇编指令:mov dword ptr [eax*4+01019580h], 9。这条指令的运作机制揭示了底层物理寻址的逻辑:
01019580h:这是全局数组arr的内存首地址(可以通过监视窗口输入&arr[0]验证)。eax:寄存器变量,存放循环当前的索引值i。*4:表示每个int类型元素占 4 个字节。
这表明,CPU 在定位第 i 个元素时,计算公式简化为:当前地址 = 首地址 + i * 4。由于下标 i 从 0 开始,当 i=0 时,偏移量为 0,直接指向首地址,计算过程极为纯粹。
第3步:验证内存中的数据布局
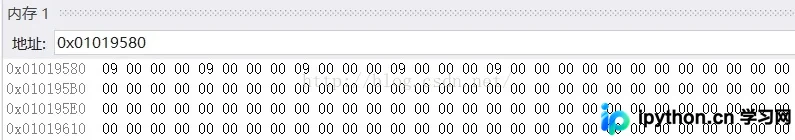
运行完整的 for 循环后,我们可以观察到内存中地址 0x01019580 处的变化。系统向以该地址为首的连续 20 个字节(5个元素 * 4字节/元素)写入了数值 9。具体分布情况如下:
0x01019580:第 0 个元素(arr[0])0x01019584:第 1 个元素(arr[1])...:以此类推
这种线性的、无差额的物理排布,完全得益于从 0 开始的索引设计。
第4步:对比从 1 开始下标的计算成本
如果我们强行要求下标从 1 开始(类似早期的 Pascal 语言),那么 CPU 在计算第 i 个元素的物理地址时,公式必须变为:当前地址 = 首地址 + (i - 1) * 4。
这意味着在每一次循环迭代中,都必须先进行一步减法运算(sub i, 1),然后再乘以元素大小。虽然现代 CPU 具备强大的流水线技术,能在极短时间内完成加法,但在高频循环或处理大规模数据时,这种多余的算术步骤依然会造成可测量的资源浪费。C 语言的设计哲学极度重视性能与底层控制,因此舍弃了符合人类直觉的“从1开始”,选择了更契合底层硬件逻辑的“从0开始”。
简要总结
综上所述,C语言数组下标从0开始是一种经过深思熟虑的工程取舍。它利用了内存基址寻址的天然属性,将索引值直接转化为字节偏移量,省去了必要的减一修正步骤。这种细微的设计差异,正是C语言能够保持极致运行效率的重要基石之一。
以上就是C语言数组元素下标为何从0开始的详细内容,更多关于C语言数组设计与底层原理的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















