


Python多线程安全实战:用线程锁解决并发转账的数据竞争问题

在Python并发编程中,多个线程同时读写同一个全局变量是引发数据错乱的高发区。本文以银行账户模拟为例,展示高频并发转账时如何因上下文切换导致余额计算失败,并给出基于 threading.Lock 的标准修复方案,确保共享变量在任意并发规模下保持绝对一致。
场景演示:多线程并发修改共享余额
假设系统内有一个初始余额为 100 的账户,后台持续生成随机的转入与转出任务。当单次操作极其简单时,线程切换可能暂时掩盖竞态条件;但一旦业务逻辑变得复杂或耗时增加,并发执行产生的覆盖写入就会立即暴露,造成最终结果偏离预期。
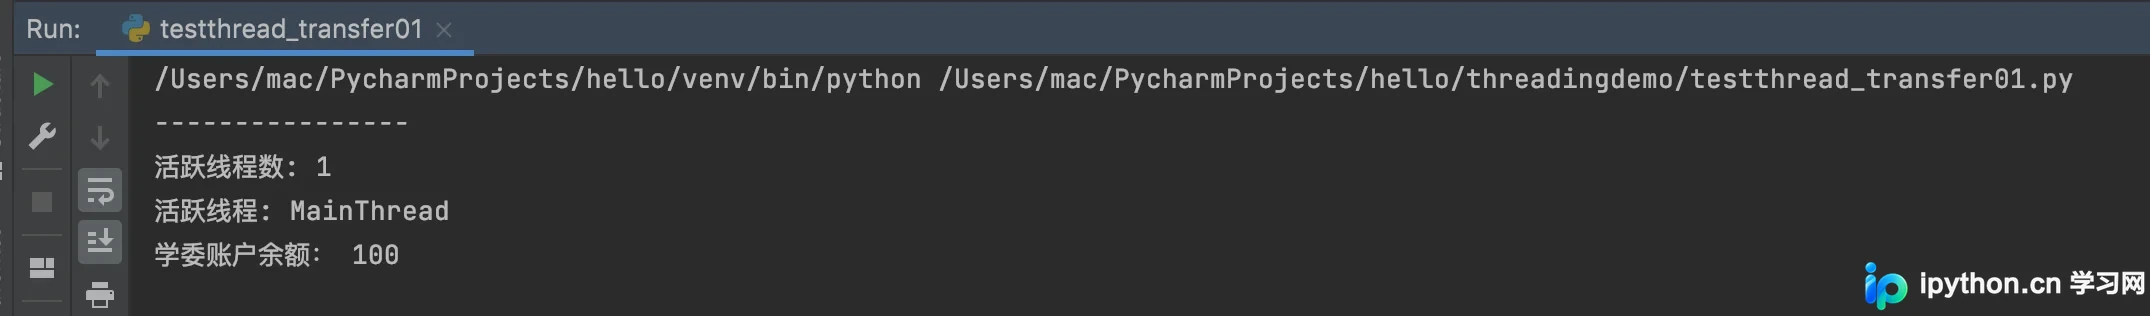
第1步:初始化账户与基础转账逻辑
定义全局余额变量与基础转账函数。函数接收 money 参数(负数代表转出),直接对全局账户执行累加。
import threading
import time

xuewei_account = 100

def transfer(money):
    global xuewei_account
    xuewei_account += money
第2步:模拟高频并发转账并观察异常
启动四组线程任务,将循环放大至 10 次,并在每次调用中执行 10 万次累加操作,人为拉长单次任务的占用时间,从而大幅抬高上下文切换概率。
# 启动测试线程
for i in range(10):
    threading.Thread(target=lambda: transfer(-1)).start()
    threading.Thread(target=lambda: transfer(1)).start()
    threading.Thread(target=lambda: transfer(-1)).start()
    threading.Thread(target=lambda: transfer(1)).start()

time.sleep(10)
print(f"活跃线程数: {threading.active_count()}")
print(f"学委账户余额:{xuewei_account}")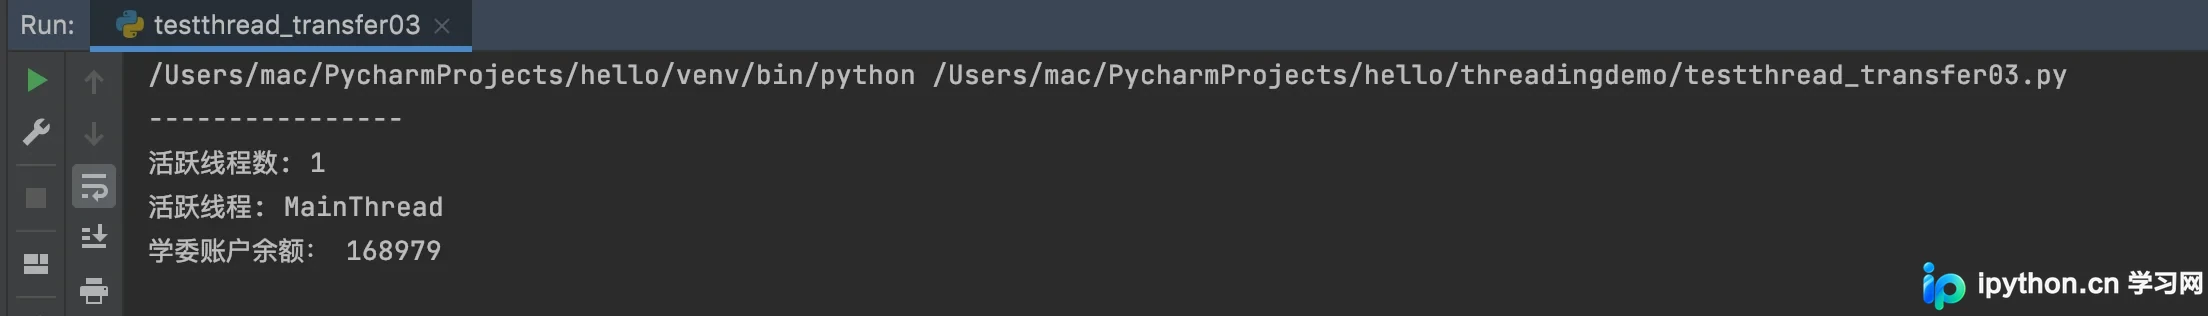
运行结果显示余额不再保持 100。多个线程在无协调机制的情况下,同时读取到相同的旧值,各自计算后覆盖写入,产生典型的数据竞争(Race Condition)。这正是并发编程容易出 bug 的核心原因。
修复方案:使用线程锁保障数据一致
解决此类共享变量并发访问问题的标准做法是引入互斥锁。通过 threading.Lock,可以强制同一时刻仅允许一个线程进入关键代码段。
第3步:引入 threading.Lock 实现互斥访问
在累加操作开始前申请锁,完成后立即释放。为确保即使业务代码抛出异常也不会导致锁永久悬挂,推荐使用 try...finally 结构规范生命周期管理。
import threading
import time

xuewei_account = 100
lock = threading.Lock()

def transfer(money):
    global xuewei_account
    lock.acquire()
    try:
        for _ in range(100000):
            xuewei_account += money
    finally:
        lock.release()

# 启动测试线程
for i in range(10):
    threading.Thread(target=lambda: transfer(-1)).start()
    threading.Thread(target=lambda: transfer(1)).start()
    threading.Thread(target=lambda: transfer(-1)).start()
    threading.Thread(target=lambda: transfer(1)).start()

time.sleep(10)
print(f"活跃线程数: {threading.active_count()}")
print(f"学委账户余额:{xuewei_account}")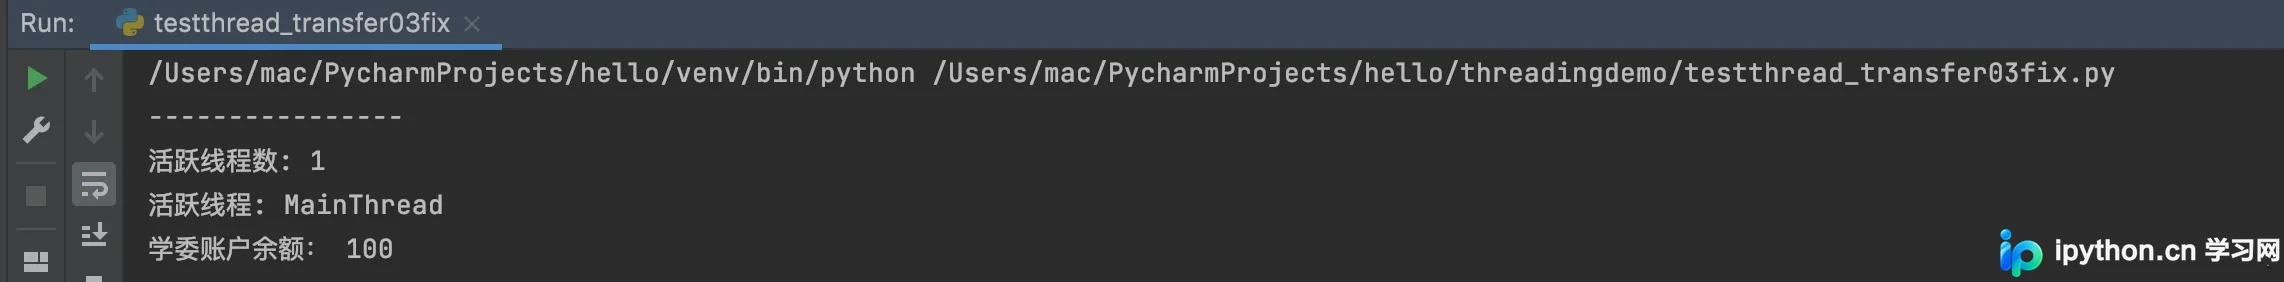
加上锁之后,任何时刻转账函数内部的累加逻辑都只会被单一线程独占调用。程序再次运行无论多少次,最终余额都会稳定在初始设定的 100,彻底消除了共享变量读写冲突。
开发注意事项与总结
- 精准控制临界区: 仅对包含共享状态修改的语句块加锁。过度扩大的锁范围会退化为串行执行,丧失并发优势。
- 异常安全释放: 始终使用
try...finally或with lock:上下文管理器替代裸调用.acquire()/.release(),避免突发崩溃导致系统死锁。 - 适用边界: 本地部署脚本、数据采集聚合、轻量级异步接口等场景中,只要涉及非原子性的全局变量读写,就必须评估线程同步策略。
以上就是 Python 线程同步机制在实际场景中解决数据竞争问题的详细内容,更多关于 Python 多线程并发编程与线程锁安全使用的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















