


C++归并排序算法原理解析与代码实现

发布时间:2026-10-16 |
4人浏览过
归并排序是一种基于分治思想的经典排序算法,其平均时间复杂度稳定在O(nlogn)。本文将深入剖析其拆分与合并机制,并提供标准的C++代码实现,帮助您彻底理解该算法的核心逻辑。
归并排序核心原理
归并排序(Merge Sort)的核心在于“分治法”(Divide and Conquer)。它不直接在原序列上进行大规模交换,而是采取以下两个阶段:
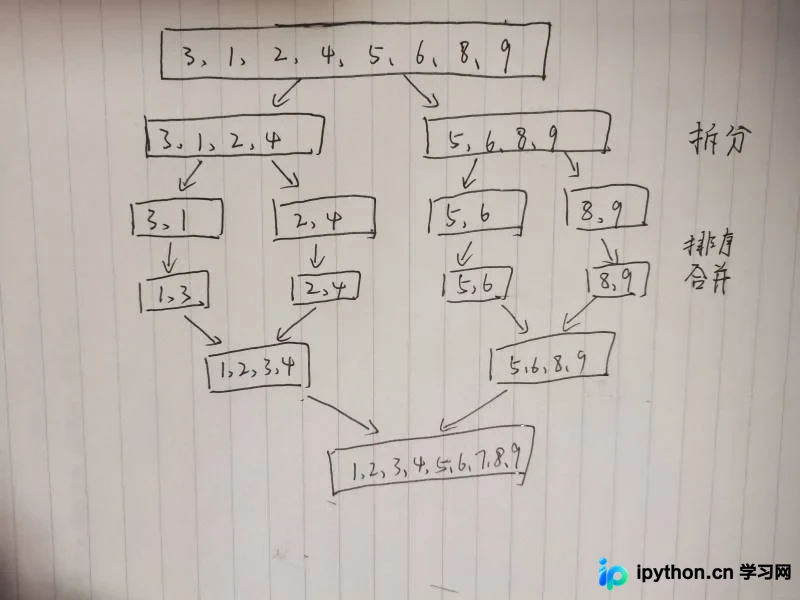
- 拆分(Split):将待排序列不断对半分割,直到每个子序列仅包含一个元素。单个元素的序列天然有序。
- 合并(Merge):从最小单元开始,两两合并相邻的有序序列。在合并过程中进行比较和重排,确保合并后的新序列依然有序。重复此过程,直至所有元素合并为一个完全有序的序列。
这种自底向上的合并过程保证了算法的时间复杂度始终维持在 O(nlogn),无论初始数据是否有序。其直观流程如下图所示:
C++ 代码实现与分析
下面是完整的 C++ 实现代码。程序通过递归调用 Merge_Sort 进行拆分,利用 Merge 函数执行具体的合并操作。为了优化性能,通常使用辅助数组 tmp 来暂存合并结果,避免频繁的内存分配。
//时间复杂度是nlogn
#include <iostream>

using namespace std;

void Merge(int a[],int s,int mid,int e,int tmp[]);//归并
void Merge_Sort(int a[],int s,int e,int tmp[]);//有序

int main(){
    int a[1000],tmp[1000];
    int n;
    cin >> n;
    for(int i=0;i<n;i++)cin >> a[i];
    Merge_Sort(a,0,n-1,tmp);//对数组进行排序
    for(int i=0;i<n;i++)cout << a[i] << " ";
    system("pause");
    return 0;
}

void Merge_Sort(int a[],int s,int e,int tmp[]){
    if(s<e){
        int m=(s+e)/2;
        Merge_Sort(a,s,m,tmp);//左边有序
        Merge_Sort(a,m+1,e,tmp);//右边有序
        Merge(a,s,m,e,tmp);//归并
    }
}

void Merge(int a[],int s,int mid,int e,int tmp[]){
    int p1,p2,p=0;
    p1=s,p2=mid+1;
    //判断大小,得到排列顺序
    while(p1<=mid&&p2<=e){
        if(a[p1]<a[p2]){
            tmp[p++]=a[p1++];
        }
        else{
            tmp[p++]=a[p2++];
        }
    }
    //剩余数据自动放到末尾
    while(p1<=mid){
        tmp[p++]=a[p1++];
    }
    while(p2<=e){
        tmp[p++]=a[p2++];
    }
    //将tmp中排好序的数组拷贝到a中
    for(int i=0;i<e-s+1;++i){
        a[s+i]=tmp[i];
    }
}
关键函数逻辑说明
1. Merge_Sort 递归拆分
该函数是递归的主体。首先检查区间 s 到 e 是否有效(即 s < e)。如果有效,计算中间点 m = (s + e) / 2。接着递归调用自身分别处理左半部分 [s, m] 和右半部分 [m+1, e]。当递归到达最底层(单元素)时,开始回溯并执行合并操作。
2. Merge 有序合并
这是归并排序的核心步骤,负责将两个已排序的子数组 [s, mid] 和 [mid+1, e] 合并到一个临时数组 tmp 中:
- 双指针比较:初始化指针
p1指向左半部分起始位置s,p2指向右半部分起始位置mid + 1。循环比较a[p1]和a[p2],将较小的值放入tmp[p],并移动对应指针。 - 处理剩余元素:当其中一个子数组遍历完毕后,另一个子数组中剩余的元素必然是最大的,直接依次复制到
tmp末尾。 - 写回原数组:最后,将
tmp中整理好的数据拷贝回原数组a的[s, e]区间,完成当前层级的合并。
通过以上步骤,归并排序能够高效且稳定地对任意规模的数据进行排序。以上就是C++归并排序算法详解的详细内容,更多关于C++基础算法的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















