


Go 语言内存对齐原理、边界计算与结构体优化

在 Go 语言开发中,理解内存对齐不仅有助于掌握底层运行机制,更是优化结构体(Struct)内存占用的关键手段。本文从 CPU 读取机制和平台限制出发,解释为何需要内存对齐,并详细介绍如何确定各类数据的对齐边界。同时,通过具体代码示例展示如何利用 unsafe 包计算对齐值,并通过重新排列结构体成员顺序,显著降低内存消耗。
什么是内存对齐及其必要性
内存对齐是编译器为了提升程序运行效率和维护硬件兼容性,自动将数据安排到特定地址的一种机制。其核心规则在于:数据存储的起始地址以及数据类型占用的字节数,必须是对齐边界的整数倍。
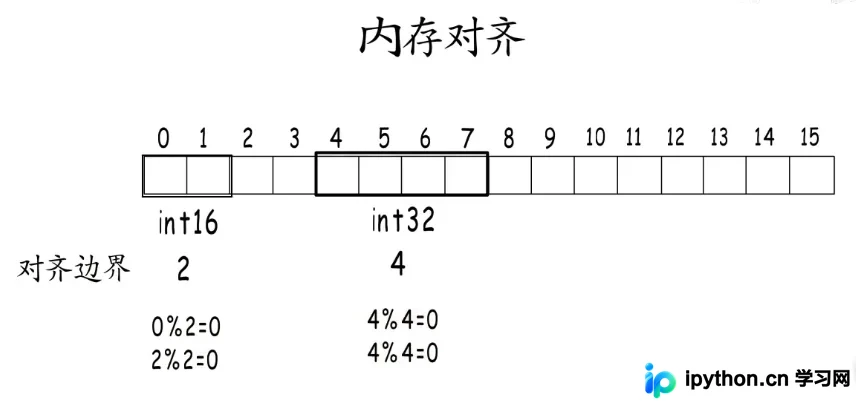
CPU 访问内存通常是以“块”为单位进行的,块的粒度可以是 2、4、8 或 16 字节等。若未进行内存对齐,CPU 在读取跨越边界的数据时,可能需要多次访问内存并进行拼接,这会直接导致性能下降。
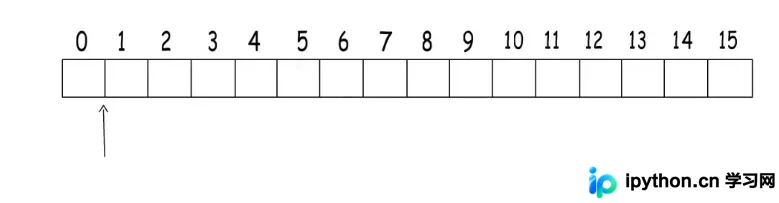
例如,当尝试从非对齐地址读取 8 字节数据时,CPU 可能需要进行两次内存读取操作,这不仅增加了时钟周期消耗,也违背了 CPU 快速读取数据的初衷。
实现内存对齐主要基于以下两个原因:
- 平台移植性(硬件限制):部分硬件平台仅支持在特定的自然边界地址上访问特定大小的数据,否则将触发硬件异常。为了保证代码在不同架构上的可移植性,必须进行对齐。
- 访问性能:对数据结构(尤其是栈空间)在自然边界上进行对齐,能够确保处理器仅需一次内存访问即可完成读写。若数据未对齐,处理器可能需要执行两次访问,从而产生性能损耗。
如何确定数据的对齐边界
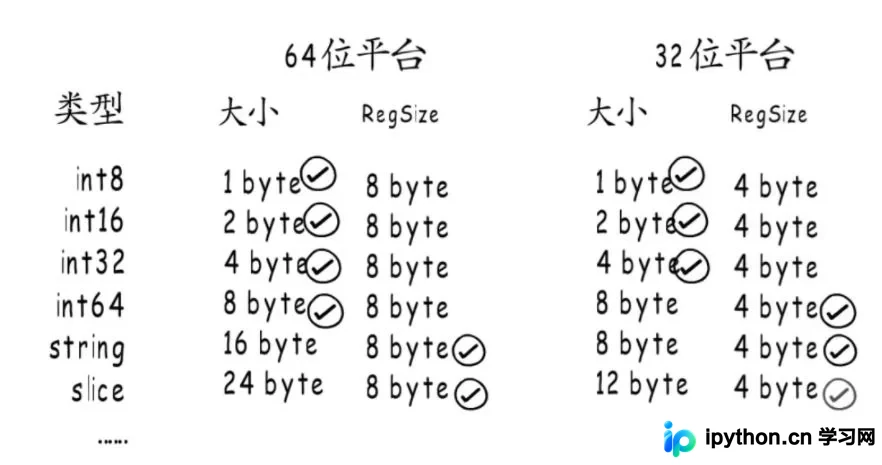
数据类型的具体对齐边界与运行平台的架构(32位或64位)密切相关。在 Go 语言中,这一标准由平台的寄存器宽度(即机器字长)决定。
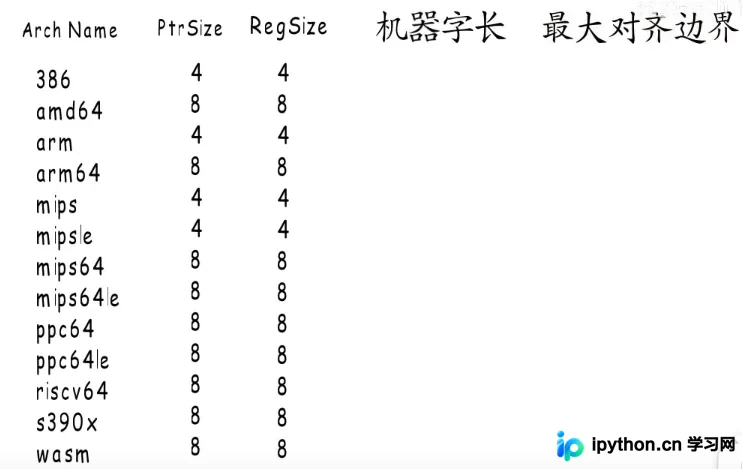
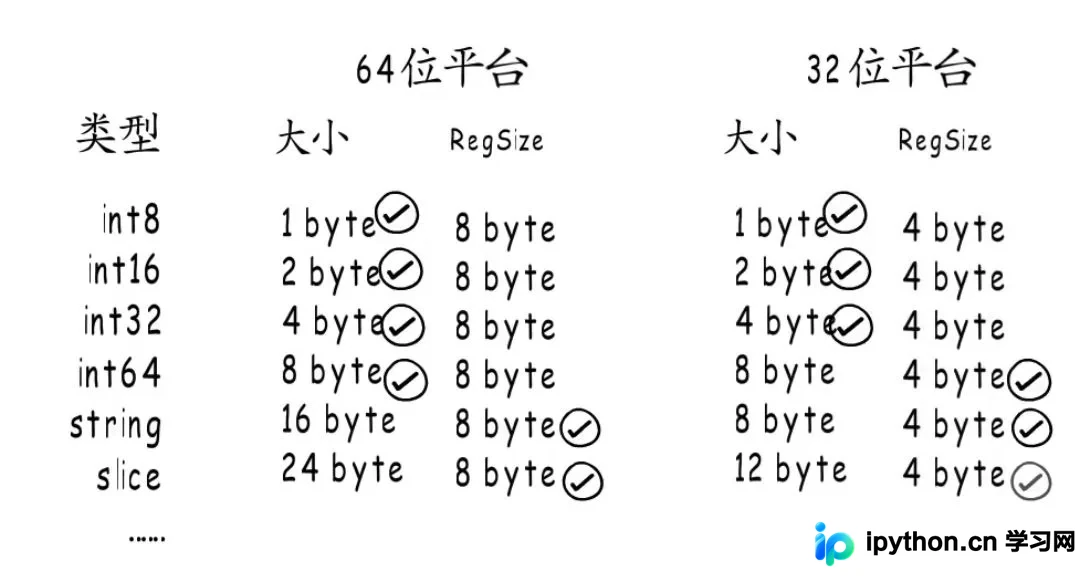
一般情况下,一个数据类型的实际对齐边界取值遵循以下原则:取该类型自身的大小(Size)与平台最大对齐边界(Machine Word Size)中的较小值。
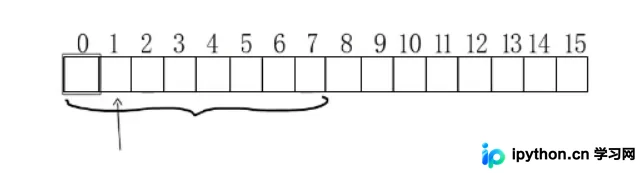
以整型为例进行分析:假设当前为 64 位平台,最大对齐边界为 8 字节。
- int8 (1字节):按自身大小 1 字节对齐即可。因为无论放在哪个位置,CPU 都能在单次访问中提取这 1 个字节。若强行按 8 字节对齐,每个 int8 变量都会浪费 7 个字节的内存空间(如图所示)。所以
align = min(1, 8) = 1。
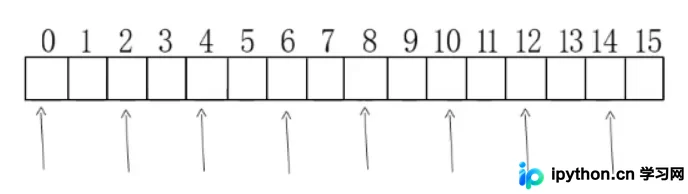
- int16 (2字节):同理,只需要 2 字节对齐就能保证单次完整读取。如果按 1 字节对齐,跨边界存储时需分两次读取;如果按 8 字节对齐则会严重浪费空间。因此
align = min(2, 8) = 2。
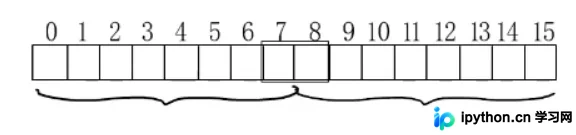
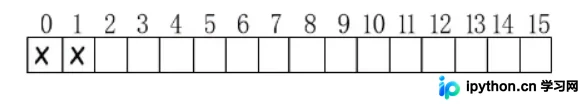
对于大于机器字长的情况,如 32 位平台下的 int64(8 字节),由于平台最大对齐边界仅为 4 字节,此时它只能按 4 字节对齐。这意味着虽然保证了相对高效的访问,但在寻找连续存放地址时,可能会受到更多限制。
查看基本类型的对齐方式
在 Go 语言的 unsafe 包中,提供了 Alignof 函数用于返回指定类型的对齐边界值。我们可以通过简单的测试代码直观地查看不同基本类型的对齐要求。
package main

import (
	"fmt"
	"unsafe"
)

func main() {
	// bool 类型,大小为 1 字节
	fmt.Printf("bool align: %d\n", unsafe.Alignof(bool(true)))
	// int32 类型,通常在 32/64位平台下均对齐至 4 字节
	fmt.Printf("int32 align: %d\n", unsafe.Alignof(int32(0)))
	// int64 类型,在 64 位平台下对齐至 8 字节
	fmt.Printf("int64 align: %d\n", unsafe.Alignof(int64(0)))
	// 字符串类型,包含指针等元数据,通常为 8 字节
	fmt.Printf("string align: %d\n", unsafe.Alignof("EDDYCJY"))
	// Map 也是复杂的复合类型,通常跟随指针宽度
	fmt.Printf("map align: %d\n", unsafe.Alignof(map[string]string{}))
}
上述代码在 64 位 Linux/MacOS 环境下的输出结果如下:
bool align: 1
int32 align: 4
int64 align: 8
string align: 8
map align: 8
结构体(Struct)的对齐规则
结构体的内存布局是 Go 开发中容易踩坑的地方。确定一个结构体占用的总内存大小和对齐方式,需遵循两步核心逻辑。
第一步:确定结构体自身的对齐边界
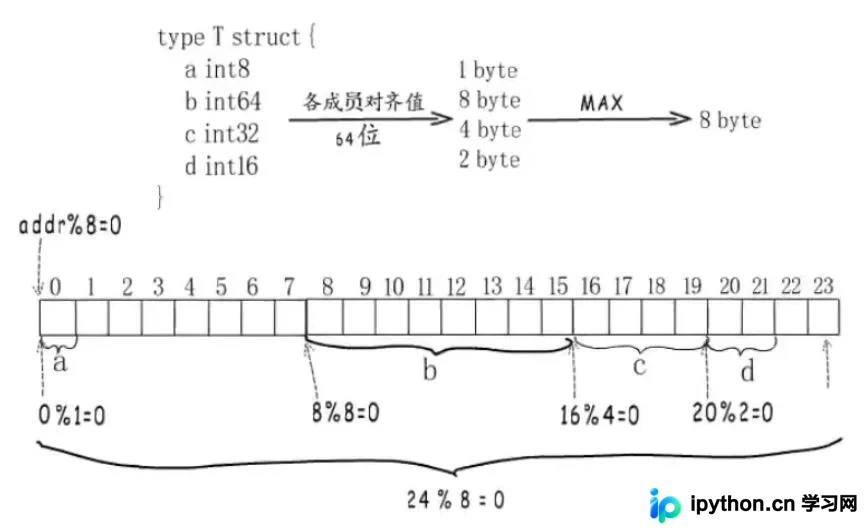
结构体整体的对齐边界,取决于其内部所有成员字段中对齐边界最大的那个字段值。例如,若结构体中包含一个 int64 成员(在 64 位平台上对齐值为 8),则整个结构体的对齐边界即为 8。
第二步:计算结构体的总内存占用
在确定了各成员的对齐边界后,分配内存时需同时满足以下两条硬性指标:
- 起始地址对齐:结构体实例分配的起始内存地址,必须是该结构体整体对齐边界的倍数。
- 总大小补齐:结构体内所有成员的偏移量加上最后一个成员的 size 之和,最后还需要进行一次填充(Padding)。这个最终的总大小,也必须是对齐边界的整数倍。若不满足,编译器会在末尾添加空白字节进行补齐。
通过字段排序优化内存占用
由于补齐机制的存在,结构体中字段的声明顺序会直接影响最终占用的内存大小。合理地将大块对齐的变量集中排列,可以消除中间产生的内存碎片(Padding),从而节省内存。
反例演示:
考虑以下结构体定义:
type Part1 struct {
	a bool    // size: 1, align: 1
	b int32   // size: 4, align: 4 -> 前面有 3 字节 padding
	c int8    // size: 1, align: 1
	d int64   // size: 8, align: 8 -> 前面有 7 字节 padding
	e byte    // size: 1, align: 1
}
让我们手动推算 Part1 的空间分布(假设从偏移量 0 开始):
a bool: 占第 0 字节,结束于 1。b int32: 起始地址必须是 4 的倍数,故跳过 1-3,从 4 开始,占 4 字节(4-7)。c int8: 占 1 字节(8)。d int64: 起始地址必须是 8 的倍数。当前已到 9,需填充至 16。占 8 字节(16-23)。e byte: 占 1 字节(24)。
目前已用 25 字节。但结构体最大对齐边界是 8(来自 d),所以总大小必须是 8 的倍数。从 25 补齐到下一个 8 的倍数,即 32 字节。
优化演示:
调整字段顺序,将对齐边界大的字段优先声明:
type Part2 struct {
	d int64   // size: 8, align: 8 -> 从 0 开始,占 8 字节 (0-7)
	b int32   // size: 4, align: 4 -> 从 8 开始,占 4 字节 (8-11)
	a bool    // size: 1, align: 1 -> 从 12 开始,占 1 字节 (12)
	c int8    // size: 1, align: 1 -> 从 13 开始,占 1 字节 (13)
	e byte    // size: 1, align: 1 -> 从 14 开始,占 1 字节 (14)
}
推算 Part2 的空间分布:
d int64: 0 - 7。b int32: 8 - 11。a bool,c int8,e byte: 12 - 14。
总共使用 15 字节。结构体最大对齐边界依然是 8,需要将总大小补齐至 8 的倍数,即 16 字节。
验证与总结
可以通过 unsafe.Sizeof 和 unsafe.Alignof 组合来验证这两个结构体的实际内存表现:
var part1 Part1
var part2 Part2
fmt.Printf("part1 size: %d, align: %d\n", unsafe.Sizeof(part1), unsafe.Alignof(part1))
fmt.Printf("part2 size: %d, align: %d\n", unsafe.Sizeof(part2), unsafe.Alignof(part2))
运行结果预期如下:
part1: 大小32,对齐8。part2: 大小16,对齐8。
可以看出,仅通过调整成员字段的书写顺序,Part2 就将内存占用压缩了一半。在高频调用或对内存敏感的场景下,这种优化具有实际意义。
补充知识点
sizeof:获取对象或类型所占的总字节数。offset:获取结构体字段相对于结构体起始地址的偏移量。alignof:获取对象或类型的内存对齐要求。
以上就是 Go 语言内存对齐的详细内容,更多关于 Go 语言结构体优化的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















