


C/C++指针与内存管理图文详解

C/C++编程的核心难点往往集中在指针与内存管理上,特别是在嵌入式或高性能开发场景中,对内存分布的误解容易导致性能瓶颈甚至程序崩溃。本文将结合图示,系统梳理内存分区模型、变量地址分配机制、多级指针逻辑以及数组在内存中的连续排列方式,旨在帮助开发者建立清晰的底层视图,写出高效且安全的代码。
一. C/C++内存架构与指针基础
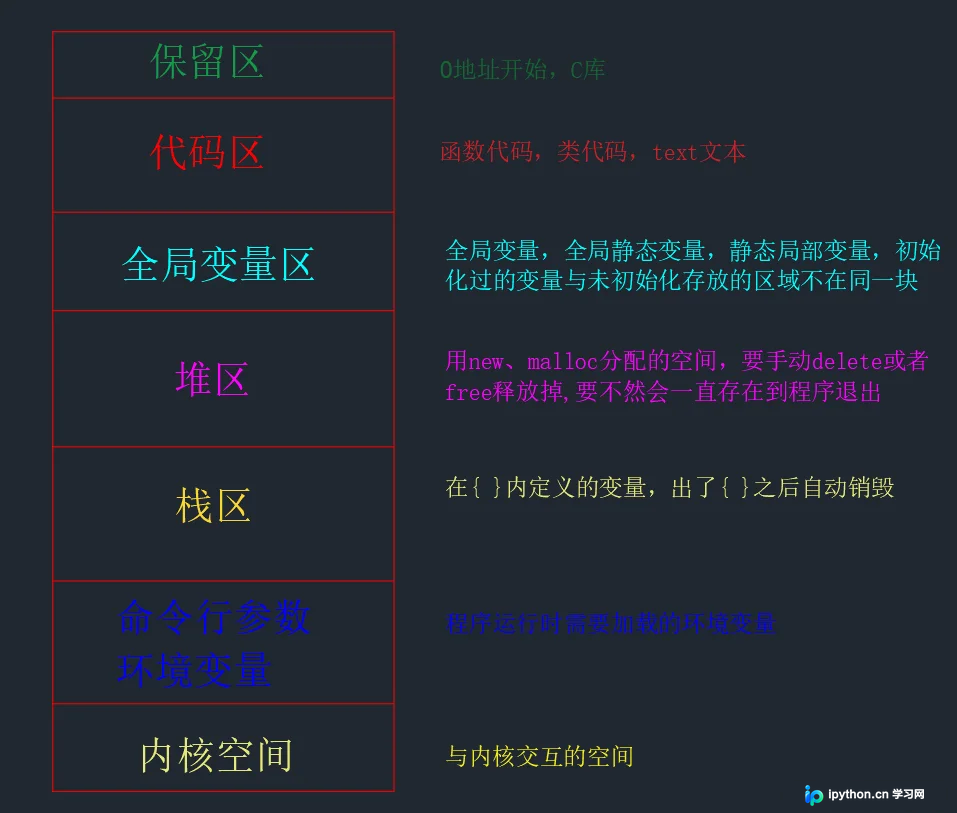
计算机内存被划分为多个功能区域,每个字节都有一个唯一的编号,即内存地址(Pointer Address)。对于普通应用程序而言,可读写的主要区域包括全局变量区、堆区和栈区。理解这些区域的布局是掌握指针的第一步。
以下是典型的内存分布示意图:
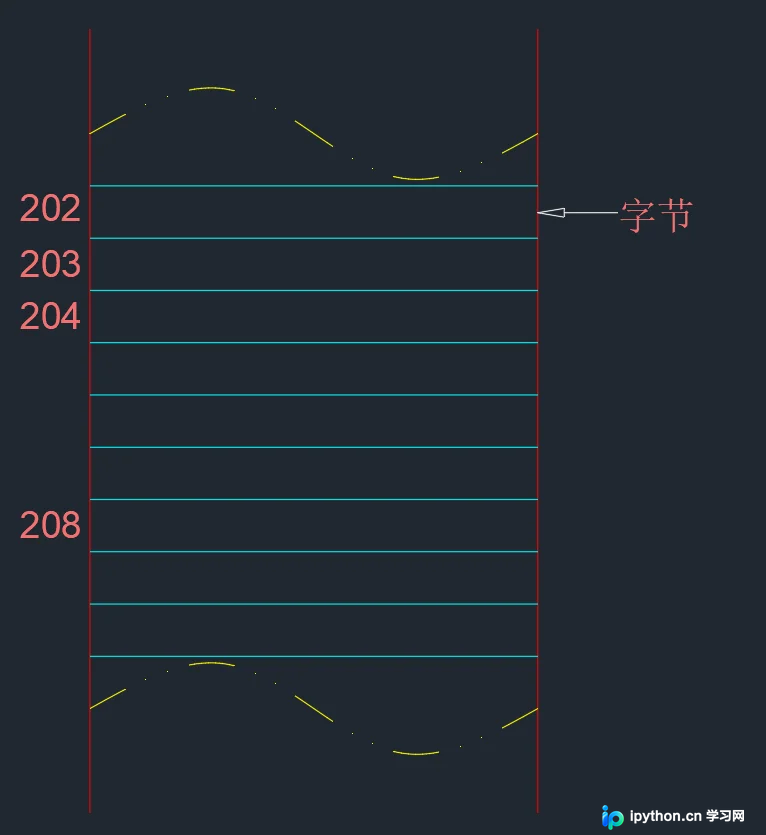
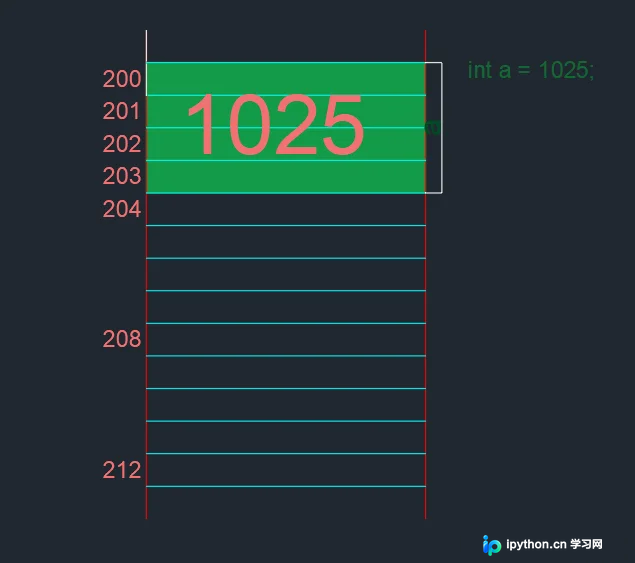
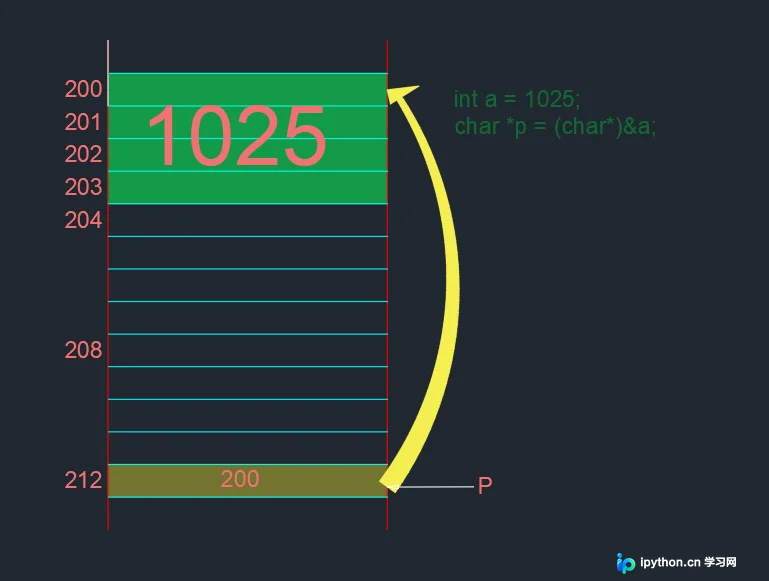
每个字节(Byte)对应的十六进制编号即为该字节的指针地址。例如,当定义一个整型变量 int a = 1025 时,在 x86 系统下,IDE 会在栈(Stack)中申请连续的 4 个字节来存放该数据。
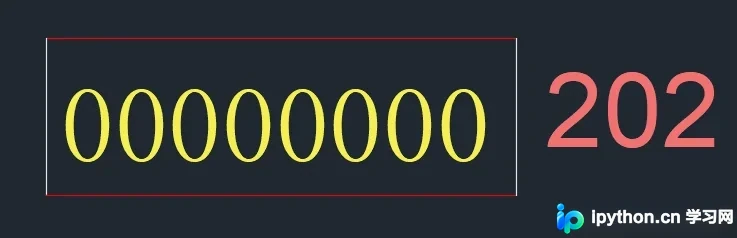
在 x86 架构中,1 个字节由 8 位(bit)组成,这是数据存储的最小单位基准。
这 4 个字节的起始地址就是变量 a 的地址,我们可以通过 &a 获取。使用 sizeof(int) 可以验证其占据的空间大小,通常也为 4 字节。
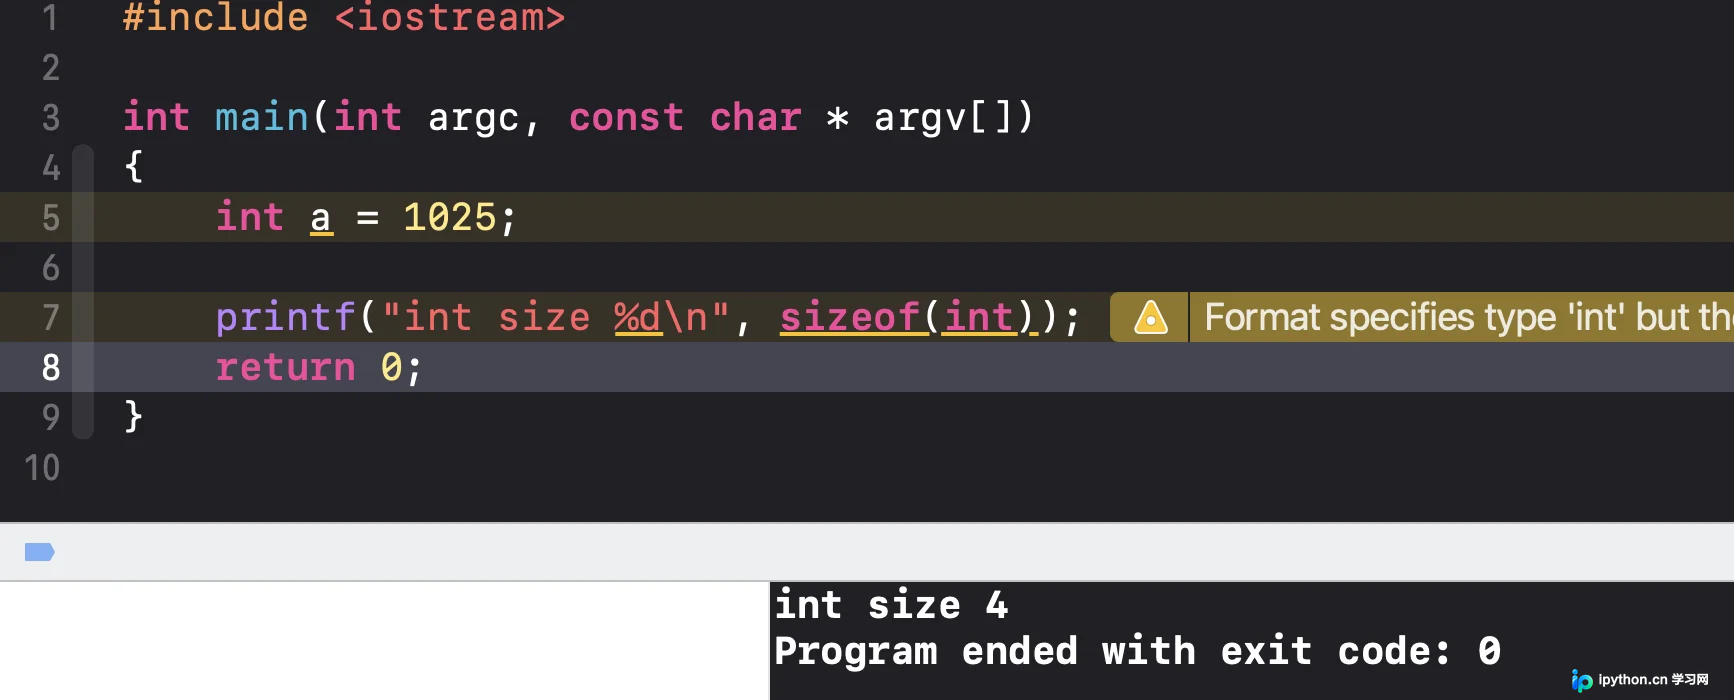
注意:不同平台整数类型的字节长度可能不同(如 ARM 或某些嵌入环境),建议始终使用 sizeof() 进行确认。
关于二进制与字节的对应关系,具体映射如下所示:
第1步:理解多级指针的指向逻辑
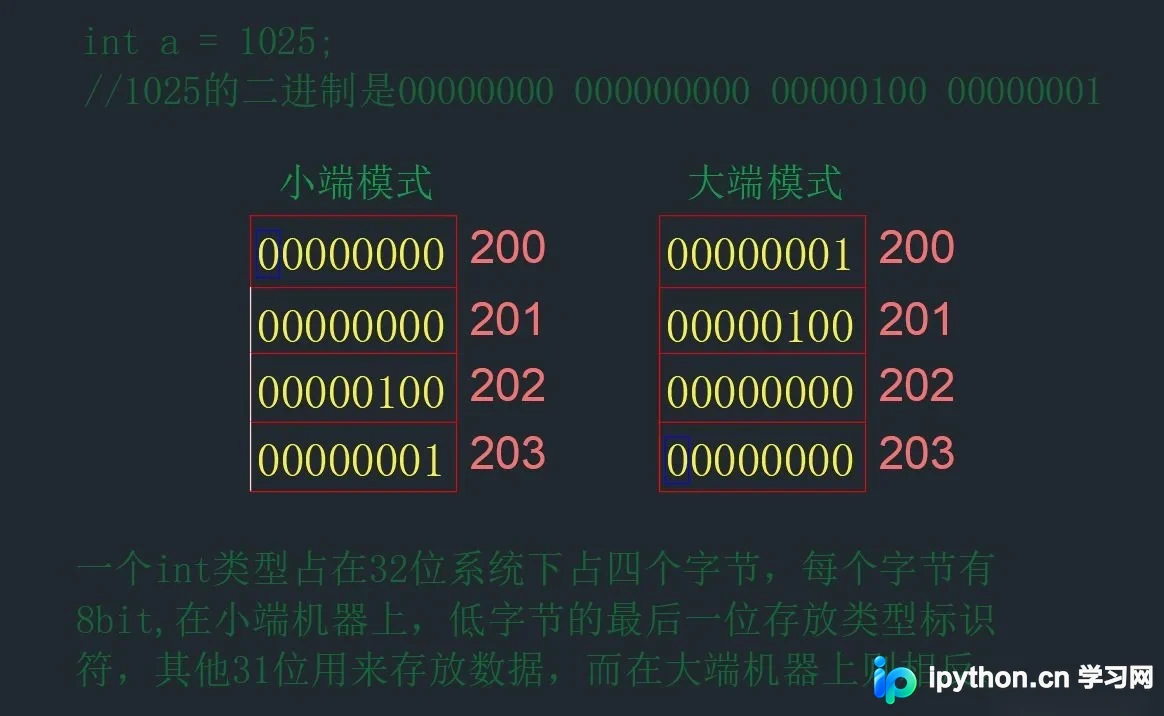
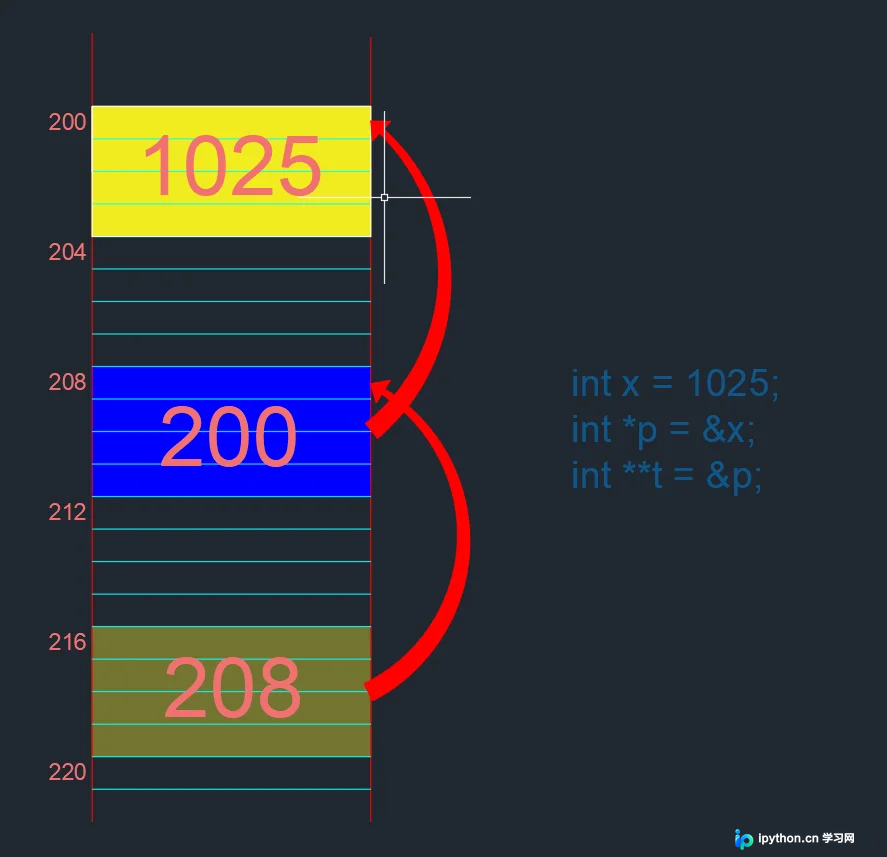
指针不仅可以指向变量,还可以指向另一个指针,形成“指向指针的指针”。例如:
p指向变量x,存储的是x的地址。t(即**t)指向指针p,存储的是p的地址。
这种间接寻址在链表、树结构及函数修改指针自身时非常关键。
第2步:区分静态区与堆区内存
除了栈和全局变量区,动态内存分配主要在堆(Heap)区进行。使用 new 关键字可以在堆中开辟一块自定义大小的内存空间,并返回其首地址给指针。
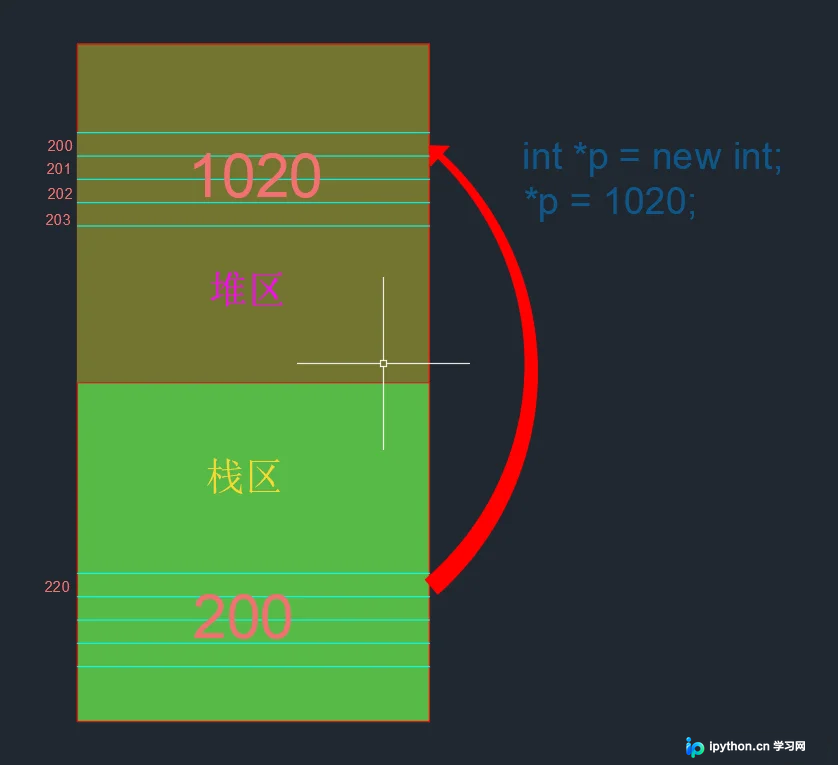
风险提示:堆内存由程序员手动管理,使用后必须调用 delete 释放,否则会导致内存泄漏。
二. 数组的内存表现
数组在内存中表现为连续分配的存储空间,但其底层细节在不同维度下有所差异。
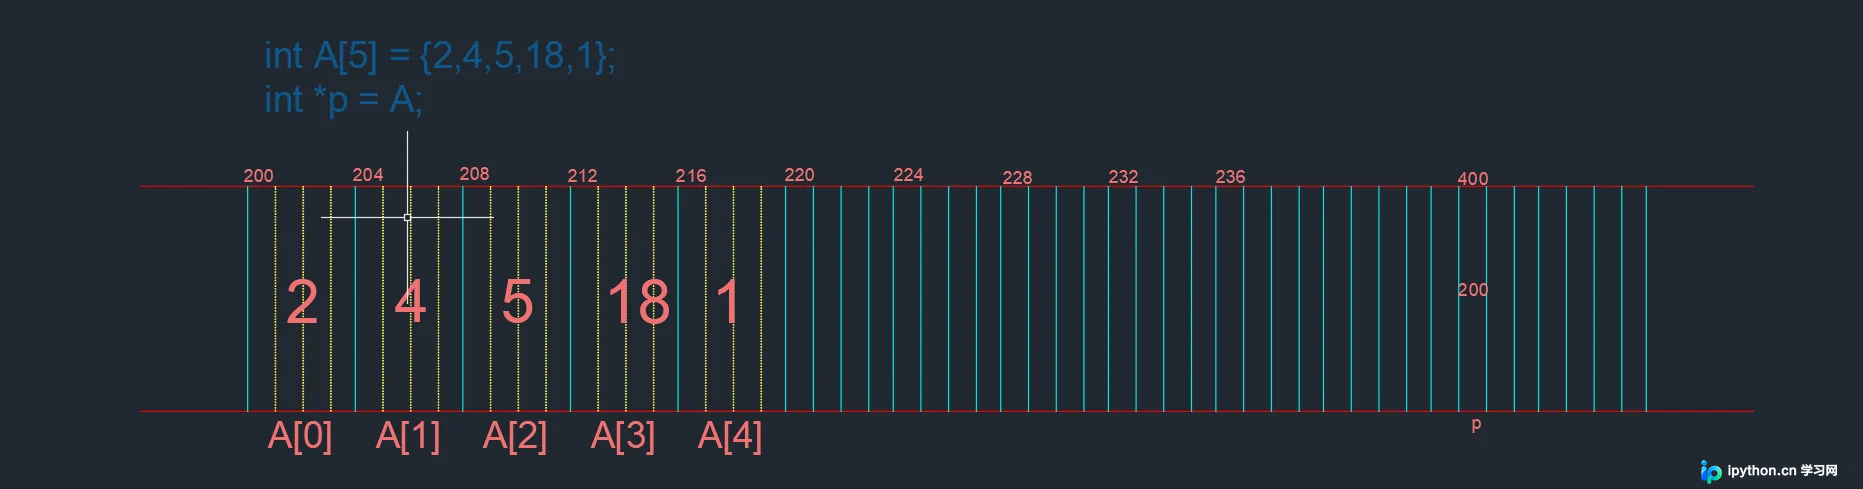
第1步:一维数组的连续存储
一维数组的每个元素按顺序紧密排列,arr[0] 到 arr[n-1] 的地址依次递增。数组名通常退化为指向首元素的指针。
第2步:字符数组的特殊性
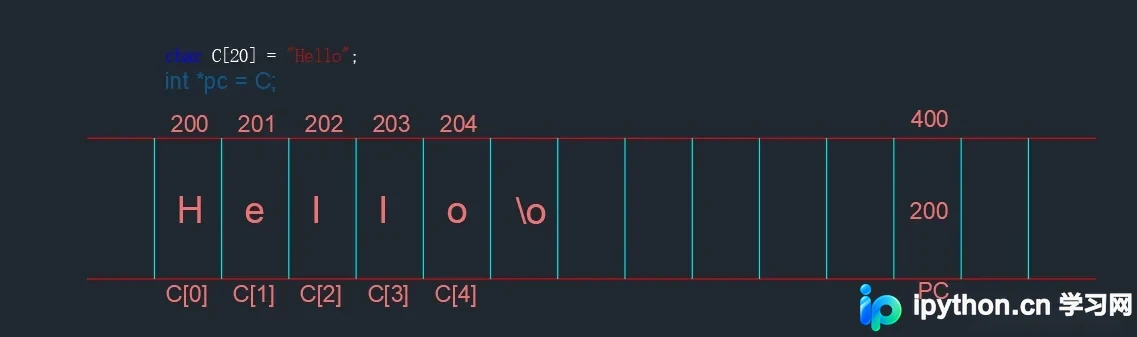
字符数组(char array)常用于字符串处理。需注意结尾符 '\0' 占用一个字节,计算长度时应包含它,但打印时不包含。
第3步:二维数组的内存布局
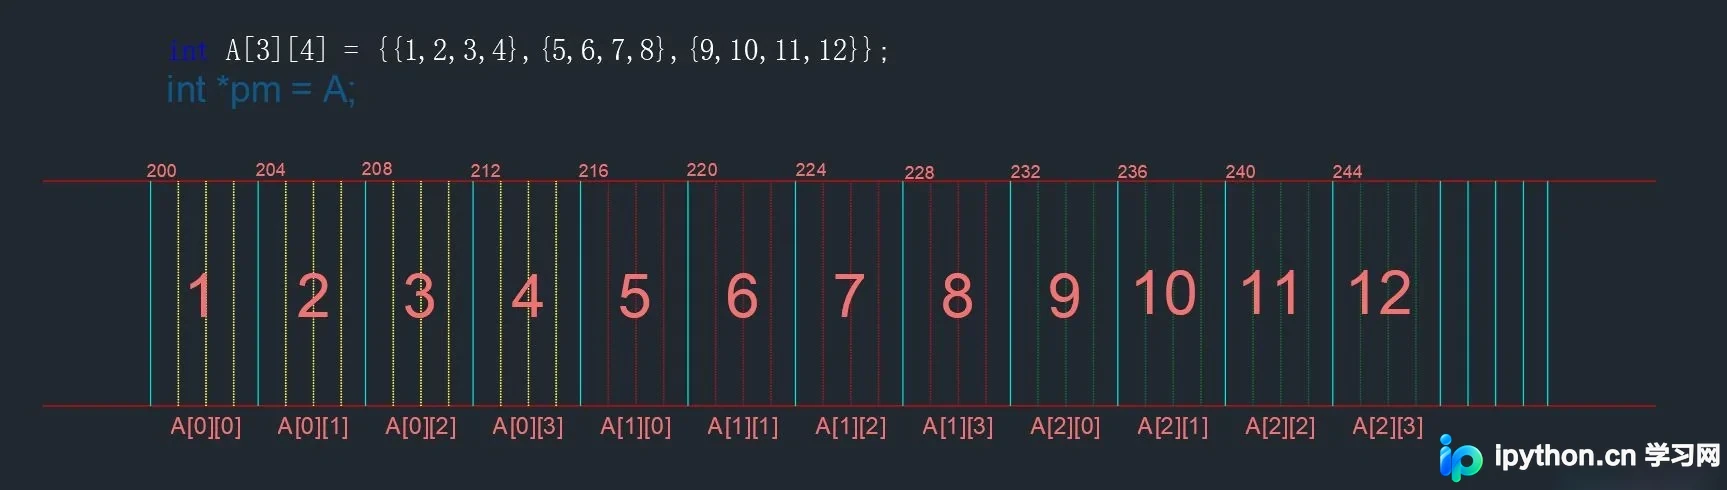
C/C++ 中的二维数组并非“数组的数组”,而是连续的一维内存块。访问 arr[i][j] 本质上是根据行偏移量和列偏移量计算出的线性地址。因此,逐行存储(Row-major order)有助于提高 CPU 缓存命中率。
以上就是C/C++指针与内存管理的详细内容,更多关于C++底层编程技巧的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















