


C语言10大经典排序算法原理与实现解析

C语言是数据结构的基石,掌握十大经典排序算法对于理解内存管理与效率优化至关重要。本文通过完整的C语言代码示例,深入解析冒泡、快速、堆等算法的运行机制,帮助开发者建立扎实的数据结构基础。
冒泡排序
冒泡排序通过重复遍历数组,比较相邻元素并交换位置,使较大的元素逐渐“浮”到末尾。它包含两种常见实现方式:迭代法与递归法。代码逻辑清晰,但时间复杂度较高,仅适合小规模数据。
// 采用两层循环实现的方法。
// 参数arr是待排序数组的首地址,len是数组元素的个数。
void bubblesort1(int *arr,unsigned int len)
{
  if (len<2) return; // 数组小于2个元素不需要排序。

  int ii;    // 排序的趟数的计数器。
  int jj;    // 每趟排序的元素位置计数器。
  int itmp;  // 比较两个元素大小时交换位置用到的临时变量。

  for (ii=len-1;ii>0;ii--)  // 一共进行len-1趟比较。
  {
    for (jj=0;jj<ii;jj++)  // 每趟只需要比较0......ii之间的元素,ii之后的元素是已经排序好的。
    {
      if (arr[jj]>arr[jj+1])  // 如果前面的元素大于后面的元素,则交换它位的位置。
      {
        itmp=arr[jj+1];
        arr[jj+1]=arr[jj];
        arr[jj]=itmp;
      }
    }
  }
}

int main(int argc,char *argv[])
{
  int arr[]={44,3,38,5,47,15,36,26,27,2,46,4,19,50,48};
  int len=sizeof(arr)/sizeof(int);

  bubblesort1(arr,len);

  // 显示排序结果。
  int ii;
  for (ii=0;ii<len;ii++) printf("%2d ",arr[ii]);

  printf("\n");
  return 0;
}
选择排序
选择排序每次从未排序部分选出最小(或最大)元素,将其放到已排序序列的末尾。虽然比冒泡排序减少了交换次数,但比较次数依然很多。下面展示了使用指针传递的 `swap` 辅助函数以及非递归实现。
// 选择排序
#include <stdlib.h>
#include <stdio.h>

// 交换两个变量的值。
void swap(int *x,int *y)
{
  int itmp=*x;
  *x=*y;
  *y=itmp;
}

// 采用两层循环实现的方法。
void selectsort1(int *arr,unsigned int len)
{
  if (len<2) return;

  int ii;      // 排序的趟数的计数器。
  int jj;      // 每趟排序的元素位置计数器。
  int iminpos; // 每趟循环选出的最小值的位置(数组的下标)。

  for (ii=0;ii<len-1;ii++)
  {
    iminpos=ii;

    for (jj=ii+1;jj<len;jj++)
    {
      if (arr[jj]<arr[iminpos])  iminpos=jj;
    }

    if (iminpos!=ii) swap(&arr[ii],&arr[iminpos]);
  }
}

int main(int argc,char *argv[])
{
  int arr[]={44,3,38,5,47,15,36,26,27,2,46,4,19,50,48};
  int len=sizeof(arr)/sizeof(int);

  selectsort1(arr,len);

  int ii; for (ii=0;ii<len;ii++) printf("%2d ",arr[ii]);
  printf("\n");
  return 0;
}
插入排序
插入排序将数组分为“已排序”和“未排序”两部分,每次从未排序区取出第一个元素,在已排序区从后向前扫描,找到合适位置后插入。这种排序方法在数据量较小且基本有序时效率极高。
// 插入排序
void insertsort(int *arr,unsigned int len)
{
  if (len<2) return;

  int itmp;  // 当前需要排序的元素的值。
  int ii;    // 需要排序元素的计数器。
  int jj;    // 插入排序时,需要后移元素的计数器。

  for (ii=1;ii<len;ii++)
  {
    itmp=arr[ii];    // 待排序元素

    for (jj=ii-1;jj>=0;jj--)
    {
      if (arr[jj]<=itmp) break;

      arr[jj+1]=arr[jj]; // 逐个元素后移。
    }

    arr[jj+1]=itmp; // 插入当前排序元素。
  }
}

int main(int argc,char *argv[])
{
  int arr[]={44,3,38,5,47,15,36,26,27,2,46,4,19,50,48};
  int len=sizeof(arr)/sizeof(int);

  insertsort(arr,len);

  int yy; for (yy=0;yy<len;yy++) printf("%2d ",arr[yy]); printf("\n");
  return 0;
}
希尔排序
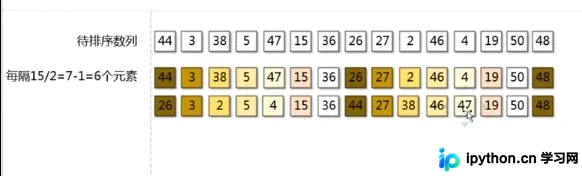
希尔排序是插入排序的高效改进版,通过将原始列表分割成多个子序列分别进行插入排序,从而减少大规模数据的移动次数。随着步长逐渐缩小至1,整个文件变得基本有序。
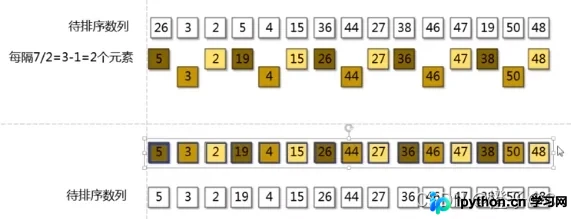
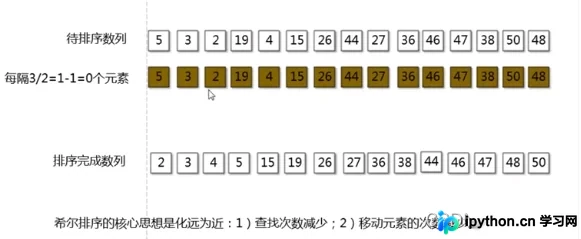
// 对希尔排序中的单个组进行排序。
void groupsort(int *arr, int len, int ipos,int istep)
{
  int itmp, ii, jj;

  for (ii=ipos+istep;ii<len;ii=ii+istep)
  {
    itmp=arr[ii];

    for (jj=ii-istep;jj>=0;jj=jj-istep)
    {
      if (arr[jj]<=itmp) break;
      arr[jj+istep]=arr[jj];
    }

    arr[jj+istep]=itmp;
  }
}

void shellsort(int *arr,unsigned int len)
{
  int ii,istep;

  for (istep=len/2;istep>0;istep=istep/2)
  {
    for (ii=0;ii<istep;ii++)
    {
      groupsort(arr,len,ii,istep);
    }
  }
}

int main(int argc,char *argv[])
{
  int arr[]={44,3,38,5,47,15,36,26,27,2,46,4,19,50,48};
  int len=sizeof(arr)/sizeof(int);

  shellsort(arr,len);
  int yy; for (yy=0;yy<len;yy++) printf("%2d ",arr[yy]); printf("\n");
  return 0;
}
快速排序
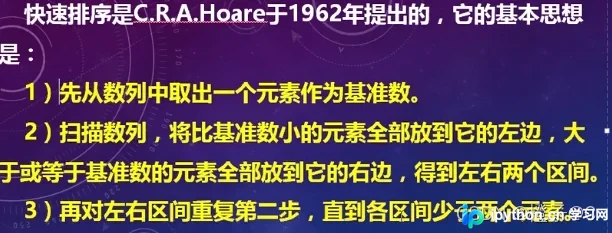
快速排序利用分治法,选取一个基准元素(pivot),将小于它的放左边,大于它的放右边,然后对左右两边递归排序。这是一种在实际应用中非常高效的排序算法。
void quicksort(int *arr,unsigned int len)
{
  if (len<2) return;

  int itmp=arr[0];
  int ileft=0, iright=len-1, imoving=2;

  while (ileft<iright)
  {
    if (imoving==2)
    {
      if (arr[iright]>=itmp) { iright--; continue; }
      arr[ileft]=arr[iright];
      ileft++; imoving=1; continue;
    }

    if (imoving==1)
    {
      if (arr[ileft]<=itmp) { ileft++; continue; }
      arr[iright]=arr[ileft];
      iright--; imoving=2; continue;
    }
  }

  arr[ileft]=itmp;
  quicksort(arr,ileft);
  quicksort(arr+ileft+1,len-ileft-1);
}

int main()
{
  int arr[]={44,3,38,5,47,15,36,26,27,2,46,4,19,50,48};
  int len=sizeof(arr)/sizeof(int);
  quicksort(arr,len);
  int yy; for (yy=0;yy<len;yy++) printf("%2d ",arr[yy]); printf("\n");
  return 0;
}
归并排序
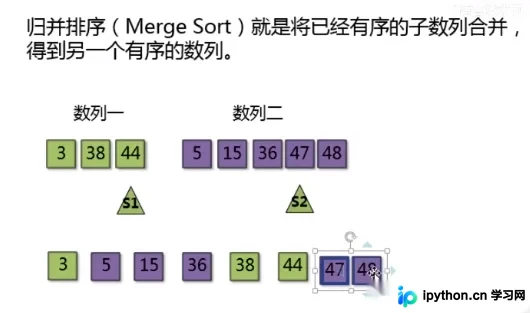
归并排序采用分治策略,将数组两两拆分直到无法再分,然后将有序的子序列合并。它具有稳定的性能表现,且可以使用循环方式避免递归开销。
// 采用递归的方法实现归并排序
#include <stdlib.h>
#include <stdio.h>
#include <string.h>

void _mergesort(int *arr,int *arrtmp,int start,int end)
{
  if (start>=end) return;

  int mid=start+(end-start)/2;
  int istart1=start,iend1=mid;
  int istart2=mid+1,iend2=end;

  _mergesort(arr,arrtmp,istart1,iend1);
  _mergesort(arr,arrtmp,istart2,iend2);

  int ii=start;
  while (istart1<=iend1 && istart2<=iend2)
    arrtmp[ii++]=arr[istart1]<arr[istart2] ? arr[istart1++] : arr[istart2++];

  while (istart1<=iend1) arrtmp[ii++]=arr[istart1++];
  while (istart2<=iend2) arrtmp[ii++]=arr[istart2++];

  memcpy(arr+start,arrtmp+start,(end-start+1)*sizeof(int));
}

void mergesort(int *arr,unsigned int len)
{
  if (len<2) return;
  int arrtmp[len];
  _mergesort(arr,arrtmp,0,len-1);
}

int main()
{
  int arr[]={44,3,38,5,47,15,36,26,27,2,46,4,19,50,48};
  int len=sizeof(arr)/sizeof(int);
  mergesort(arr,len);
  int yy; for (yy=0;yy<len;yy++) printf("%2d ",arr[yy]); printf("\n");
  return 0;
}
堆排序
堆排序利用二叉堆(通常是大顶堆)的特性,先将无序数组建成堆,然后反复将堆顶元素(最大值)与末尾元素交换,并对剩余部分重新调整为堆。它在空间复杂度上具有优势。
// 交换两个元素的值。
void swap(int *a,int *b) { int temp=*b; *b=*a; *a=temp; }

void heapify(int *arr,int start,int end)
{
  int dad=start;
  int son=dad*2+1;

  while (son<=end)
  {
    if ((son+1<=end) && (arr[son]<arr[son+1])) son++;

    if (arr[dad]>arr[son]) return;

    swap(&arr[dad],&arr[son]);
    dad=son;
    son=dad*2+1;
  }
}

void heapsort(int *arr, int len)
{
  int ii;
  for (ii=(len-1)/2;ii>=0;ii--) heapify(arr,ii,len-1);

  for (ii=len-1;ii>0;ii--)
  {
    swap(&arr[0],&arr[ii]);
    heapify(arr,0,ii-1);
  }
}

int main()
{
  int arr[]={44,3,38,5,47,15,36,26,27,2,46,4,19,50,48};
  int len=sizeof(arr)/sizeof(int);
  heapsort(arr,len);
  int yy; for (yy=0;yy<len;yy++) printf("%2d ",arr[yy]); printf("\n");
  return 0;
}
计数排序
计数排序假设输入数据都是小范围的整数,通过统计每个元素出现的次数来确定其排序位置。该方法速度极快,不受 $O(n \log n)$ 下限限制,但占用额外空间。
// 计数排序(基础版)
#include <stdio.h>
#include <stdlib.h>
#include <string.h>

int arrmax(int *arr,unsigned int len)
{
  int ii=0; int imax=0;
  for (ii=0;ii<len;ii++) if (imax<arr[ii]) imax=arr[ii];
  return imax;
}

void countsort(int *arr,unsigned int len)
{
  if (len<2) return;
  int imax=arrmax(arr,len);
  int arrtmp[imax+1];
  memset(arrtmp,0,sizeof(arrtmp));

  int ii,jj,kk;
  for (ii=0;ii<len;ii++) arrtmp[arr[ii]]++;

  ii=0;
  for (jj=0;jj<imax+1;jj++)
  {
    for (kk=0;kk<arrtmp[jj];kk++) arr[ii++]=jj;
  }
}

int main()
{
  int arr[]={2,3,8,7,1,2,2,2,7,3,9,8,2,1,4,2,4,6,9,2};
  int len=sizeof(arr)/sizeof(int);
  countsort(arr,len);
  int yy; for (yy=0;yy<len;yy++) printf("%2d ",arr[yy]); printf("\n");
  return 0;
}
桶排序
桶排序假设数据均匀分布在已知范围内,将数据分到有限数量的“桶”里,每个桶再单独排序(常用其他内部排序)。最后将所有桶中的数据合并。
void bucketsort(int *arr,unsigned int len)
{
  int buckets[5][5];   // 分配五个桶。
  int bucketssize[5];  // 每个桶中元素个数的计数器。

  memset(buckets,0,sizeof(buckets));
  memset(bucketssize,0,sizeof(bucketssize));

  int ii=0;
  for (ii=0;ii<len;ii++)
  {
    buckets[arr[ii]/10][bucketssize[arr[ii]/10]++]=arr[ii];
  }

  for (ii=0;ii<5;ii++)
  {
    // 此处借用之前定义的冒泡排序函数处理桶内数据
    // 注意实际使用中需包含正确的bubblesort定义
    bubblesort(buckets[ii],bucketssize[ii]);
  }

  int jj=0,kk=0;
  for (ii=0;ii<5;ii++)
  {
    for (jj=0;jj<bucketssize[ii];jj++)
      arr[kk++]=buckets[ii][jj];
  }
}

int main(int argc,char *argv[])
{
  int arr[]={21,3,30,44,15,36,6,10,9,19,25,48,5,23,47};
  int len=sizeof(arr)/sizeof(int);
  bucketsort(arr,len);
  int ii; for (ii=0;ii<len;ii++) printf("%2d ",arr[ii]); printf("\n");
  return 0;
}
基数排序
基数排序根据位数的优先级,从最低位(个位)到最高位依次对数据进行排序。它通常结合计数排序来保证稳定性,适合位数确定的数字序列。
#include <stdlib.h>
#include <stdio.h>
#include <string.h>

int arrmax(int *arr,unsigned int len)
{
  int ii,imax;
  imax=arr[0];
  for (ii=1;ii<len;ii++) if (arr[ii]>imax) imax=arr[ii];
  return imax;
}

void _radixsort(int *arr,unsigned int len,unsigned int exp)
{
  int ii;
  int result[len];
  int buckets[10]={0};

  for (ii=0;ii<len;ii++)
    buckets[(arr[ii]/exp)%10]++;

  for (ii=1;ii<10;ii++)
    buckets[ii]=buckets[ii]+buckets[ii-1];

  for (ii=len-1;ii>=0;ii--)
  {
    int iexp=(arr[ii]/exp)%10;
    result[buckets[iexp]-1]=arr[ii];
    buckets[iexp]--;
  }

  memcpy(arr,result,len*sizeof(int));
}

void radixsort(int *arr,unsigned int len)
{
  int imax=arrmax(arr,len);
  int iexp;

  for (iexp=1;imax/iexp>0;iexp=iexp*10)
  {
    _radixsort(arr,len,iexp);
  }
}

int main(int argc,char *argv[])
{
  int arr[]={144,203,738,905,347,215,836,26,527,602,946,504,219,750,848};
  int len=sizeof(arr)/sizeof(int);

  radixsort(arr,len);
  int yy; for (yy=0;yy<len;yy++) printf("%2d ",arr[yy]); printf("\n");
  return 0;
}本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















