


Python 序列化与反序列化详解:json 与 pickle 模块实战

在 Python 文件操作中,原生读写仅支持字符串或字节流,复杂数据结构需借助序列化与反序列化才能稳定落盘。本文系统梳理该技术的实现路径,对比 json 与 pickle 模块的转换差异,并提供可直接复用的文件读写代码与常见类型映射对照表。
理解数据结构与文本/字节流的转换规则
第1步:明确可序列化与不可序列化数据类型
目的:避免调用转换函数时触发类型异常。
入口:业务代码逻辑层。
动作:评估待存储或传输的数据结构。支持序列化的基础类型包括 number(数字)、str(字符串)、list(列表)、tuple(元组)和 dict(字典)。其中字典是最常用的 JSON 容器结构。不支持的类型包括 class(类)、def(函数)以及 set(集合),这些类型无法直接转换为符合 RFC 标准的文本或字节流。
重要参数:无。
可观察的完成状态:数据结构校验通过,即可进入具体的模块调用环节。
第2步:使用 json 模块执行通用字符串转换
目的:实现跨编程语言的数据互通与持久化。
入口:Python 标准库环境。
动作:导入内置模块后,调用 dumps() 将 Python 对象转为规范字符串,调用 loads() 将合法字符串还原为对应对象。两者共同构成通用的序列化链路。
| 方法名 | 参数 | 功能 | 示例 | 返回值 |
|---|---|---|---|---|
| dumps | obj | 对象序列化 | json.dumps([1, 2, 3]) | 字符串 |
| loads | str | 字符串反序列化 | json.loads('[1, 2, 3]') | 原始数据类型 |
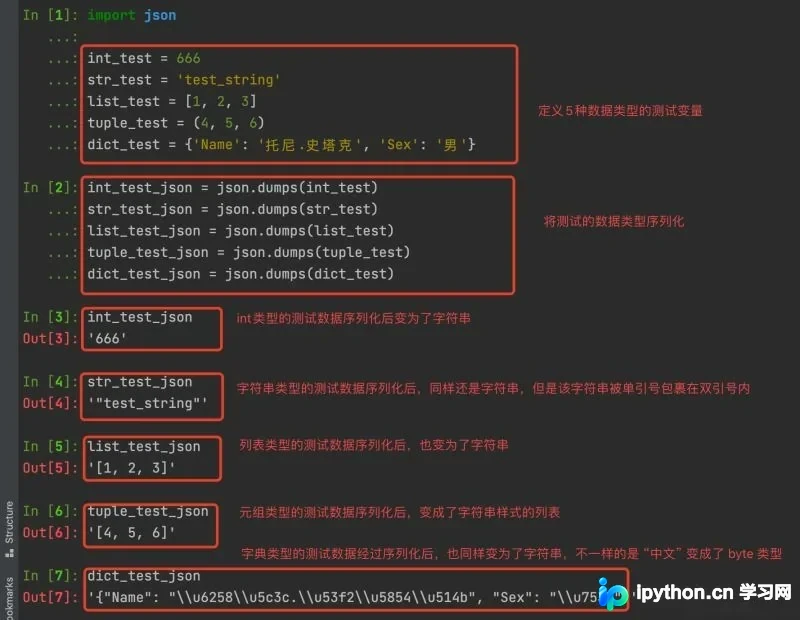
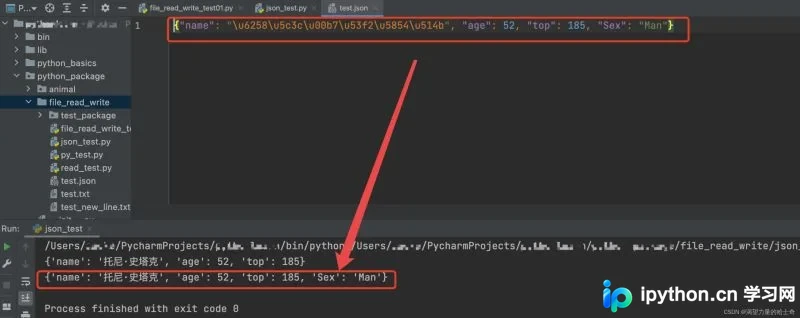
字典在序列化后会统一将内部单引号替换为双引号,中文字符按 Unicode 编码转义。这正是 .json 文件格式的标准形态。若需要将转换结果恢复为原始结构,直接传入 loads() 即可:
_int_test = json.loads(int_test_json)
_str_test = json.loads(str_test_json)
_list_test = json.loads(list_test_json)
_tuple_test = json.loads(tuple_test_json)
_dict_test = json.loads(dict_test_json)
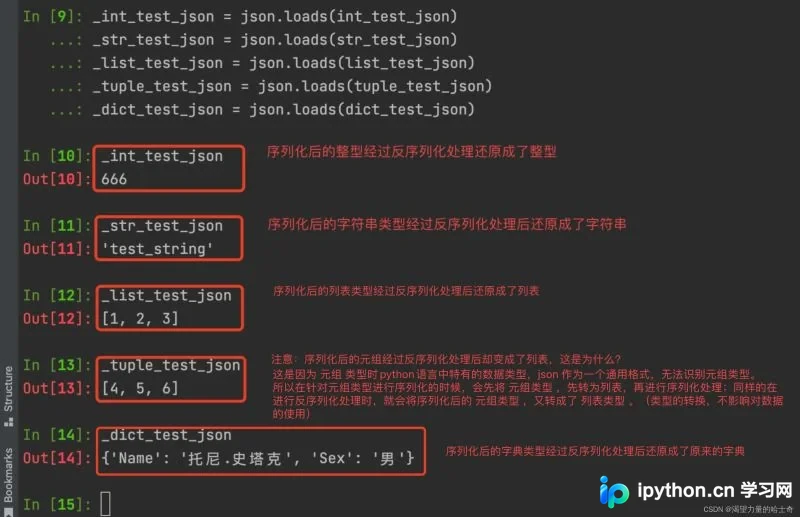
注意:元组在经历 json 序列化再反序列化全流程后,会固定变为列表。这是由于元组属于 Python 独有结构,json 标准不识别元组标识,转换期间会自动降级为列表,数据内容不受影响。
第3步:切换 pickle 模块处理 Python 专属二进制流
目的:在纯 Python 环境中提升序列化效率并支持更复杂的对象类型。
入口:导入 pickle 标准库。
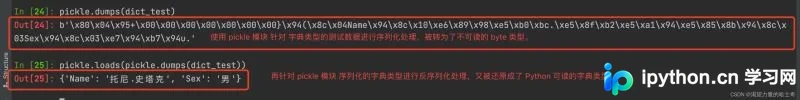
动作:与 json 类似使用 dumps() 和 loads(),但 pickle 采用二进制协议。其 dumps() 返回 bytes 类型结果,loads() 同样严格接收 bytes 参数进行逆向解析。
| 方法名 | 参数 | 功能 | 示例 | 返回值 |
|---|---|---|---|---|
| dumps | obj | 对象序列化 | pickle.dumps({'key': 'val'}) | bytes 字节流 |
| loads | bytes | 字节流反序列化 | pickle.loads(serialized_bytes) | 原始数据类型 |
当仅需在 Python 生态内传递对象时,pickle 能保留更完整的数据特征且性能优于 json。
JSON 文件读写实战流程
⚠️ 风险提醒:涉及文件覆写操作前,请务必备份原数据文件或使用测试目录,防止意外清除有效配置。
第4步:构建安全的读写封装逻辑
目的:规范数据落盘流程,解决类型校验与编码转换问题。
入口:定义自定义函数。
动作:打开指定路径文件,使用 isinstance() 拦截非字典数据抛出异常;通过 json.dumps() 预处理数据并写入;读取时配合 open('r') 获取文本后交由 json.loads() 还原。完整操作代码如下:
# coding:utf-8
import json

data = {'name': '托尼·史塔克', 'age': 52, 'top': 185}

def read(path):
    with open(path, 'r') as f:
        raw_text = f.read()
    return json.loads(raw_text)

def write(path, data):
    with open(path, 'w') as f:
        if isinstance(data, dict):
            _data = json.dumps(data)
            f.write(_data)
        else:
            raise TypeError("'data' 不是一个字典类型的数据")
    return True

if __name__ == '__main__':
    write('test.json', data)
    result = read('test.json')
    print(result)
    result['Sex'] = 'Man'
    write('test.json', result)
    result_test_json = read('test.json')
    print(result_test_json)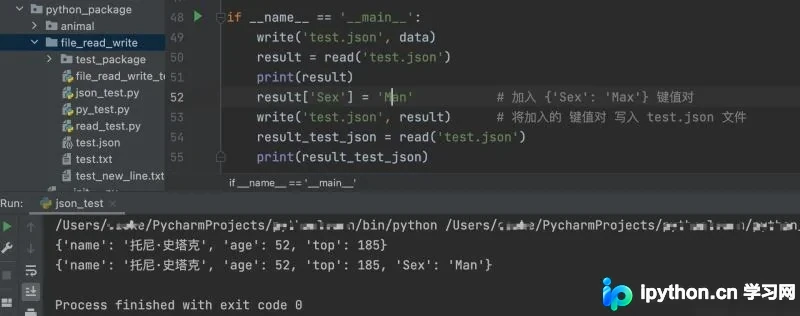
关键排错与使用建议
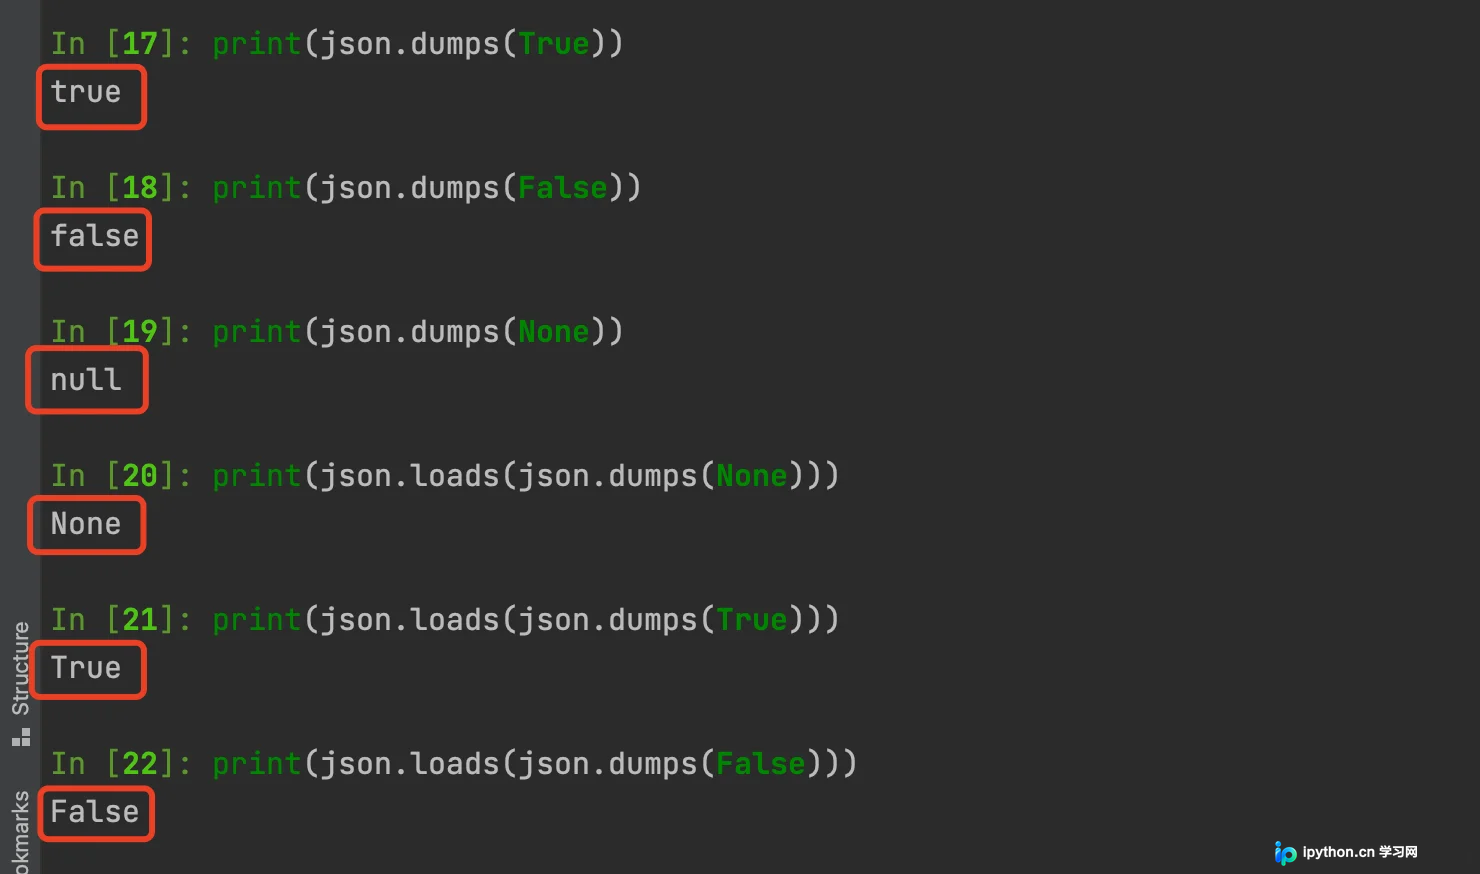
- 类型降级现象:JSON 标准不支持元组与 Python 独有的扩展对象,序列化后恢复为列表属正常行为,业务端可通过
tuple()二次转换恢复。 - 布尔与空值映射:True/False/None 在 JSON 协议中固定映射为小写 true/false/null 字符串,反序列化时自动还原为 Python 原生对象,无需手动干预。
- Pickle 安全性:pickle 可反序列化任意 Python 对象,请勿对来源不明的字节流调用
loads(),以防恶意代码执行风险。
总结
掌握序列化与反序列化是打通内存数据与磁盘存储的关键。日常跨平台数据交换首选 json 模块,确保兼容性与可读性;纯 Python 环境追求极致性能或传递自定义对象时,可合理使用 pickle 模块。搭配规范的读写封装与类型校验,即可构建稳健的数据持久化方案。以上就是 Python 序列化与反序列化详细内容的介绍,更多关于 Python 文件操作与数据处理资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















