


C++函数重载详解:定义、规则与底层实现原理

C++中的函数重载允许在同一作用域内使用相同函数名但不同参数列表的多个函数,极大提升了代码的可读性与复用性。本文将从具体代码示例出发,明确函数重载的判断规则,并深入探讨其底层机制:编译器如何通过生成唯一的内部名称来解决命名冲突,解释为何C语言无法原生支持这一特性。
引例:统一接口的便捷性
在实际开发中,我们常需要针对不同类型的数据执行相似的操作,例如打印输出。如果仅依赖字符串和整型分开命名的函数(如 print_s 和 print_i),不仅代码冗余,也增加了记忆负担。C++提供了更优雅的解决方案:通过函数重载,可以使用同一个 print 函数名处理不同类型参数。
void print(int i)
{
    cout << "print a integer :" << i << endl;
}

void print(string str)
{
    cout << "print a string :" << str << endl;
}

int main()
{
    // 自动匹配 int 类型的重载版本
    print(12);
    // 自动匹配 string 类型的重载版本
    print("hello world!");
    return 0;
}
上述代码展示了编译器如何根据传入参数的类型,自动选择调用正确的函数实现。这不仅简化了 API 设计,也使得调用逻辑更加直观。
函数重载的定义
函数重载是指在同一作用域内,存在一组具有相同函数名、但参数列表不同的函数。这些函数被称为重载函数。合理使用重载可以减少函数名的数量,避免名字空间的污染,显著提升程序的可读性和可维护性。
函数重载的核心规则
判断两个函数是否构成重载关系,必须满足以下严格条件。只要其中一个条件成立,即可视为重载:
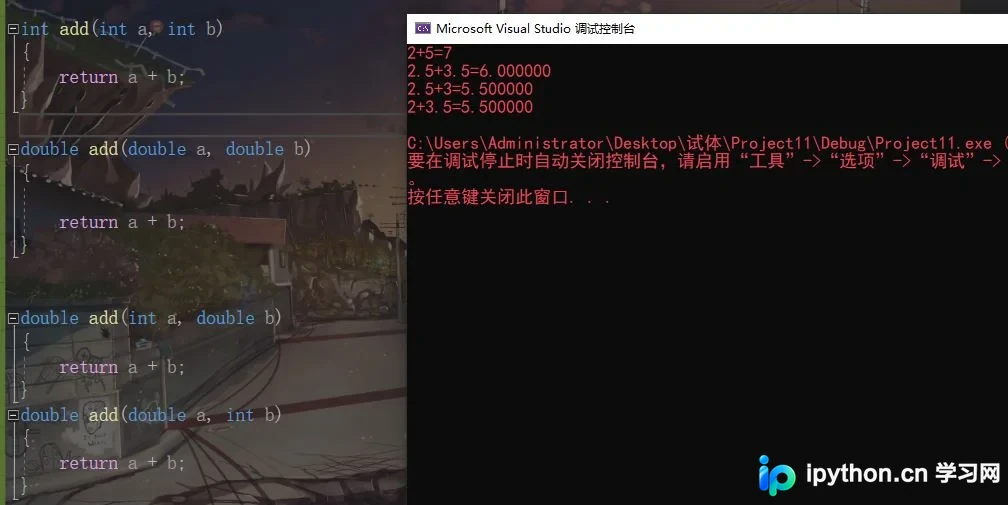
- 参数个数不同:例如一个函数接收1个参数,另一个接收2个参数。
- 参数类型不同:即使参数个数相同,若类型不一致(如
int与float),则构成重载。 - 参数顺序不同:若参数类型组合不同且位置交换(如
(int, float)与(float, int)),同样构成重载。
需要注意的是,返回值类型不参与重载的判断。仅当返回值不同而参数完全相同时,编译会报错。
为什么C++支持而C不支持?
要理解函数重载的底层逻辑,必须解决一个核心问题:函数命名冲突。
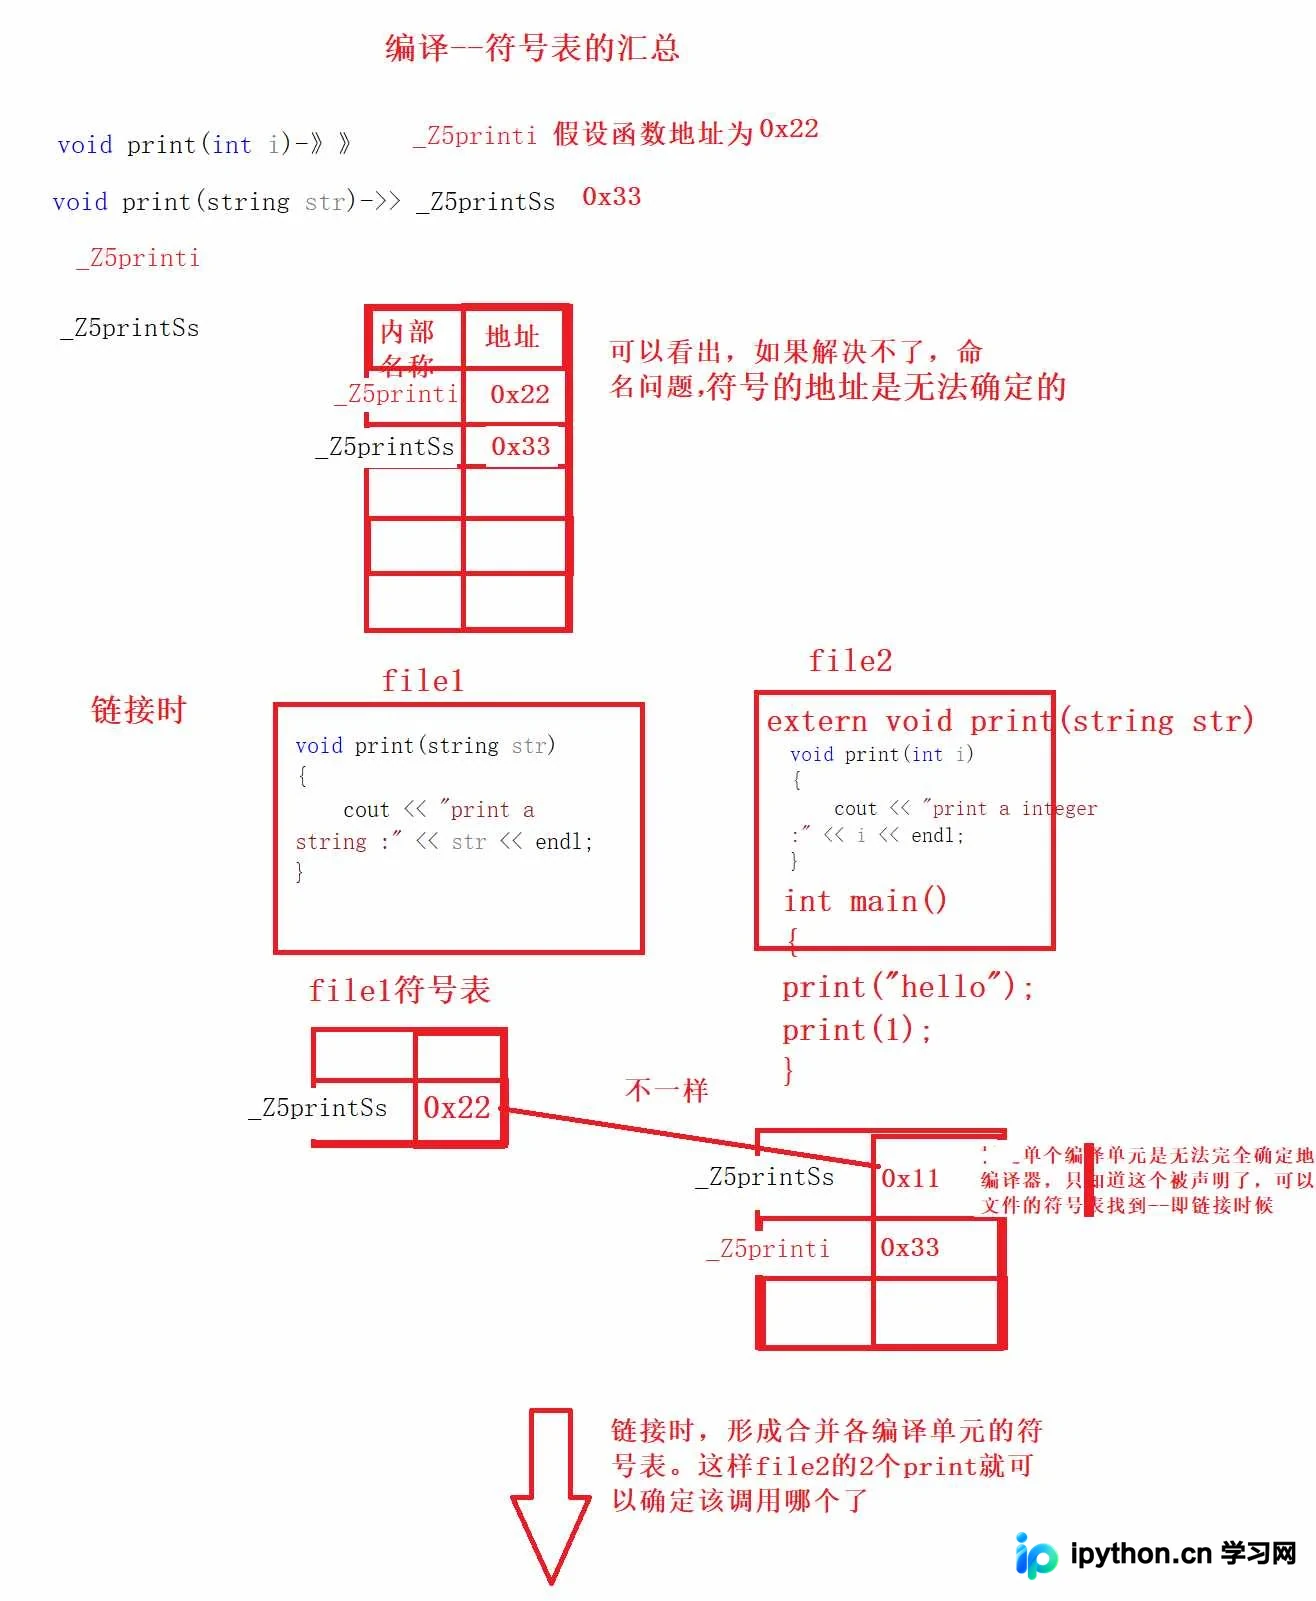
在编译过程中,源代码中的标识符(函数名、变量名等)会被转换为内存中的唯一标识,即“内部名称”(Internal Name)。随后,编译器构建符号表,链接器依据符号表确定程序的最终调用关系。
如果不解决命名唯一性问题,当不同文件中出现同名函数时,链接阶段将无法区分,导致程序崩溃(Crash)。C语言与C++在处理这一问题的机制上存在本质差异。
内部名称的生成机制
内部名称是语言实现中用于唯一识别变量、函数、类型及命名空间的技术手段。编译器将用户定义的简洁标识符,按照特定规则转换为复杂的内部名称,以便进行精确识别。
1. C语言的简单前缀规则
在C语言中,为了保持兼容性,通常仅在标识符前添加前缀以区分内部名称。例如,函数 swap() 可能被转换为 _swap()。这种简单的处理方式无法承载额外的类型信息:一旦在不同文件中使用相同的函数名,程序就会因符号重复定义而崩溃。因此,C语言原生不支持函数重载。
2. C++的名称修饰(Name Mangling)
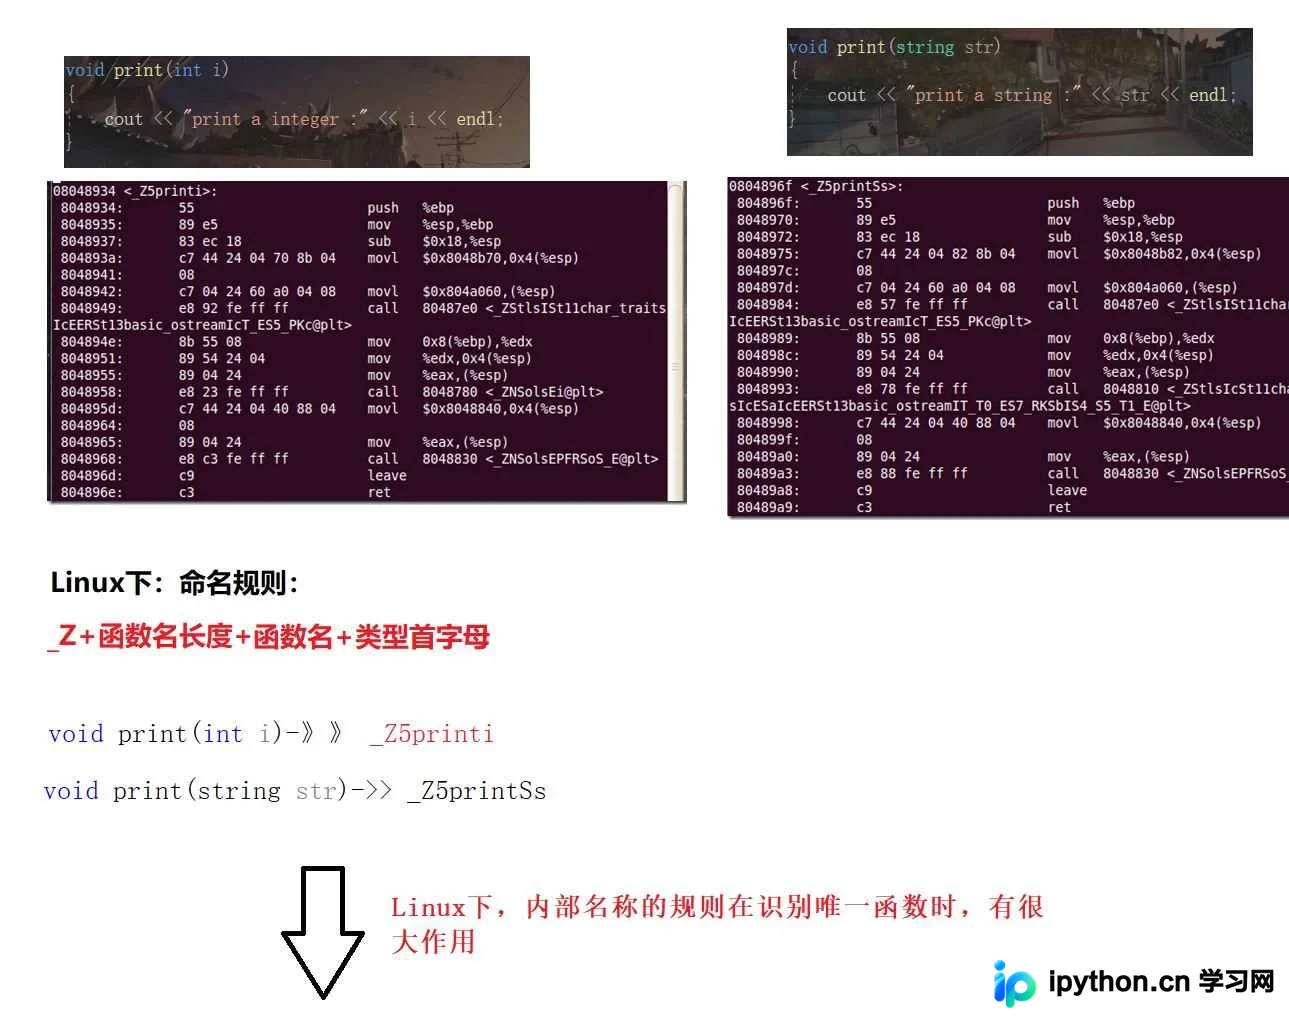
C++引入了更为复杂的名称修饰机制。不同编译器对内部名称的处理方式略有差异,但核心逻辑一致:将函数名与参数类型信息混合编码,生成全局唯一的内部名称。
LINUX环境下:
Windows环境下:
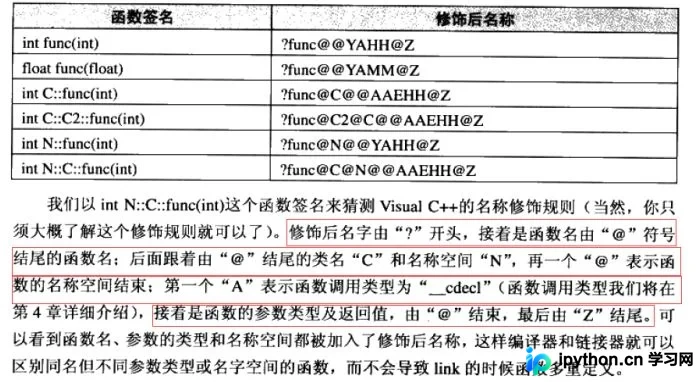
正是通过这种包含类型信息的内部命名规则,编译器能够在链接阶段准确区分名为 print 但接收不同参数的函数,从而使函数重载成为可能。
总结
C++函数重载通过“同名异参”简化了API设计,其底层依赖于编译器生成的唯一内部名称来解决命名冲突。理解这一机制有助于更深入地掌握C++的类型系统与编译链接流程。以上就是关于C++函数重载的详细解析,更多关于C++基础技术的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















